speech_attempt_pronunciation_analysis
收藏资源简介:
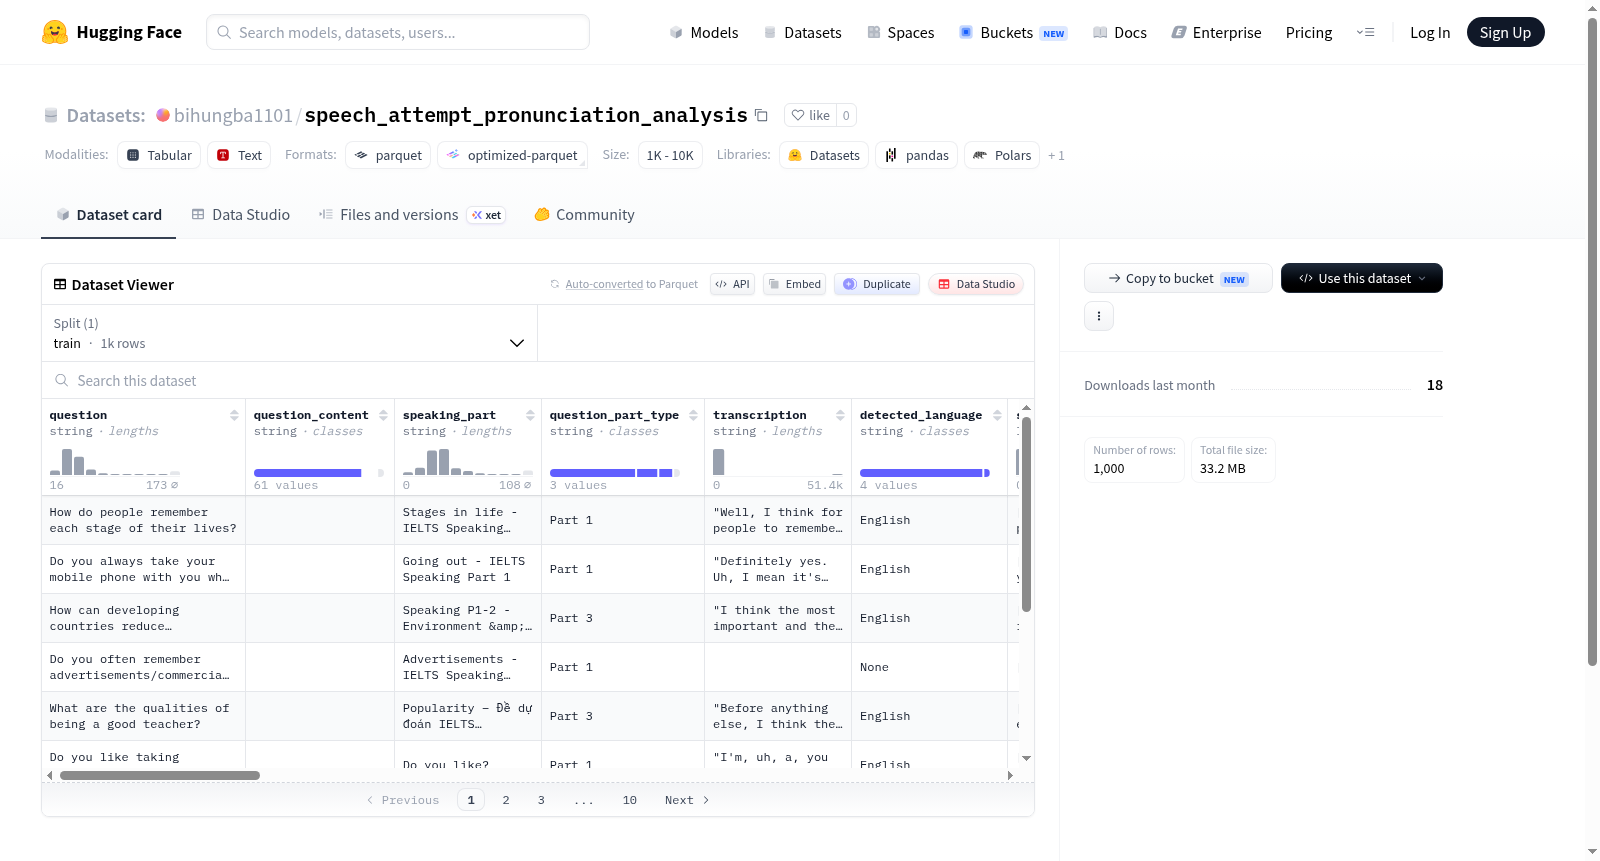
该数据集名为speech_attempt_pronunciation_analysis,是一个用于语音发音分析的数据集。数据集包含1000个训练样本,总大小约为268MB。每个样本包含丰富的多模态信息,具体字段包括:问题文本(question, question_content)、口语部分标识(speaking_part, question_part_type)、音频转录文本(transcription)、检测到的语言(detected_language)、句子列表(sentences)、数据来源信息(source_dataset, source_split, source_index, record_id)、参考文本信息(reference_field, reference_type, reference_text)、音频处理元数据(triton_model_name, audio_num_samples, audio_sampling_rate, audio_duration_seconds, processing_error)以及详细的发音和语言能力评估指标,如发音评分(pronunciation_score)、IELTS分数(ielts_score)、效率百分比(eff_per)、清晰度/模糊度/破碎度比率(r_clear, r_blurred, r_broken)、词汇和音素计数(word_count, phoneme_count)以及结构化评估数据(assessment_json, fluency_xml)。数据集适用于语音发音评估、口语流利度分析、语言能力测试(如IELTS)等相关任务的研究与开发。
数据集概述
数据集名称:speech_attempt_pronunciation_analysis
数据集来源:Hugging Face Datasets(地址:https://huggingface.co/datasets/bihungba1101/speech_attempt_pronunciation_analysis)
数据集规模:
- 训练集(train):包含 1000 个样本,总字节数约为 268.68 MB
- 下载大小:约 33.16 MB
特征字段说明:
| 字段名 | 数据类型 | 描述 |
|---|---|---|
| question | string | 问题文本 |
| question_content | string | 问题内容 |
| speaking_part | string | 发言部分 |
| question_part_type | string | 问题部分类型 |
| transcription | string | 语音转写文本 |
| detected_language | string | 检测到的语言 |
| sentences | list of string | 句子列表 |
| source_dataset | string | 来源数据集 |
| source_split | string | 来源数据集划分 |
| source_index | int64 | 来源数据索引 |
| record_id | string | 记录 ID |
| reference_field | string | 参考字段 |
| reference_type | string | 参考类型 |
| reference_text | string | 参考文本 |
| triton_model_name | string | Triton 模型名称 |
| audio_num_samples | int64 | 音频样本数 |
| audio_sampling_rate | int64 | 音频采样率 |
| audio_duration_seconds | float64 | 音频时长(秒) |
| processing_error | string | 处理错误信息 |
| pronunciation_score | float64 | 发音评分 |
| ielts_score | float64 | 雅思得分 |
| eff_per | float64 | EFF 表现 |
| r_broken | float64 | 破裂音评分 |
| r_blurred | float64 | 模糊音评分 |
| r_clear | float64 | 清晰音评分 |
| word_count | int64 | 单词数量 |
| phoneme_count | int64 | 音素数量 |
| assessment_json | string | 评估 JSON 数据 |
| fluency_xml | string | 流利度 XML 数据 |
数据集用途:该数据集主要用于语音发音分析,包含转录文本、发音评分、雅思得分、流利度评估等多维度信息,适用于语音识别、发音评估、口语能力分析等任务。
配置信息:
- 配置名称:default
- 数据文件路径:
data/train-*