
news-categories
收藏官方服务:
资源简介:
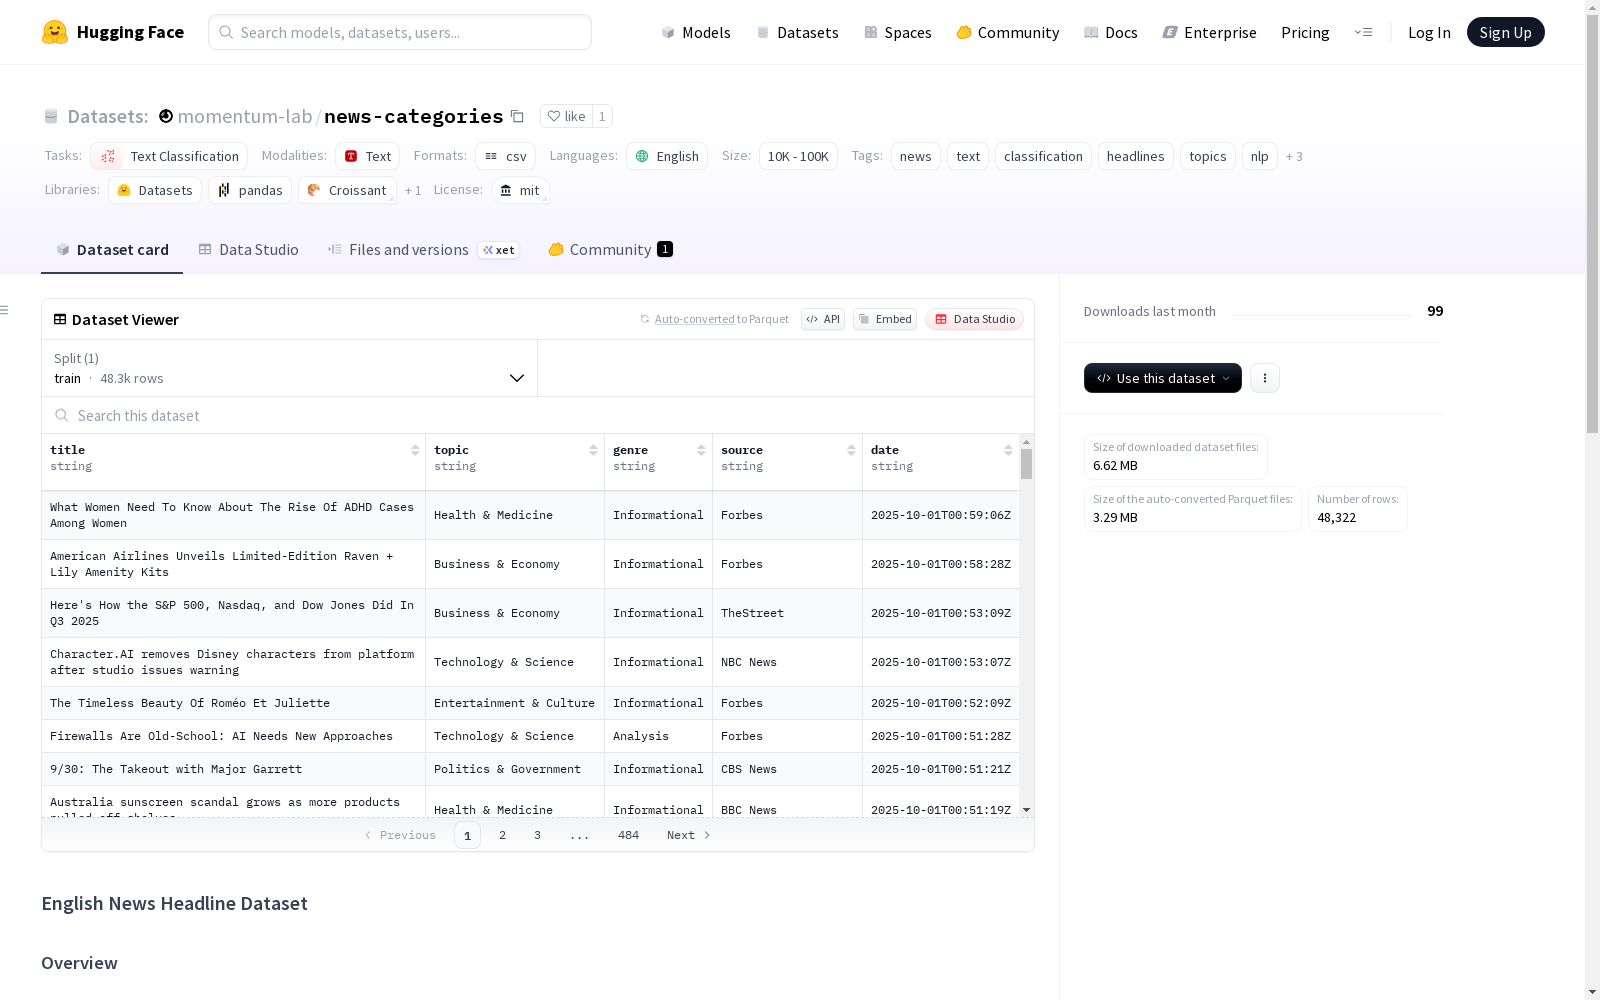
这是一个包含35,000个英文新闻标题的数据集,这些标题被分为10个主题类别,用于文本分类和自然语言处理研究,如新闻主题建模、迁移学习和零样本评估。每个记录包括新闻标题文本、十个预设类别中的一个主题、四种预设故事风格描述符之一、媒体来源名称和发布时间戳。
This is a dataset containing 35,000 English news headlines, which are categorized into 10 topic categories for text classification and natural language processing (NLP) research such as news topic modeling, transfer learning, and zero-shot evaluation. Each record includes the news headline text, one of the ten pre-defined topic categories, one of the four pre-defined story style descriptors, the media source name, and the publication timestamp.
创建时间:
2025-11-05
原始信息汇总
新闻分类数据集概述
基本信息
- 数据集名称:News Category
- 数据规模:10K<n<100K
- 语言:英语
- 许可证:MIT
- 任务类别:文本分类
数据内容
- 数据量:50,000条英文新闻标题
- 分类数量:10个主题类别
- 数据字段:
title:新闻标题文本topic:预定义主题类别genre:故事风格描述符(如信息性、分析性)source:媒体机构名称date:发布时间戳(ISO-8601格式)
主题类别
| 主题 | 描述 | IPTC媒体主题 |
|---|---|---|
| 政治与政府 | 政治事件、选举、政策、国际关系 | medtop:16000000, medtop:11000000 |
| 商业与经济 | 市场、金融、公司、贸易、创业 | medtop:04000000, medtop:09000000 |
| 技术与科学 | 创新、研究、人工智能、设备、软件 | medtop:13000000 |
| 健康与医学 | 医疗保健、医学研究、健康 | medtop:07000000 |
| 环境与气候 | 气候变化、保护、可持续性 | medtop:03000000, medtop:06000000, medtop:17000000 |
| 体育 | 比赛、运动员、锦标赛、体育产业 | medtop:15000000 |
| 娱乐与文化 | 电影、电视、音乐、艺术、名人 | medtop:01000000 |
| 犯罪与法律 | 刑事司法、法院、安全、警务 | medtop:02000000 |
| 教育 | 学校、大学、学习创新 | medtop:05000000 |
| 社会与生活方式 | 人文趣事、时尚、旅游、社会趋势 | medtop:08000000, medtop:10000000, medtop:12000000, medtop:14000000 |
应用领域
- 文本分类
- 自然语言处理研究
- 新闻主题建模
- 迁移学习
- 零样本评估
背景信息
该数据集是作为COMP7015人工智能课程项目(2025)的一部分策划的,旨在探索深度学习的多类文本分类。
搜集汇总
数据集介绍
构建方式
在新闻文本分类研究领域,该数据集通过系统化采集与标注流程构建而成,涵盖五万条英文新闻标题,每条记录均标注了标题文本、所属主题类别、新闻体裁风格、媒体来源及发布时间。数据采集遵循严格的分类标准,每个新闻标题被精确归入十大主题类别之一,并参照国际IPTC媒体主题编码体系进行标准化映射,确保了分类体系的一致性与专业性。构建过程中注重数据来源的多样性与时效性,所有条目均附带完整的元数据信息,为后续分析提供了丰富的上下文维度。
特点
该数据集最显著的特征在于其精心设计的多维标注体系,不仅包含基础的主题分类标签,还创新性地引入了新闻体裁属性,使研究者能够同时考察内容主题与叙事风格的关联性。数据集涵盖政治、经济、科技、健康等十个互斥的主题类别,每个类别均与标准化的IPTC媒体主题代码相对应,这种双重编码机制极大提升了跨数据集研究的兼容性。数据规模控制在十万条以内,既保证了模型的训练效率,又维持了类别分布的均衡性,特别适合用于探索迁移学习与零样本分类等前沿自然语言处理任务。
使用方法
对于文本分类任务的实践应用,研究者可首先将标题文本作为输入特征,结合对应的主题标签构建监督学习模型。数据集支持多种深度学习架构的验证,包括基于预训练语言模型的微调方法,其丰富的元数据字段允许进行多任务学习探索,例如同时预测主题类别与新闻体裁。在零样本评估场景下,可利用IPTC代码体系构建提示模板,测试模型对未见主题的泛化能力。数据集的标准化格式便于直接加载至主流机器学习框架,其清晰的字段定义也为特征工程与可视化分析提供了便利条件。
背景与挑战
背景概述
在自然语言处理领域,新闻文本分类作为信息组织与知识发现的基础任务,长期受到学术界与工业界的共同关注。News-Categories数据集诞生于2025年,由COMP7015人工智能课程项目组构建,其核心目标在于为多类别文本分类研究提供标准化实验数据。该数据集通过系统采集五万条英文新闻标题,覆盖政治、科技、健康等十个具有IPTC国际标准编码的主题类别,不仅为深度学习模型训练提供高质量语料,更通过跨领域主题分布推动了新闻主题建模与零样本分类的前沿探索。
当前挑战
新闻领域文本分类面临主题边界模糊与语义重叠的固有难题,例如政治与经济类新闻常存在概念交叉,而娱乐与社会议题的区分依赖细粒度语境理解。在数据构建过程中,标注一致性成为关键挑战,需通过IPTC媒体主题标引体系实现多维度语义映射;同时,新闻标题的简洁性特征导致上下文信息缺失,要求模型具备深层语义推理能力。此外,媒体来源的写作风格差异与时效性内容演变,进一步增加了特征表示与领域适应的复杂度。
常用场景
经典使用场景
在自然语言处理领域,新闻分类数据集常被用于构建多类别文本分类模型。该数据集囊括了涵盖政治、经济、科技等十个主题领域的五万条新闻标题,通过精细标注的类别标签为监督学习提供高质量语料。研究者可基于该数据集训练深度神经网络,探索标题文本与主题类别之间的复杂映射关系,进而推动文本自动分类技术的发展。
解决学术问题
该数据集有效解决了新闻领域文本自动归类中的语义理解难题。通过提供标准化标注的新闻标题语料,为迁移学习、零样本分类等前沿研究提供了基准测试平台。其涵盖的跨领域主题分布有助于探究模型在复杂语义场景下的泛化能力,对突破传统分类方法在新闻语料上的性能瓶颈具有重要学术价值。
衍生相关工作
基于该数据集衍生的经典研究包括多模态新闻分析框架的构建,以及结合预训练语言模型的领域自适应方法。众多学者利用其标准化的评估基准,开发出融合注意力机制的层次分类架构,这些成果不仅推动了新闻分类技术的演进,更为跨领域文本理解任务提供了可迁移的方法论支撑。
以上内容由遇见数据集搜集并总结生成


