
kernelbench-mega-traces
收藏官方服务:
资源简介:
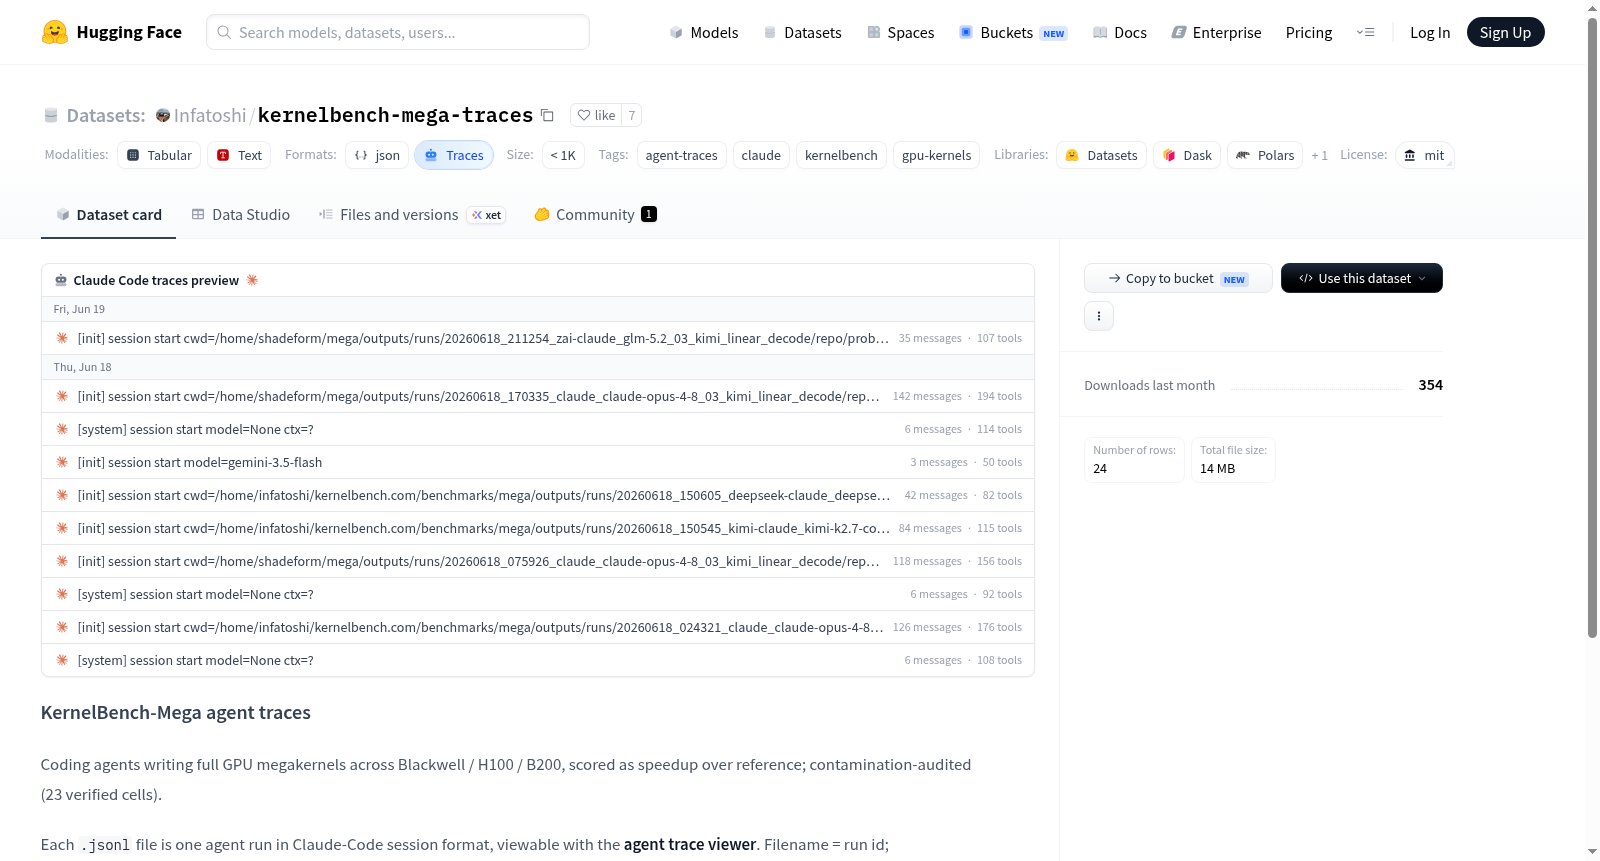
KernelBench-Mega agent traces 是一个专注于GPU内核编程的数据集,包含编码智能体为Blackwell、H100和B200 GPU编写完整巨型内核(megakernels)的轨迹记录。该数据集旨在评估智能体在GPU内核优化任务中的性能,每个轨迹以相对于参考实现的速度提升进行评分,并经过污染审计,包含23个已验证的单元。数据以JSON Lines格式存储,每个.jsonl文件对应一个智能体运行会话,采用Claude-Code会话格式,可通过专用代理轨迹查看器查看;文件名表示运行ID,同时提供manifest.csv文件映射每个运行到具体模型、测试工具、问题类型、GPU类型和得分。数据集规模较小(少于1000个样本),适用于智能体轨迹分析、GPU内核代码生成评估和性能基准测试等任务。数据经过编辑以移除敏感信息,开放提供商路线(如GLM、Kimi、DeepSeek、MiniMax)包含完整推理过程,而Claude和Codex的思维链被加密。数据集采用MIT许可证发布。
创建时间:
2026-06-20
原始信息汇总
数据集概述
- 数据集名称:KernelBench-Mega agent traces
- 数据集地址:https://huggingface.co/datasets/Infatoshi/kernelbench-mega-traces
- 许可证:MIT
- 标签:agent-traces、claude、kernelbench、gpu-kernels
- 数据规模:少于1千个样本(n<1K)
内容描述
该数据集包含23个由编码智能体(agent)编写完整GPU mega内核(megakernels)的运行迹(traces),内核覆盖Blackwell、H100、B200等GPU型号,并以其相对于参考实现的加速比作为评分标准。所有数据均经过污染审计(确认了23个有效单元)。
文件格式与结构
- 每个运行迹以
.jsonl文件格式存储,遵循Claude-Code会话格式,可使用智能体迹查看器(agent trace viewer)浏览。 - 文件名即为运行ID。
manifest.csv文件记录了每次运行对应的模型、测试框架(harness)、问题、GPU型号及得分。
相关信息
- 实时排行榜可访问:https://kernelbench.com/mega
- 数据集已对敏感信息进行脱敏处理:针对开放提供商路线(如GLM、Kimi、DeepSeek、MiniMax)的记录保留完整推理过程;Claude/Codex的推理链(chain-of-thought)已加密。
搜集汇总
数据集介绍
构建方式
KernelBench-Mega agent traces数据集源自对多种前沿GPU内核编程代理运行轨迹的系统性采集,涵盖Blackwell、H100及B200等不同架构。每条轨迹均以Claude-Code会话格式存储于独立的.jsonl文件中,并通过manifest.csv文件建立运行标识与模型、驱动、问题、GPU及性能评分的映射关系。数据集构建过程中严格实施了污染审计,最终筛选出23条经过验证的有效代理轨迹。
特点
该数据集的核心特征在于其高保真度的代理运行记录,完整呈现了编程代理在编写完整GPU巨型内核时的推理与操作过程。每条轨迹均附带相对于参考实现的加速比评分,为衡量代理性能提供了量化基准。值得注意的是,数据集对敏感信息进行了脱敏处理,并针对不同供应商的推理路径采取了差异化的隐私保护策略。
使用方法
用户可通过专用的代理轨迹查看器加载.jsonl文件,以可视化的方式复现和分析编程代理的完整决策流程。数据集附带的manifest.csv文件支持按模型类型、测试问题、目标GPU等维度进行精准检索与比对。研究者和开发者可借此深入研究不同模型在GPU内核自动生成任务上的表现差异,或将其作为训练自定义编程代理的基准数据资源。
背景与挑战
背景概述
随着高性能计算与人工智能领域的迅猛发展,GPU内核的优化成为提升计算效率的关键瓶颈。在此背景下,KernelBench-Mega agent traces数据集应运而生,由相关研究团队于近期创建,旨在系统评估编码智能体在撰写完整GPU巨型内核(涵盖Blackwell、H100、B200等架构)方面的能力。该数据集包含23条智能体运行轨迹,每条轨迹均以Claude-Code会话格式记录,并附带污染审计结果,确保数据的纯净与可信。通过将智能体生成内核相对于参考实现的加速比作为评分标准,该数据集为衡量编码智能体在复杂硬件优化任务中的表现提供了标准化基准。其对应的实时排行榜(kernelbench.com/mega)进一步推动了社区对智能体代码生成能力的比较与改进,对高性能计算与AI基础设施领域产生了深远影响。
当前挑战
该数据集所解决的领域核心挑战在于自动化生成高效GPU巨型内核的复杂性,这一任务要求智能体深刻理解硬件架构差异(如Blackwell、H100、B200)、显存层次结构及并行计算模型,同时需生成超越人工参考性能的内核代码。构建过程中面临多重技术挑战:首先,需设计可复现且公平的评分机制,以准确衡量智能体生成内核的加速比,避免因硬件或环境波动导致的偏差。其次,数据采集需处理开放模型(如GLM、Kimi、DeepSeek、MiniMax)与闭源模型(如Claude、Codex)在推理链透明度上的差异——前者可完整暴露推理逻辑,后者则需加密思维链,增加了审计与可比性难度。此外,污染审计环节要求严格验证每个测试单元是否受训练数据影响,23个验证单元中的每个均需独立核查,以确保基准的纯净性。最后,在会话格式标准化与密钥脱敏处理上,亦需平衡可读性与安全性,使得数据既能被智能体轨迹查看器解析,又不泄露敏感信息。
常用场景
经典使用场景
在现代高性能计算与深度学习加速领域,GPU内核的优化直接关系到模型训练与推理的效率。KernelBench-Mega agent traces数据集聚焦于评估编码智能体在编写完整GPU mega内核时的表现,其核心使用场景为衡量智能体生成的GPU内核相较于参考实现的速度提升。该数据集覆盖Blackwell、H100、B200等多种先进GPU架构,并提供经过污染审计的23个已验证测试单元,为研究者提供了一个标准化、可复现的基准平台,从而系统性地分析不同语言模型在代码生成与优化方面的能力差异。
衍生相关工作
围绕KernelBench-Mega agent traces,已有多个衍生研究工作值得关注。例如,研究者利用该数据集对开源模型(如GLM、Kimi、DeepSeek、MiniMax)与闭源模型(如Claude、Codex)进行对比分析,揭示了不同推理路径下智能体代码生成能力的差异。此外,该数据集为智能体反思与自我修正机制的研究提供了实证基础,相关论文探讨了如何通过迭代反馈进一步提升内核生成质量。同时,其污染审计方法也为构建可信的代码生成基准测试树立了新的标准,启发了后续针对代码生成泛化性与鲁棒性的探索。
数据集最近研究
最新研究方向
KernelBench-Mega agent traces 数据集聚焦于前沿的GPU内核自动生成与优化研究,尤其在Blackwell、H100、B200等最新架构上,通过编码智能体(如Claude、Codex)编写完整的超级内核(Megakernel),以参考实现为基准测量加速比,并严格进行污染审计。该数据集与近期AI辅助硬件编程、异构计算自动化热点紧密相关,其提供的23条高质量智能体轨迹和实时排行榜,为评估和复现大模型在底层系统优化中的能力提供了标准化基准,对推动高性能计算与AI协同发展具有重要科研与工程意义。
以上内容由遇见数据集搜集并总结生成


