
遇见数据集

jeggers/celebrity-dates

收藏
Hugging Face2024-02-20 更新2024-03-04 收录
官方服务:

资源简介:

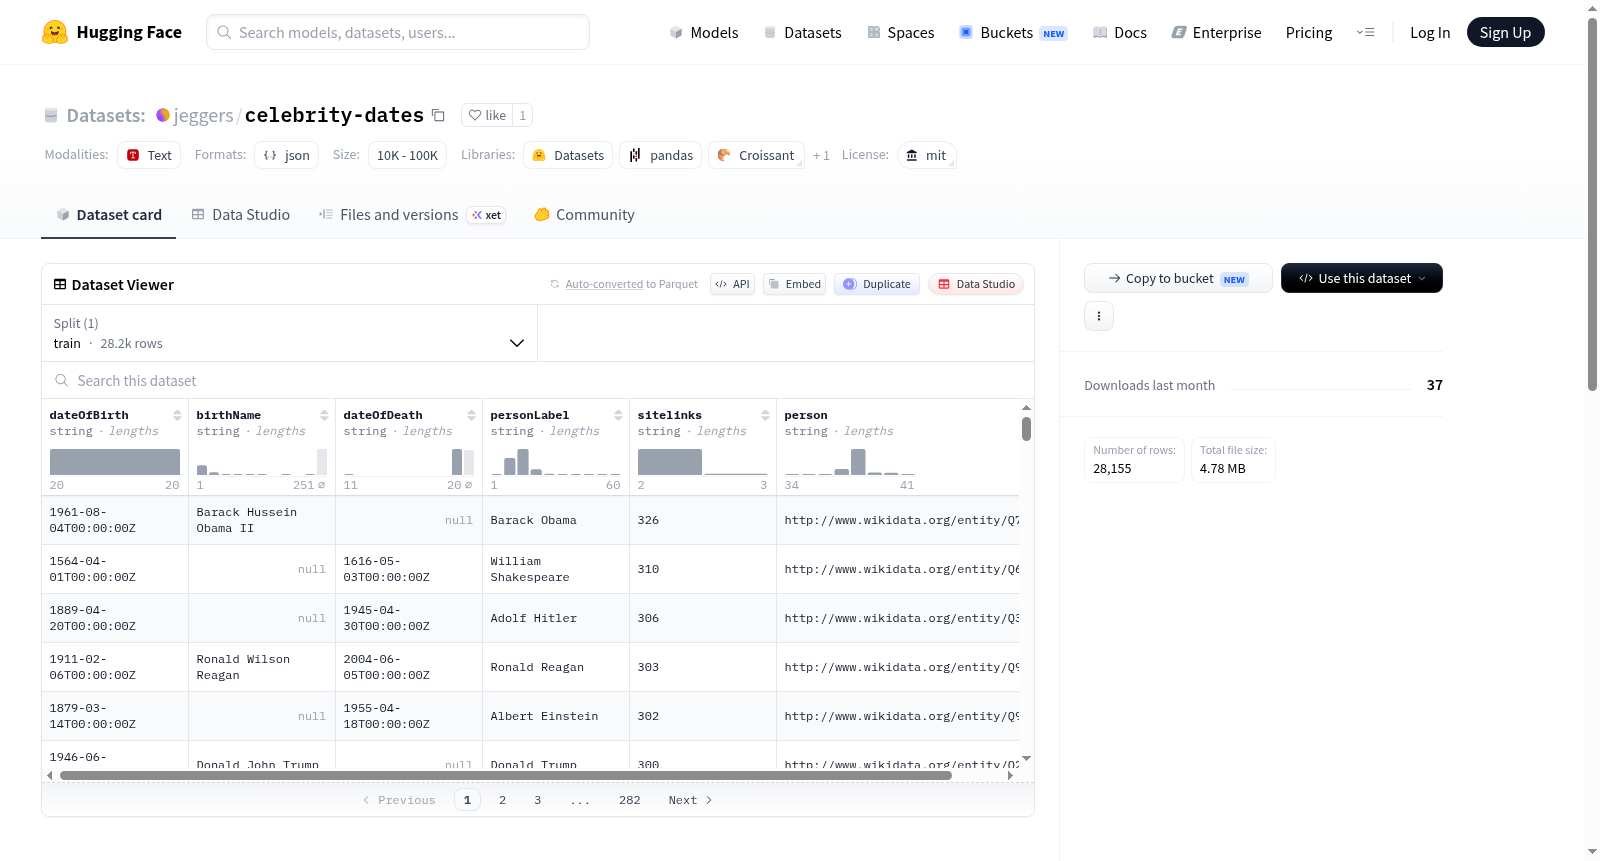
该数据集包含28155条记录,自动从wikidata生成,涵盖人物信息,包括姓名、出生日期、死亡日期、出生名和网站链接计数。数据集中的日期信息可能存在不准确性,尤其是公元0至1500年间的记录。

该数据集包含28155条记录,自动从wikidata生成,涵盖人物信息,包括姓名、出生日期、死亡日期、出生名和网站链接计数。数据集中的日期信息可能存在不准确性,尤其是公元0至1500年间的记录。

提供机构:
jeggers
原始信息汇总

数据集概述

数据集基本信息

  • 数据行数: 28155行
  • 数据来源: 自动从Wikidata生成

包含字段

  • person: Wikidata条目链接
  • personLabel: 维基百科上显示的名称
  • sitelinks: 链接到该人物的站点数量,衡量受欢迎程度,最小值为31
  • dateOfBirth: 出生日期,最小值为0000-01-01
  • dateOfDeath: 死亡日期,可能为空
  • birthName: 出生名,可能为空

数据准确性说明

  • 日期可能不准确,尤其是公元0至1500年间的日期。

查询重现

sql SELECT ?person ?personLabel (SAMPLE(?birthDates) AS ?dateOfBirth) (SAMPLE(?deathDates) AS ?dateOfDeath) ?sitelinks (SAMPLE(?birthNames) AS ?birthName) WHERE { ?article schema:about ?person ; schema:inLanguage "en" ; schema:isPartOf https://en.wikipedia.org/. ?person wdt:P31 wd:Q5 ; wikibase:sitelinks ?sitelinks ; OPTIONAL { ?person wdt:P569 ?birthDates. } OPTIONAL { ?person wdt:P570 ?deathDates. } OPTIONAL { ?person wdt:P1477 ?birthNames . } . FILTER(?sitelinks > 30) FILTER((YEAR(?birthDates) >= 0)) SERVICE wikibase:label { bd:serviceParam wikibase:language "[AUTO_LANGUAGE],en". } } GROUP BY ?person ?personLabel ?sitelinks ORDER BY DESC(?sitelinks)
搜集汇总
数据集介绍
jeggers/celebrity-dates 数据集图片
构建方式
在知识图谱与人物传记数据挖掘的交叉领域中,本数据集jeggers/celebrity-dates应运而生。其构建过程完全自动化,依托于庞大的维基数据(Wikidata)知识库,通过精心设计的SPARQL查询语言从结构化数据中提取信息。查询逻辑聚焦于英文维基百科条目中的人物实体,筛选出站点链接数超过30的知名人物,确保数据集中包含的人物具有一定的网络影响力。数据集共收录28,155条记录,每条记录包含指向维基数据条目的人物链接、维基百科显示名称、作为知名度指标的站点链接数、出生日期、可能为空的死亡日期及本名等字段,构建过程严谨且可复现。
特点
该数据集的核心特色在于其自动化的数据采集机制与丰富的元数据字段,为名人时间线分析提供了坚实基础。其中,站点链接数作为人物知名度的量化指标,为研究者提供了排序与筛选的便利。然而,数据集中生日字段的精确性存在一定局限性,尤其对于公元0年至1500年间的历史人物,日期可能存在偏差,这要求使用者在使用时需审慎对待早期人物的时间信息。死亡日期与本名字段允许为空值,反映了数据来源的原始状态,也提示了数据完备性的边界。
使用方法
本数据集的使用方法灵活多样,适用于多种人物分析与时间序列研究场景。用户可直接加载CSV格式的数据,利用人物标签进行姓名匹配与检索,或依据站点链接数进行人物影响力排序。出生与死亡日期字段可用于计算人物寿命、构建历史人物时间线或分析不同时代名人的分布特征。对于需要精确时间信息的研究,建议对早期人物数据进行额外核验。此外,数据集附带的SPARQL查询语句允许用户根据自身需求调整筛选条件,从维基数据中重新定制或扩充数据集,增强了其可扩展性与复用价值。
背景与挑战
背景概述
名人出生与死亡日期数据集在计算社会科学、人口统计学以及文化演进研究中扮演着关键角色,为量化分析名人生命周期、公众关注度与历史变迁提供了基础数据支撑。jeggers/celebrity-dates数据集由研究人员基于维基数据(Wikidata)自动构建,创建时间不详,但依托于维基百科与维基数据庞大的知识图谱。该数据集收录了28,155位名人的基本信息,包括维基数据条目链接、姓名、网站链接数(衡量知名度的指标)、出生日期、死亡日期(可能为空)以及出生名(可能为空)。其核心研究问题在于提供一份结构化的名人时间数据,以支持关于名人寿命、知名度分布以及历史时期人口特征的分析。该数据集通过筛选网站链接数大于30的名人,确保了数据对象具有一定的公众影响力,从而在相关领域具有较高的研究价值,尤其适用于探索名人群体的人口统计学规律与文化影响力的时间演变。
当前挑战
该数据集面临的挑战首先体现在领域问题的复杂性上:名人出生与死亡日期的准确性是人口学与历史研究的基础,但数据集中明确指出,尤其是公元0年至1500年之间的日期可能存在不精确性,这源于历史记录本身的模糊性与维基数据源的不确定性,使得基于这些日期进行的统计分析(如寿命趋势、时代对比)可能引入系统性偏差。其次,在构建过程中,自动从维基数据抽取信息的方法虽高效,却难以避免数据缺失与不一致问题,例如死亡日期与出生名字段允许为空,导致样本不完备;同时,网站链接数作为知名度指标,可能受维基百科编辑偏好与语言版本差异影响,并非绝对客观的衡量标准。此外,数据集的跨时间跨度极大(从公元元年至今),不同历史时期的名人记录完整度差异显著,进一步增加了数据质量控制的难度,需研究人员在使用时谨慎处理缺失值与异常值。
常用场景
经典使用场景
在计算社会科学与知识图谱研究领域,jeggers/celebrity-dates数据集以其丰富的名人时间信息而备受青睐。该数据集收录了超过两万八千条维基数据实体记录,涵盖从古代至当代的知名人物,每一条目均包含精确或近似的出生与逝世日期。研究者常将其用作时间感知型自然语言处理任务的基准资源,例如事件时间线构建、人物生命周期建模以及跨时代社会网络分析。通过整合人物标签、维基百科链接数量(作为流行度代理指标)及出生姓名等字段,该数据集为探索名人文化的时间演化规律提供了坚实的数据基础。其自动生成的特性也使其成为验证知识图谱自动构建方法有效性的理想测试集,尤其适用于处理历史人物数据稀疏性与日期不精确性的挑战。
衍生相关工作
围绕jeggers/celebrity-dates数据集,学术界已衍生出一系列富有影响力的后续工作。在时间知识图谱领域,研究者基于该数据集提出了多种时间感知的实体嵌入方法,通过将时间戳融入向量表示,显著提升了跨时间段的链接预测与关系推理性能。在自然语言处理方面,有工作利用该数据集训练时间敏感型命名实体识别模型,实现了对历史文本中人物时间属性的自动抽取。此外,社会网络分析学者结合该数据集与维基百科页面链接结构,构建了动态名人协作网络,揭示了不同时代名人间跨领域互动的演化模式。数据集还被用于验证时间序列预测算法在文化流行度预测中的有效性,催生了结合时间衰减函数与图神经网络的混合模型。这些衍生研究不仅拓展了数据集的应用边界,也深化了我们对时间维度上名人现象的理解。
数据集最近研究
最新研究方向
在计算社会科学与知识图谱交叉领域,jeggers/celebrity-dates数据集为名人生命周期动态分析提供了结构化数据支撑。该数据集通过自动抽取维基数据中全球名人的出生与死亡日期、知名度指标及本名信息,构建了跨越千年的名人样本库。当前前沿研究聚焦于利用该资源探究名人寿命与历史时期、地域文化及社会地位的交互关系,例如分析中世纪至现代名人寿命的演变趋势,或结合sitelinks量化指标揭示知名度与寿命的潜在关联。数据集在数字人文与流行病学中的价值日益凸显,为文化演化建模、历史人口统计及公众人物健康研究开辟了新路径,其开放的MIT许可也促进了跨学科协作与可重复性分析。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

