CATIE-AQ/newsquadfr_fr_prompt_question_generation_with_context
收藏资源简介:
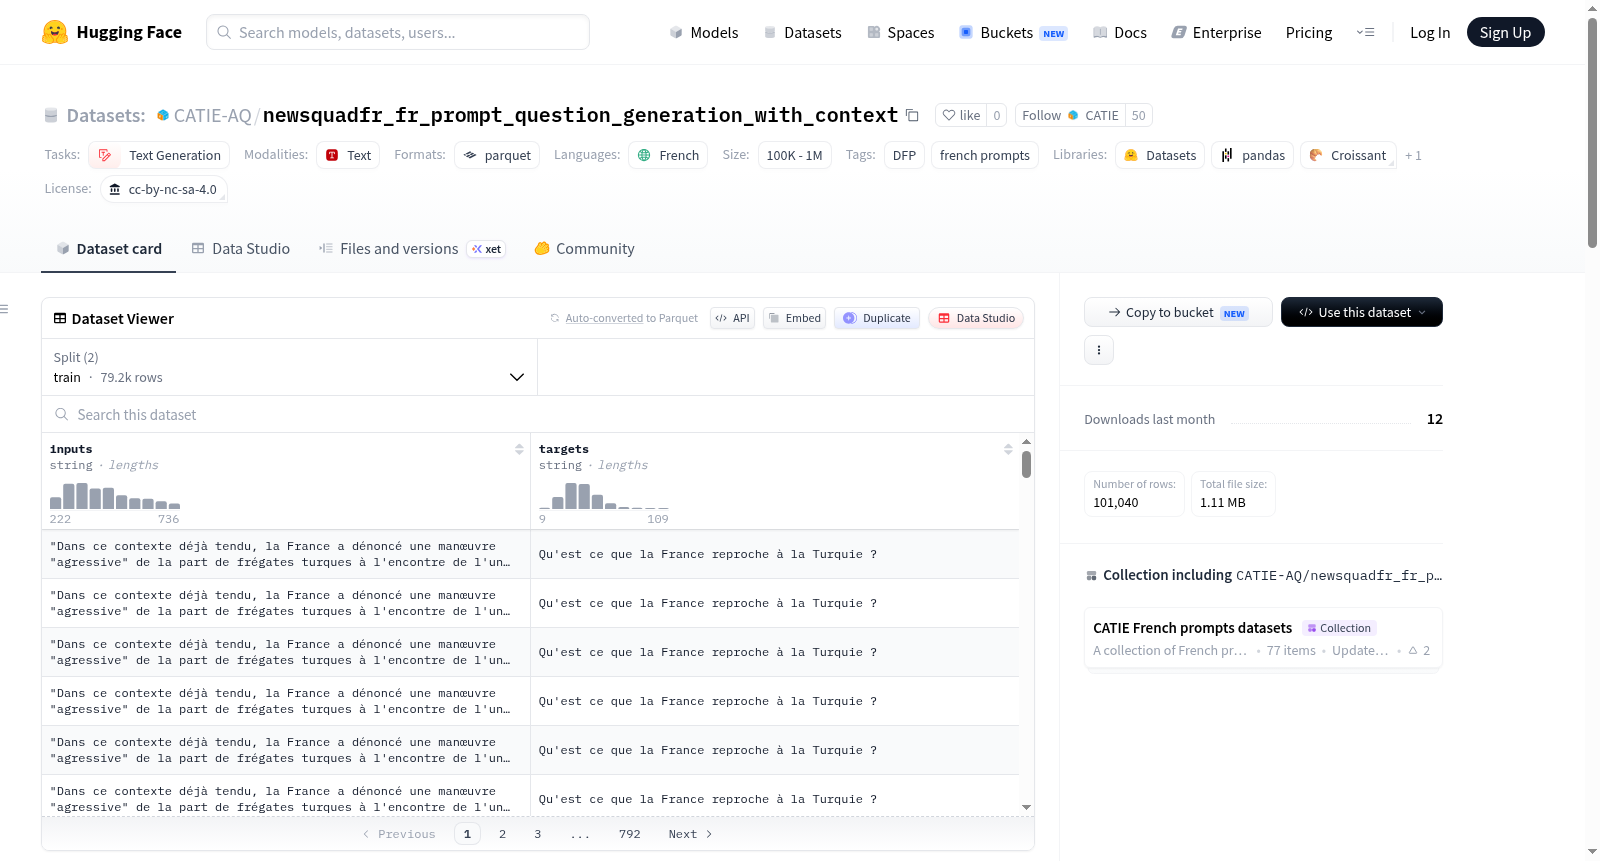
newsquadfr_fr_prompt_question_generation_with_context是一个包含101,040行数据的数据集,专门设计用于带有上下文的问题生成任务。该数据集是Dataset of French Prompts (DFP)的子集,原始数据来自newsquadfr,并通过FrenchQA数据集中的问题进行增强。数据集使用了24个提示,这些提示旨在通过不同的语气和称呼方式生成问题。数据集分为训练集(79,200样本)和验证集(21,800样本),没有测试集。
newsquadfr_fr_prompt_question_generation_with_context是一个包含101,040行数据的数据集,专门设计用于带有上下文的问题生成任务。该数据集是Dataset of French Prompts (DFP)的子集,原始数据来自newsquadfr,并通过FrenchQA数据集中的问题进行增强。数据集使用了24个提示,这些提示旨在通过不同的语气和称呼方式生成问题。数据集分为训练集(79,200样本)和验证集(21,800样本),没有测试集。
数据集概述
基本信息
- 语言: 法语
- 许可: CC BY-NC-SA 4.0
- 数据规模: 100K<n<1M
- 任务类别: 文本生成
- 标签: DFP, french prompts
- 注释创建者: found
- 语言创建者: found
- 多语言性: 单语种
- 源数据集: newsquadfr
详细描述
newsquadfr_fr_prompt_question_generation_with_context 是 Dataset of French Prompts (DFP) 的一个子集。
该数据集包含 101,040 行,可用于带上下文的问题生成任务。
原始数据(无提示)来自 newsquadfr 数据集,并通过 FrenchQA 数据集中的 SQUAD 2.0 格式问题进行了增强。
随后应用了一系列提示(见下文),以构建输入和目标列,从而获得与 Muennighoff 等人的 xP3 数据集相同的格式。
提示列表
该数据集使用了 24 个提示,逻辑上包括陈述语气、第二人称单数和第二人称复数形式。
plaintext
"+context+"
Générer une question à partir du texte ci-dessus : ,
"+context+"
Génère une question à partir du texte ci-dessus : ,
"+context+"
Générez une question à partir du texte ci-dessus : ,
"+context+"
Trouver une question à partir du texte ci-dessus : ,
"+context+"
Trouve une question à partir du texte ci-dessus : ,
"+context+"
Trouvez une question à partir du texte ci-dessus : ,
"+context+"
Créer une bonne question à partir du texte ci-dessus : ,
"+context+"
Crée trouver une bonne question à partir du texte ci-dessus : ,
"+context+"
Créez trouver une bonne question à partir du texte ci-dessus : ,
"+context+"
Ecrire une bonne question à partir du texte ci-dessus : ,
"+context+"
Ecris une bonne question à partir du texte ci-dessus : ,
"+context+"
Ecrivez une bonne question à partir du texte ci-dessus : ,
Générer une bonne question pour le texte suivant : "+context+",
Génère une bonne question pour le texte suivant : "+context+",
Générez une bonne question pour le texte suivant : "+context+",
Trouver une bonne question pour le texte suivant : "+context+",
Trouve une bonne question pour le texte suivant : "+context+",
Trouvez trouver une bonne question pour le texte suivant : "+context+",
Créer une bonne question pour le texte suivant : "+context+",
Crée trouver une bonne question pour le texte suivant : "+context+",
Créez trouver une bonne question pour le texte suivant : "+context+",
Ecrire une bonne question pour le texte suivant : "+context+",
Ecris une bonne question pour le texte suivant : "+context+",
Ecrivez une bonne question pour le texte suivant : "+context+"
数据分割
train: 79,200 样本valid: 21,800 样本- 无
test分割
使用方法
python from datasets import load_dataset dataset = load_dataset("CATIE-AQ/newsquadfr_fr_prompt_question_generation_with_context")
引用
原始数据
Hugging Face repository: https://huggingface.co/datasets/lincoln/newsquadfr
本数据集
@misc {centre_aquitain_des_technologies_de_linformation_et_electroniques_2023,
author = { {Centre Aquitain des Technologies de lInformation et Electroniques} },
title = { DFP (Revision 1d24c09) },
year = 2023,
url = { https://huggingface.co/datasets/CATIE-AQ/DFP },
doi = { 10.57967/hf/1200 },
publisher = { Hugging Face }
}
许可
CC BY-NC-SA 4.0