moss-character-voices-bestof64
收藏资源简介:
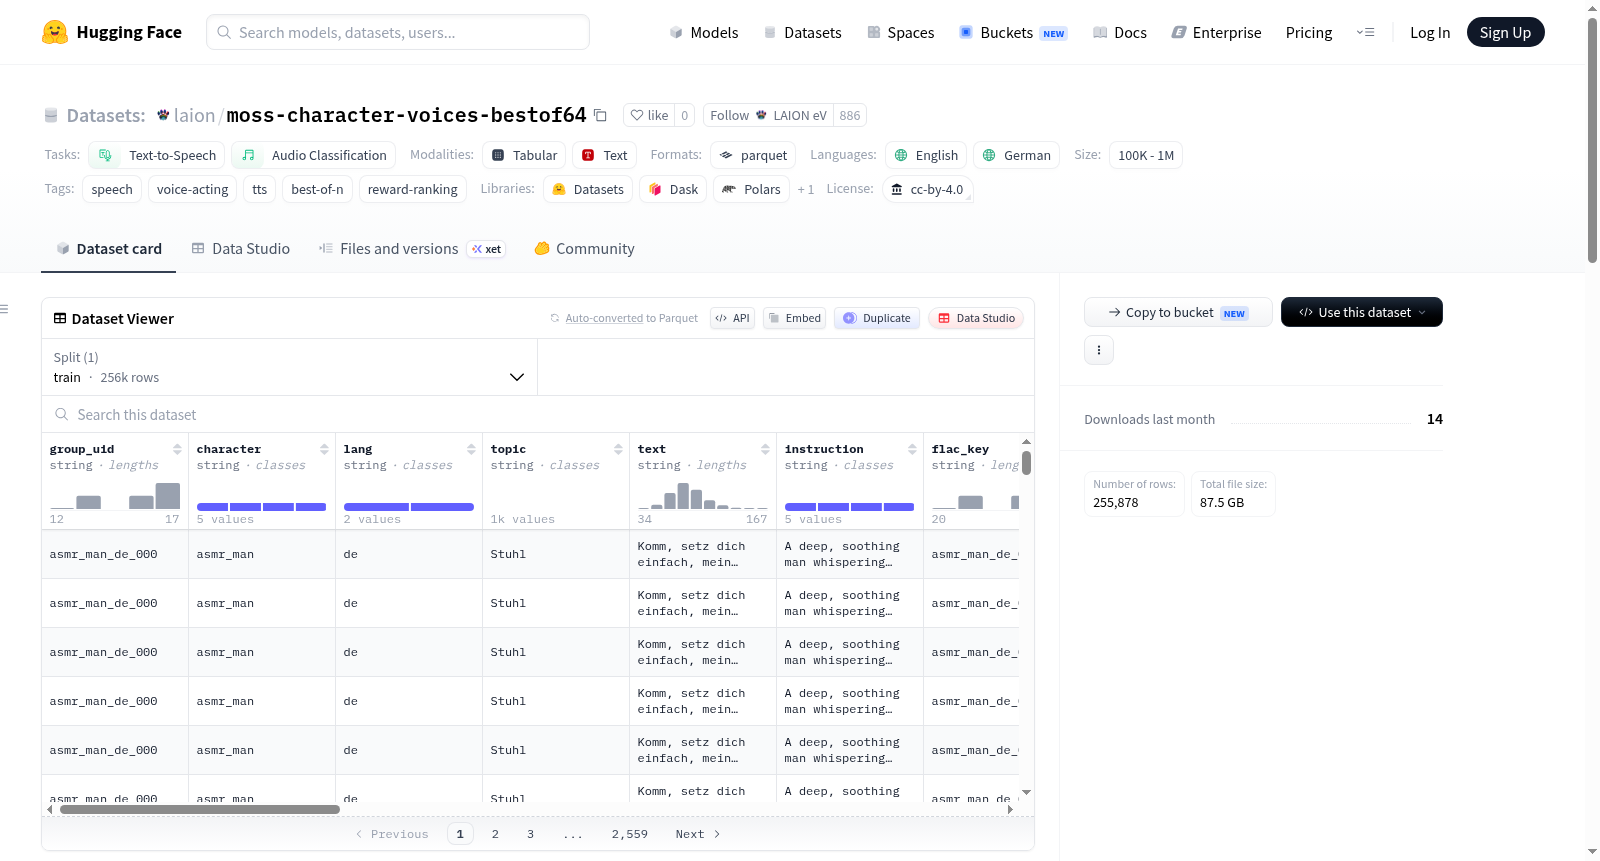
MOSS Character Voices — Best-of-64 (Stage 2) 是一个用于文本到语音和音频分类任务的语音数据集。该数据集基于4.55B参数的MOSS-TTS-Local语音模型生成,包含13个进化角色声音(如asmr_man、asmr_woman、dragon、evil_ghost、fairy、goblin、mouse、ork、pain_scream、ranting、sad_man、sad_woman、zombie)的语音表演片段。每个数据样本由一个固定的、优化的冠军表演指令和一个Gemma生成的主题文本组成,共同构成一个表演渲染任务。对于每个提示,使用不同的种子采样64个48 kHz的语音片段,并通过每角色奖励模型进行评分和排序(排名1为最佳)。数据集采用多模型评分系统,包括VoiceCLAP-commercial(用于自然度/质量和真实度评分)、57 VoiceNet回归头(用于原始声学/特征维度)、每角色EmoNet情感头(用于原始情感评分)和Parakeet-TDT ASR(用于逆词错误率)。最终每角色奖励由这些评分项经最小-最大归一化后加权计算得出。数据以WebDataset格式组织,包含FLAC 48 kHz音频文件(无损PCM_16编码)和Parquet格式的元数据文件。元数据包含组ID、角色、语言、主题、文本、指令、音频键、种子、排名、奖励、角色评分、角色情感评分、自然度评分、真实度评分、逆词错误率、持续时间、假设文本、维度JSON、情感JSON等字段。数据集目前包含700个提示组,44,781个语音片段,支持英语和德语两种语言。最终目标规模为12,984组×64个片段≈831,000个剪辑,约250-380 GB FLAC数据。数据集采用CC-BY-4.0许可证。
MOSS Character Voices — Best-of-64 (Stage 2) is a speech dataset for text-to-speech and audio classification tasks. It is generated based on the 4.55B-parameter MOSS-TTS-Local speech model and contains voice performance segments from 13 evolved character voices. Each data sample consists of a fixed, optimized champion performance instruction and a Gemma-generated topic text, together forming a performance rendering task. For each prompt, 48 kHz speech segments are sampled using different seeds, and they are scored and ranked (rank 1 is the best) by a per-character reward model. The dataset employs a multi-model scoring system, including VoiceCLAP-commercial (for naturalness/quality and authenticity scores), 57 VoiceNet regression heads (for raw acoustic/feature dimensions), per-character EmoNet emotion heads (for raw emotion scores), and Parakeet-TDT ASR (for inverse word error rate). The final per-character reward is calculated by weighting these scoring items after min-max normalization. The data is organized in WebDataset format, containing FLAC 48 kHz audio files (lossless PCM_16 encoding) and Parquet metadata files. Metadata includes fields such as group ID, character, language, topic, text, instruction, audio key, seed, ranking, reward, character score, character emotion score, naturalness score, authenticity score, inverse word error rate, duration, hypothesis text, dimension JSON, and emotion JSON. The dataset currently contains 700 prompt groups, 44,781 speech segments, and supports English and German languages. The target size is 12,984 groups × 64 segments ≈ 831,000 clips, approximately 250-380 GB of FLAC data. The included characters are: asmr_man, asmr_woman, dragon, evil_ghost, fairy, goblin, mouse, ork, pain_scream, ranting, sad_man, sad_woman, zombie. The dataset uses the CC-BY-4.0 license.
数据集概述:MOSS Character Voices — Best-of-64 (Stage 2)
这是一个面向文本转语音和语音分类任务的数据集,包含了从 4.55B MOSS-TTS-Local 语音表演模型(laion/moss-tts-local-transformer-4.55b-voice-acting)中,针对 13种进化角色语音,通过 Best-of-64 方法筛选出的高质量语音样本。
核心构成
- 提示(Prompt):每个提示由固定的、优化的“冠军表演方向”(instruction)和 Gemma 生成的“主题文本”(text)组成,共同定义一次语音表演。
- 采样方式:对每个提示,以 48 kHz 采样率、使用不同随机种子生成 64个候选录音。
- 排序机制:通过每个角色特有的奖励模型,对这 64 个候选录音在组内进行评分和排序(排名 1 为最佳)。
评分机制
每个候选录音使用生产级的无参考评估堆栈进行评分:
- VoiceCLAP-commercial:评估自然度和质量(
blend,0-10分)以及真实性(genu,0-6分)。 - VoiceNet(57个回归头):提取原始声学/特征维度(
dims_json),每个角色加权正负维度得到char分。 - Per-character EmoNet:基于 BUD-E-Whisper 编码器和 Empathic-Insight-Voice-Plus 的情感头,输出原始情感分数(
emo_json)并加权得到char_emo。 - Parakeet-TDT ASR:计算
invwer(1 - 字符错误率,钳制处理)。 - 最终奖励 =
w_blend·norm(blend) + w_genu·norm(genu) + w_vn·char + w_emo·char_emo,所有项在每组 64 个样本内进行最小-最大归一化,再乘以每个字符定义的 WER 因子(gate/soft/none)。
文件布局(WebDataset 格式)
webdataset/shard-NNNNN.tar:包含 48 kHz FLAC 格式(无损,PCM_16)音频文件,文件名格式为{group_uid}_{rank:02d}.flac。metadata/scores-NNNNN.parquet:每个候选录音对应一行,包含字段:group_uid,character,lang,topic,text,instruction,flac_key,seed,rank,reward,char,char_emo,blend,genu,invwer,dur,hyp,dims_json,emo_json,best_reward,mean_reward,best_key。
数据和语言分布(当前进度)
- 已完成:2,700 / 12,984 个提示组,共 172,707 个候选录音,27 个分片。
- 角色分布示例:
- asmr_man: 1000 组
- asmr_woman: 1000 组
- dragon: 700 组
- 语言分布:
- 德语(de): 1496 组
- 英语(en): 1204 组
数据集规模(目标)
- 目标:12,984 组 × 64 候选 = 约 831k 个音频片段,约 250–380 GB FLAC 数据。
- 生成过程:在 8 块 A100/H100 上运行约 2-3 天,按约 1 GB 的分片增量上传。
角色列表
包含 13 种进化语音角色:asmr_man, asmr_woman, dragon, evil_ghost, fairy, goblin, mouse, ork, pain_scream, ranting, sad_man, sad_woman, zombie。每个角色有独立的奖励配置。
许可协议
CC-BY-4.0。