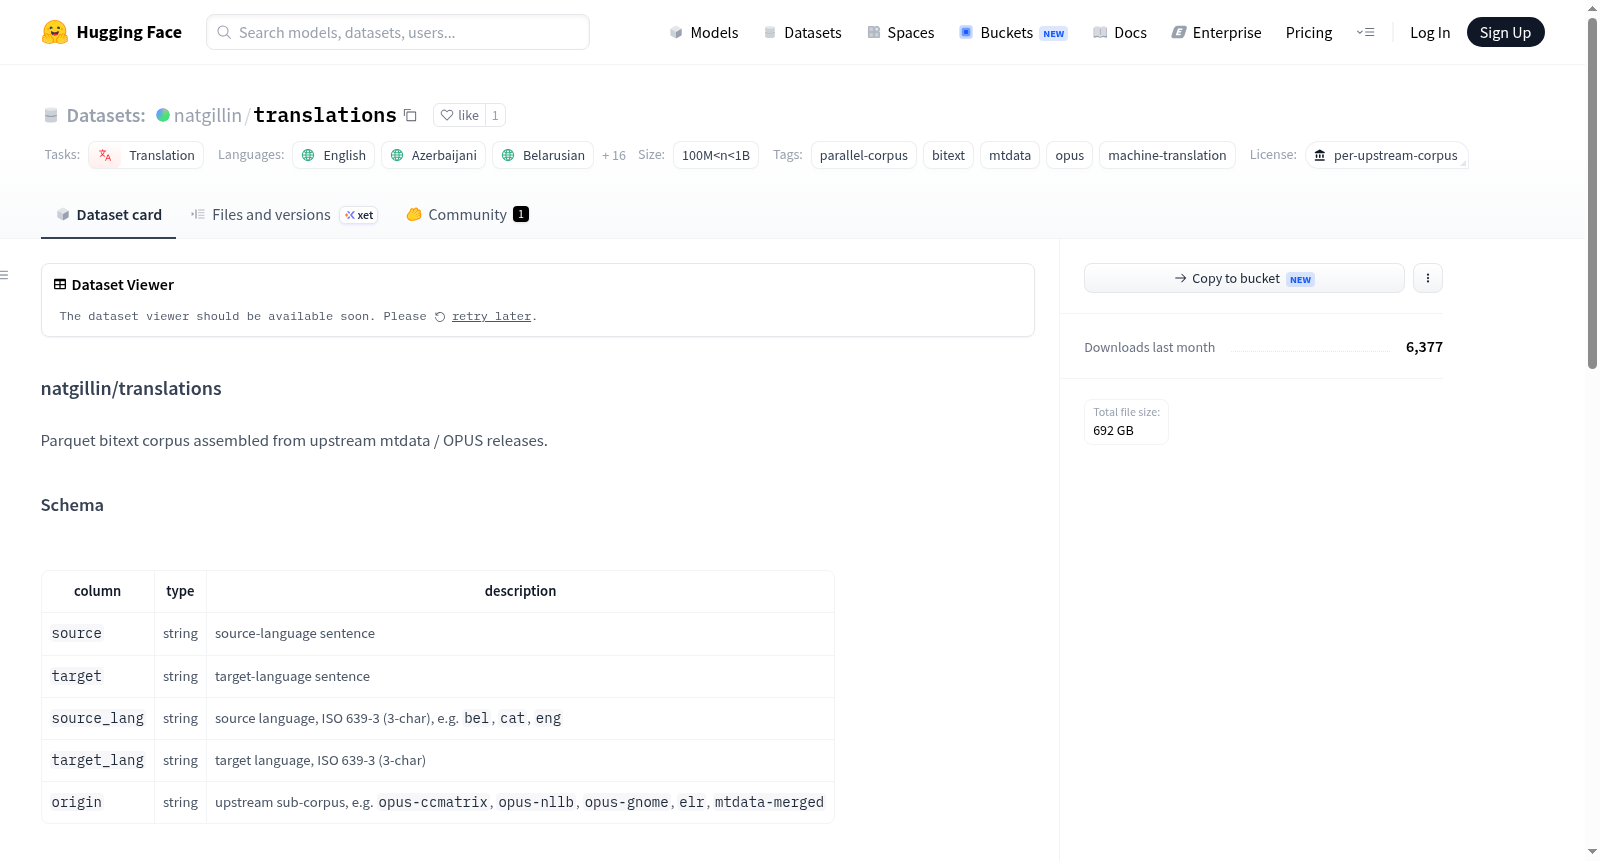
natgillin/translations
收藏资源简介:
该数据集是一个多语言平行语料库,名为Translations,专门用于机器翻译任务。它由上游mtdata和OPUS发布的数据集组装而成,包含多种语言对,如英语与阿塞拜疆语、白俄罗斯语、保加利亚语、加泰罗尼亚语、丹麦语、爱沙尼亚语、芬兰语、古吉拉特语、匈牙利语、卡纳达语、马拉雅拉姆语、挪威语、奥里亚语、旁遮普语、罗马尼亚语、斯洛伐克语、泰米尔语和乌尔都语等。数据集规模在100M到1B之间,以Parquet格式存储,每个语言对有一个独立的配置。数据包括源语言句子、目标语言句子、源语言代码(ISO 639-3标准)、目标语言代码和来源子语料库标识(如opus-ccmatrix、mtdata-merged等)。数据集的许可证遵循上游语料库的条款,需引用OPUS来源。
This dataset is a multilingual parallel corpus named Translations, designed for machine translation tasks. It is assembled from upstream mtdata and OPUS releases, covering multiple language pairs such as English with Azerbaijani, Belarusian, Bulgarian, Catalan, Danish, Estonian, Finnish, Gujarati, Hungarian, Kannada, Malayalam, Norwegian, Odia, Punjabi, Romanian, Slovak, Tamil, and Urdu. The dataset size ranges from 100M to 1B, stored in Parquet format with separate configurations for each language pair. It includes columns for source sentences, target sentences, source language codes (ISO 639-3), target language codes, and origin sub-corpus identifiers (e.g., opus-ccmatrix, mtdata-merged). The license inherits per-corpus terms from the upstream OPUS sources, requiring citation of OPUS.
数据集:natgillin/translations
- 任务:翻译
- 语言:英语、阿塞拜疆语、白俄罗斯语等(共约18种)
- 大小:1亿到10亿条(100M < n < 1B)
- 格式:Parquet
- 许可证:遵循上游语料库的许可条款
数据集描述
该数据集是一个由上游 mtdata / OPUS 发布版本组成的 Parquet 双语平行语料库。
数据模式
每一条数据包含以下字段:
| 列名 | 类型 | 描述 |
|---|---|---|
source |
string | 源语言句子 |
target |
string | 目标语言句子 |
source_lang |
string | 源语言,ISO 639-3 三字母代码(如 bel、cat、eng) |
target_lang |
string | 目标语言,ISO 639-3 三字母代码 |
origin |
string | 上游子语料库标识(如 opus-ccmatrix、opus-nllb、opus-gnome、elr、mtdata-merged) |
源语言/目标语言的顺序按 ISO 639-3 代码的字母顺序固定(例如 bel 在 eng 之前),以保证对名确定性,便于双向连接。
文件结构(按语言对划分)
一个语言对一个配置(config)。OPUS 子语料库通过行级列(origin)区分,不作为独立配置。
data/ cat-eng/ opus-ccmatrix-00000-of-00200.parquet opus-nllb-00000-of-00200.parquet opus-gnome-<file_hash>-00000.parquet mtdata-merged-00000-of-00200.parquet ... bel-eng/ ...
每个语言对固定使用 split: train,以避免文件名中如 -test- 的子串被自动识别为测试集。
来源说明(origin 字段常见值)
mtdata-merged— mtdata 对该语言对去重合并后的双语文本opus-<source>— 某个上游 OPUS 子语料库,例如:opus-ccmatrix、opus-nllb、opus-ccaligned、opus-multiccaligned、opus-wikimatrix、opus-eubookshop、opus-kde4、opus-gnome、opus-neulab-tedtalks、opus-elrc-*、opus-tatoeba、opus-ted2020等elr— 来自 ELRA / ELR 的语料切片unknown— 无法匹配任何已知 OPUS 模式的记录
引用说明
许可条款遵循上游 OPUS 来源的每个语料库许可证。引用时请参考 OPUS:https://opus.nlpl.eu