
vlm-project-with-images-with-bbox-images-v5
收藏数据链接:
官方服务:
资源简介:
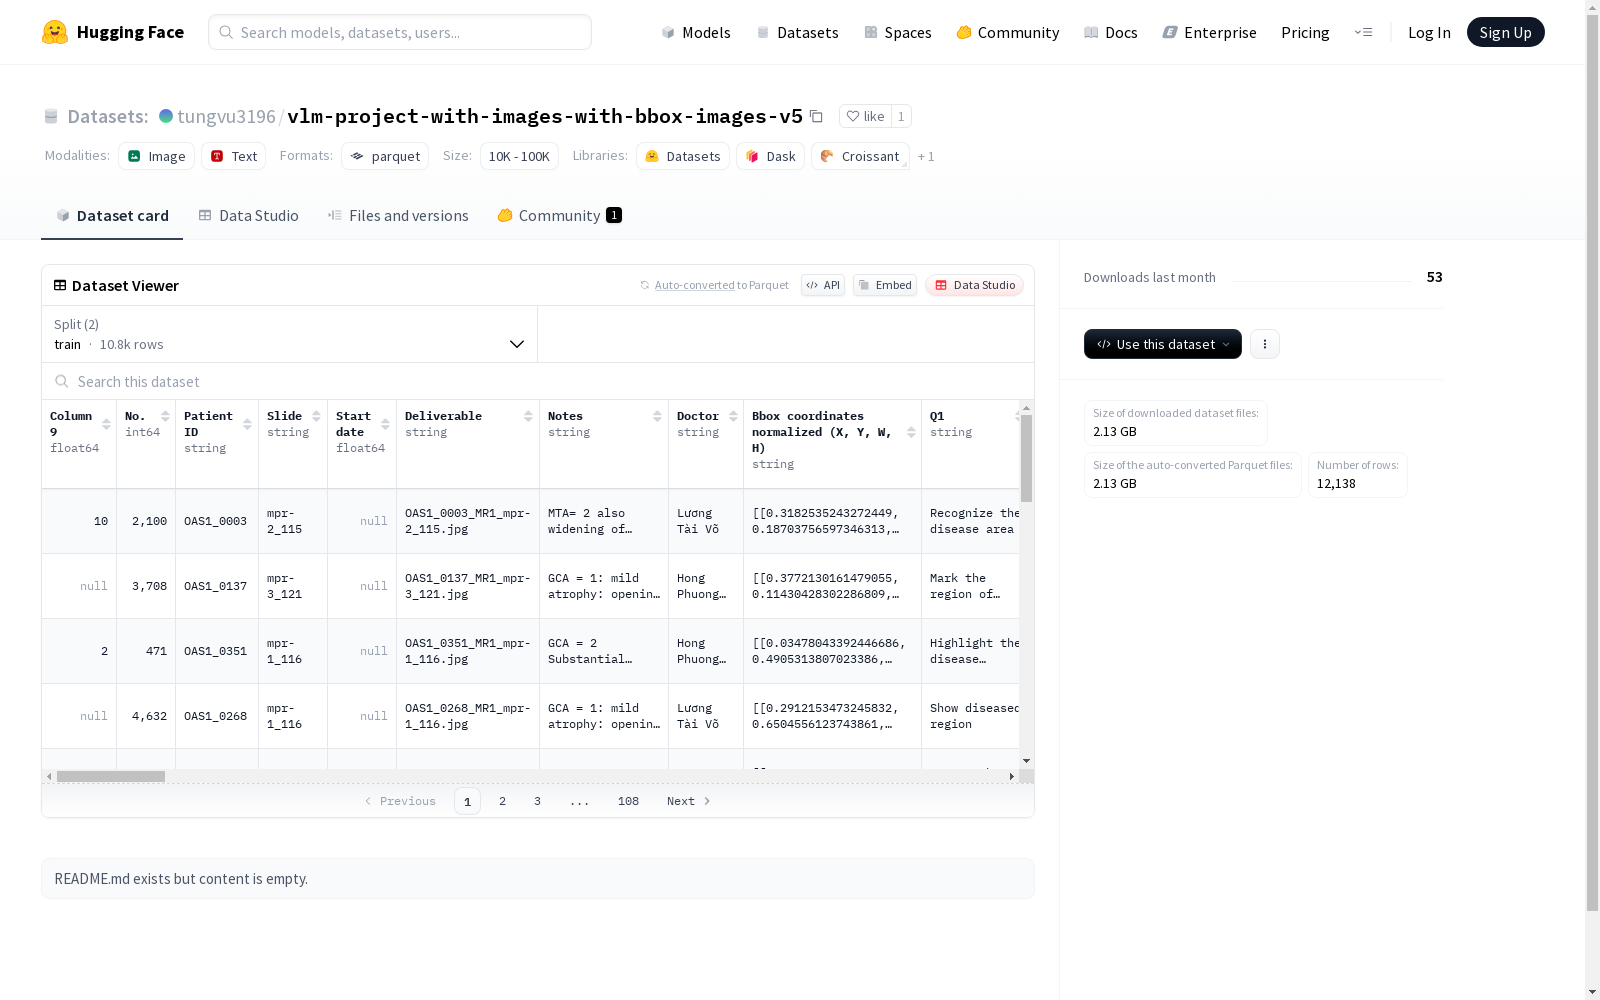
该数据集包含多个字段,如患者ID、幻灯片信息、日期、可交付成果、备注、医生信息、归一化边界框坐标等。数据集中的问题(Q)和答案(A)字段提供了多语言版本,包括越南语、法语、德语、普通话、韩语、日语等。此外,数据集还包含图像及其带边界框的版本。数据集分为训练集和测试集,可用于图像识别和机器翻译等任务。
This dataset comprises multiple fields, including patient ID, slide information, date, deliverables, notes, physician information, normalized bounding box coordinates, and more. The question (Q) and answer (A) fields in the dataset are available in multiple language versions, such as Vietnamese, French, German, Mandarin, Korean, Japanese, etc. In addition, the dataset includes both original images and their versions with bounding boxes. The dataset is divided into training set and test set, which can be used for tasks including image recognition and machine translation.
创建时间:
2025-06-22
原始信息汇总
数据集概述
基本信息
- 数据集名称: vlm-project-with-images-with-bbox-images-v5
- 存储位置: https://huggingface.co/datasets/tungvu3196/vlm-project-with-images-with-bbox-images-v5
- 下载大小: 2,129,671,124 字节
- 数据集大小: 2,186,038,851.8144474 字节
数据集特征
- 特征数量: 56
- 主要特征:
Column 9: float64No.: int64Patient ID: stringSlide: stringStart date: float64Deliverable: stringNotes: stringDoctor: stringBbox coordinates normalized (X, Y, W, H): stringQ1,Q2,Q3,Q4: stringOriginal: stringGoogle Drive Link: stringrotated_link: stringA1,A2,A3,A4: stringStatus: string__index_level_0__: int64image: imageimage_with_bboxes: image
- 多语言特征:
Q1_vn,Q1_fr,Q1_de,Q1_mandarin,Q1_korean,Q1_japaneseQ2_vn,Q2_fr,Q2_de,Q2_mandarin,Q2_korean,Q2_japaneseA2_vn,A2_fr,A2_de,A2_mandarin,A2_korean,A2_japaneseQ4_vn,Q4_fr,Q4_de,Q4_mandarin,Q4_korean,Q4_japaneseA4_vn,A4_fr,A4_de,A4_mandarin,A4_korean,A4_japaneseQ3_vn,Q3_fr,Q3_de,Q3_mandarin,Q3_korean,Q3_japanesevn,fr,de,mandarin,korean,japanese,vi
数据集划分
- 训练集 (train):
- 样本数量: 10,783
- 大小: 1,946,305,306 字节
- 测试集 (test):
- 样本数量: 1,355
- 大小: 239,733,545.81444758 字节
配置文件
- 配置名称: default
- 数据文件路径:
- 训练集: data/train-*
- 测试集: data/test-*
搜集汇总
数据集介绍
构建方式
在医学影像分析领域,数据集的构建往往需要多维度信息的整合。vlm-project-with-images-with-bbox-images-v5数据集通过系统化采集患者影像资料与临床数据,构建了一个包含10783例训练样本和1355例测试样本的标准化数据库。每例样本不仅包含原始医学影像,还标注了归一化的边界框坐标(X,Y,W,H),并整合了患者ID、检查日期、医生诊断意见等临床元数据,同时通过多语言翻译系统实现了英语、越南语、法语等六种语言的问答对标注。
特点
该数据集最显著的特征在于其多模态数据结构设计。影像数据以两种形式呈现:原始图像和带标注框的可视化图像。文本维度上,每个病例配套四个临床问题(Q1-Q4)及对应答案(A1-A4),并扩展出六种语言版本。边界框坐标采用归一化处理,确保不同分辨率影像的可比性。数据字段涵盖从基础标识符(Patient ID, Slide)到多语言翻译(vn, fr, de等)共42个特征维度,为跨语言医学视觉问答研究提供了理想素材。
使用方法
研究者可通过HuggingFace平台直接加载该数据集,默认配置已划分为train和test两个标准化分片。使用时应重点关注image_with_bboxes字段获取带标注框的可视化影像,结合Bbox coordinates normalized字段进行目标检测模型训练。多语言问答对(如Q1_vn/A2_vn)支持跨语言视觉理解任务,而Google Drive Link字段提供了原始高分辨率影像的获取途径。建议优先采用PyTorch或TensorFlow框架处理图像数据,并利用pandas解析结构化临床数据。
背景与挑战
背景概述
vlm-project-with-images-with-bbox-images-v5数据集是一个专注于医学影像分析的多模态数据集,由专业医学研究团队构建。该数据集整合了患者ID、医学影像切片、标注框坐标及多语言问答数据,旨在推动计算机视觉与自然语言处理在医疗诊断中的交叉应用。其核心研究问题在于通过视觉-语言联合建模,实现医学影像的智能解读与多语言交互,为远程医疗和跨地域医疗协作提供技术支持。数据集涵盖英语、法语、德语、中文、日语等六种语言的标注,反映了全球化医疗场景下的实际需求。
当前挑战
该数据集面临双重技术挑战:在领域问题层面,医学影像的细微病理特征与多语言描述的精准对齐需要克服语义鸿沟,尤其是不同语种医学术语的差异性表达;在构建过程中,标注框的标准化处理涉及影像旋转、归一化坐标转换等复杂操作,而多语言标注的质量控制则需平衡专业医学准确性与语言本土化表达。此外,患者隐私保护要求原始数据脱敏处理,这增加了数据预处理的复杂度。
常用场景
经典使用场景
在医学影像分析领域,vlm-project-with-images-with-bbox-images-v5数据集因其包含丰富的标注信息和多语言支持,成为视觉语言模型(VLM)训练与评估的重要资源。该数据集通过提供带有边界框标注的医学影像,以及多语言问答对,为跨模态学习任务提供了标准化的实验平台。研究人员可以基于此数据集开发能够同时理解医学影像内容和多语言文本的智能系统。
实际应用
在实际医疗场景中,该数据集支持开发智能辅助诊断系统。基于其标注的医学影像和多语言问答数据,可以训练出能够自动识别病灶区域、回答医生多语言咨询的AI助手。这种技术能够提升医疗资源匮乏地区的诊断效率,同时为跨国医疗协作提供语言无障碍的技术支持,具有重要的临床实用价值。
衍生相关工作
该数据集已催生多项医学视觉语言建模的经典研究。包括基于边界框引导的病灶检测算法、多语言医学问答系统等创新工作。部分研究进一步扩展了数据集的用途,开发出能够同时处理影像分割和多语言报告生成的端到端系统,推动了医学人工智能从单一模态向多模态协同理解的范式转变。
以上内容由遇见数据集搜集并总结生成


