
遇见数据集

LiteFold/FireProtDB

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

FireProtDB 2.0是一个大规模手动策划的蛋白质稳定性数据库,专注于热稳定蛋白质数据,这些数据在生物医学和生物技术应用中至关重要。该数据库从多个来源聚合稳定性数据,解决了天然蛋白质在温和条件下进化、实验室实验改进蛋白质稳定性耗时且昂贵的问题。作为计算方法的廉价且可扩展的替代方案,它提高了数据可靠性。相比前一版本,FireProtDB 2.0引入了新的数据存储和维护方法,支持与野生型、突变体、蛋白质结构域和从头设计蛋白质测量相关的绝对和相对数据类型。此外,数据库从仅限于单点突变扩展到包括插入、删除和多点突变等更复杂数据,从而将实验数量从16,000增加到近5,500,000。更新后的抽象方案完全可扩展,可添加新测量和注释而无需重构,同时通过固定标识符和历史跟踪遵循FAIR原则。

FireProtDB 2.0 is a large-scale manually curated database aggregating protein stability data from multiple sources, with a focus on thermostable proteins that are crucial in biomedical and biotechnological applications. It addresses the limitations of naturally occurring proteins evolved for mild conditions and the laborious, expensive nature of laboratory experiments for improving protein stability, providing a cheap and scalable alternative for computational methods. Building upon its predecessor, the second version introduces a new approach to data storage and maintenance, enabling both absolute and relative data types connected with measurements of wild-types, mutants, protein domains, and de novo designed proteins. Furthermore, it expands from single-point mutations to include more complex data such as insertions, deletions, and multiple-point mutations, increasing the database size from 16,000 to nearly 5,500,000 experiments. The updated abstract scheme is fully expandable with any new measurements and annotations without restructuring, and it adheres to FAIR principles through fixed identifiers and history tracking.
提供机构:
LiteFold
搜集汇总
数据集介绍
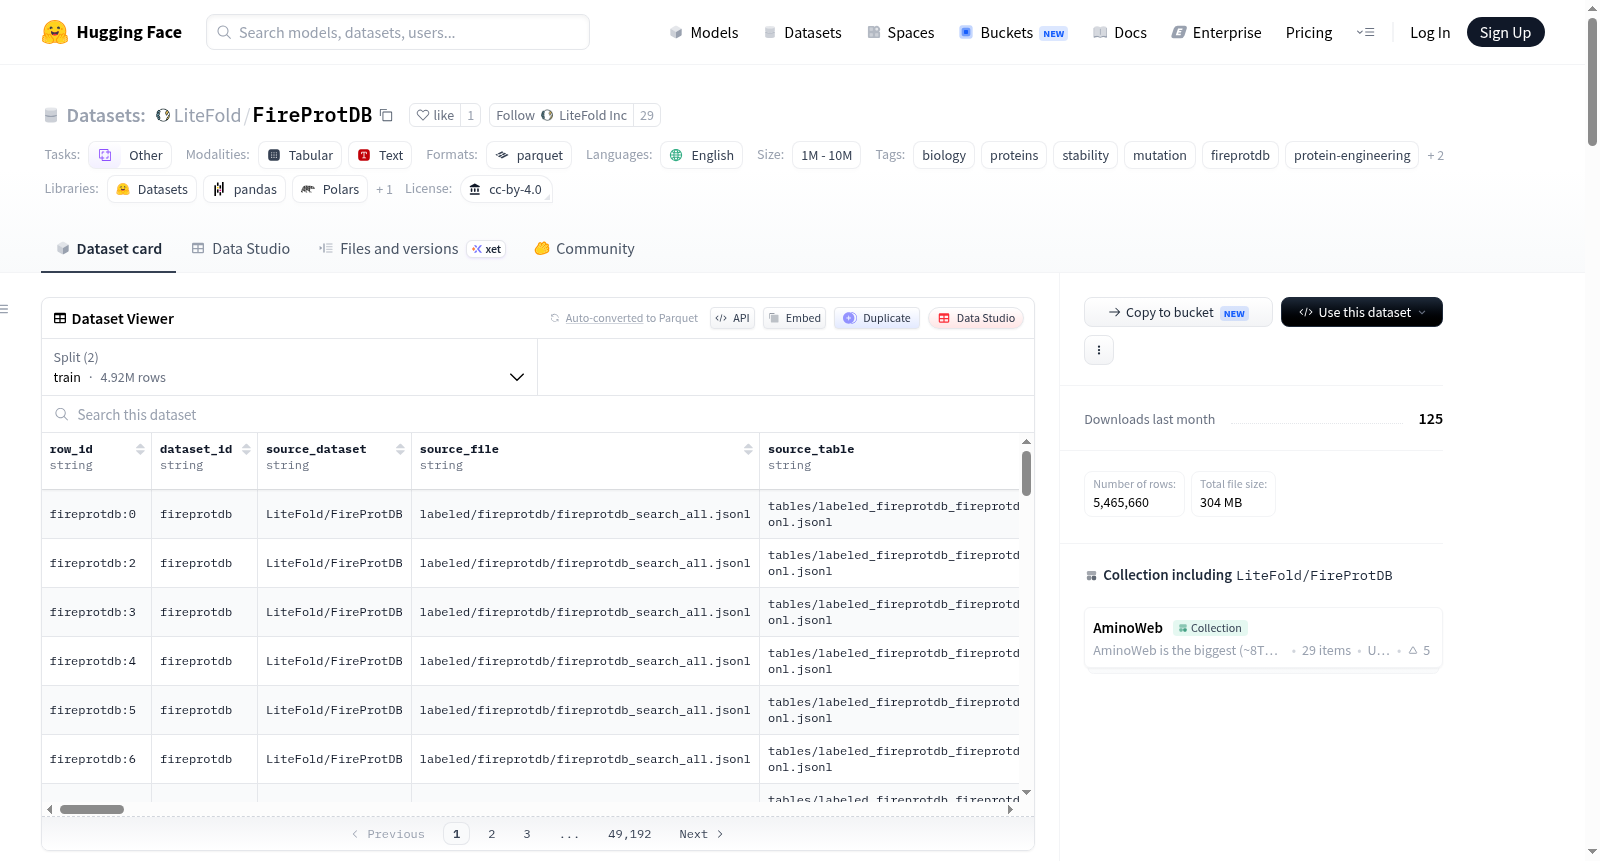
LiteFold/FireProtDB 数据集图片
构建方式
FireProtDB 2.0 通过整合来自 Domainome DDG、MegaScale、ProTherm 等多个公开数据库的蛋白质稳定性实验数据构建而成。数据存储采用全新的抽象模式,支持野生型、突变体、蛋白质结构域及从头设计蛋白的绝对与相对测量值,并扩充了插入、缺失及多位点突变等复杂突变类型。通过大规模诱变数据的纳入,数据集规模从最初的 16,000 条实验激增至约 550 万条,同时保留源行标识符的确定性分割机制(基于行 ID 的哈希值分配),确保训练集与测试集的可重复性。
特点
该数据集包含超过 546 万行记录、99 列特征,涵盖突变、序列、结构及实验测量等丰富维度。其核心特点在于支持多种测量类型(如 ΔTm、ΔΔG、适应性得分等),并提供了标量列与完整的 JSON 测量记录。数据集遵循 FAIR 原则,通过固定标识符和历史追踪实现可扩展性,同时兼容单点与多位点突变、插入缺失等复杂事件,成为蛋白质稳定性研究领域规模最大、注释最全面的资源之一。
使用方法
用户可通过 HuggingFace `datasets` 库直接加载 FireProtDB,例如 `load_dataset("LiteFold/FireProtDB")` 获取训练集与测试集,支持按分割直接加载、按测量类型过滤缺失值(如 `row["ddg"] is not None`),以及流式读取以节省内存。数据集以 Parquet 格式存储,提供丰富的列组(如来源、序列、突变、结构、实验测量及出版物元数据),便于针对蛋白质工程、稳定性预测等任务进行灵活的查询与建模。
背景与挑战
背景概述
蛋白质热稳定性在生物医学与生物技术应用中至关重要,但天然蛋白质通常仅在温和条件下发挥功能,实验室实验提升其稳定性既费力又昂贵。计算方法的兴起为突破这一瓶颈提供了低成本、可扩展的替代方案,但其可靠性仍受限于高质量数据的匮乏。FireProtDB 2.0由捷克马萨里克大学Loschmidt实验室的Milos Musil等人于2025年创建,是一个大规模蛋白质稳定性数据库,整合了来自多个来源的实验数据,涵盖单点突变、插入、缺失及多点突变,记录数从最初的1.6万激增至近550万。该数据库遵循FAIR原则,支持绝对与相对测量数据,并具备完全可扩展的抽象架构,为蛋白质工程领域的理论建模与算法开发提供了坚实的数据基石,显著推动了稳定性预测研究的进展。
当前挑战
该数据集所解决的领域核心挑战在于蛋白质稳定性预测任务中高质量训练数据的稀缺性,传统实验方法成本高昂且通量有限,制约了机器学习模型的发展。FireProtDB通过聚合ProTherm、MegaScale等来源,构建了包含550万条突变记录的庞大数据集,覆盖插入、缺失及多点突变等复杂类型,有效缓解了数据稀疏问题。然而,构建过程中面临多重挑战:首先,来自不同来源的数据存在测量类型、条件及格式的高度异质性,需统一标准化;其次,大规模深度突变扫描的引入(如Domainome DDG的400余万条记录)带来了数据清洗与质量控制的巨大压力;此外,需确保数据版本可追溯性与固定标识符符合FAIR原则,以避免重复与歧义。
常用场景
经典使用场景
在蛋白质工程与计算生物学领域,FireProtDB 2.0作为目前规模最为宏大的蛋白质稳定性数据库之一,常用于训练和评估预测蛋白质突变后热稳定性变化的深度学习模型。研究人员可基于其提供的逾540万条实验记录,涵盖单点突变、插入、缺失及多点突变等多种突变类型,构建从序列或结构到稳定性指标(如ΔTm、ΔΔG)的映射关系。该数据库内置的确定性训练-测试划分,确保了模型评估的可重复性与公平性,因而被广泛用于开发可泛化至未见蛋白质的稳定性预测器,推动从头设计蛋白及定向进化策略的发展。
衍生相关工作
FireProtDB 2.0的发布直接催生了一系列下游研究工作。基于该数据集的预测模型如ThermoNet与MutCompute2.0,利用其提供的丰富突变与结构特征训练图神经网络,实现了对蛋白质稳定性变化的精准预测。同时,该数据库被用作基准测试集,评估了不同预训练蛋白质语言模型(如ESM-1b、ProtBERT)在零样本稳定性预测任务中的表现。此外,针对数据集内嵌的领域知识,研究者开发了可解释性框架,用以解析氨基酸置换如何通过改变局部疏水核心与氢键网络来影响整体稳定性,进一步推动了计算蛋白质设计的前沿探索。
数据集最近研究
最新研究方向
当前,蛋白质稳定性数据集的构建正从单一突变向复杂突变谱系演进,FireProtDB 2.0的发布标志着该领域迈入大规模、高质量数据驱动的新阶段。该数据库融合了来自Domainome、MegaScale、ProTherm等权威源的数据,将实验记录从1.6万条扩展至逾550万条,并首次系统性地纳入了插入、缺失及多点突变事件,为深度学习模型预测蛋白质热稳定性提供了前所未有的数据基础。其采用FAIR原则设计的抽象存储架构,支持灵活扩展与历史追溯,不仅推动了蛋白质工程中机器学习方法的可靠性和泛化能力提升,更与近期AI辅助蛋白设计、定向进化等热点研究紧密契合,为精准生物制造和新型生物催化剂的开发注入了关键数据动能。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

