
遇见数据集

SPADE-Grounding-Corpus-Games-15K

收藏
Hugging Face2026-08-26 更新2026-08-27 收录
官方服务:

资源简介:

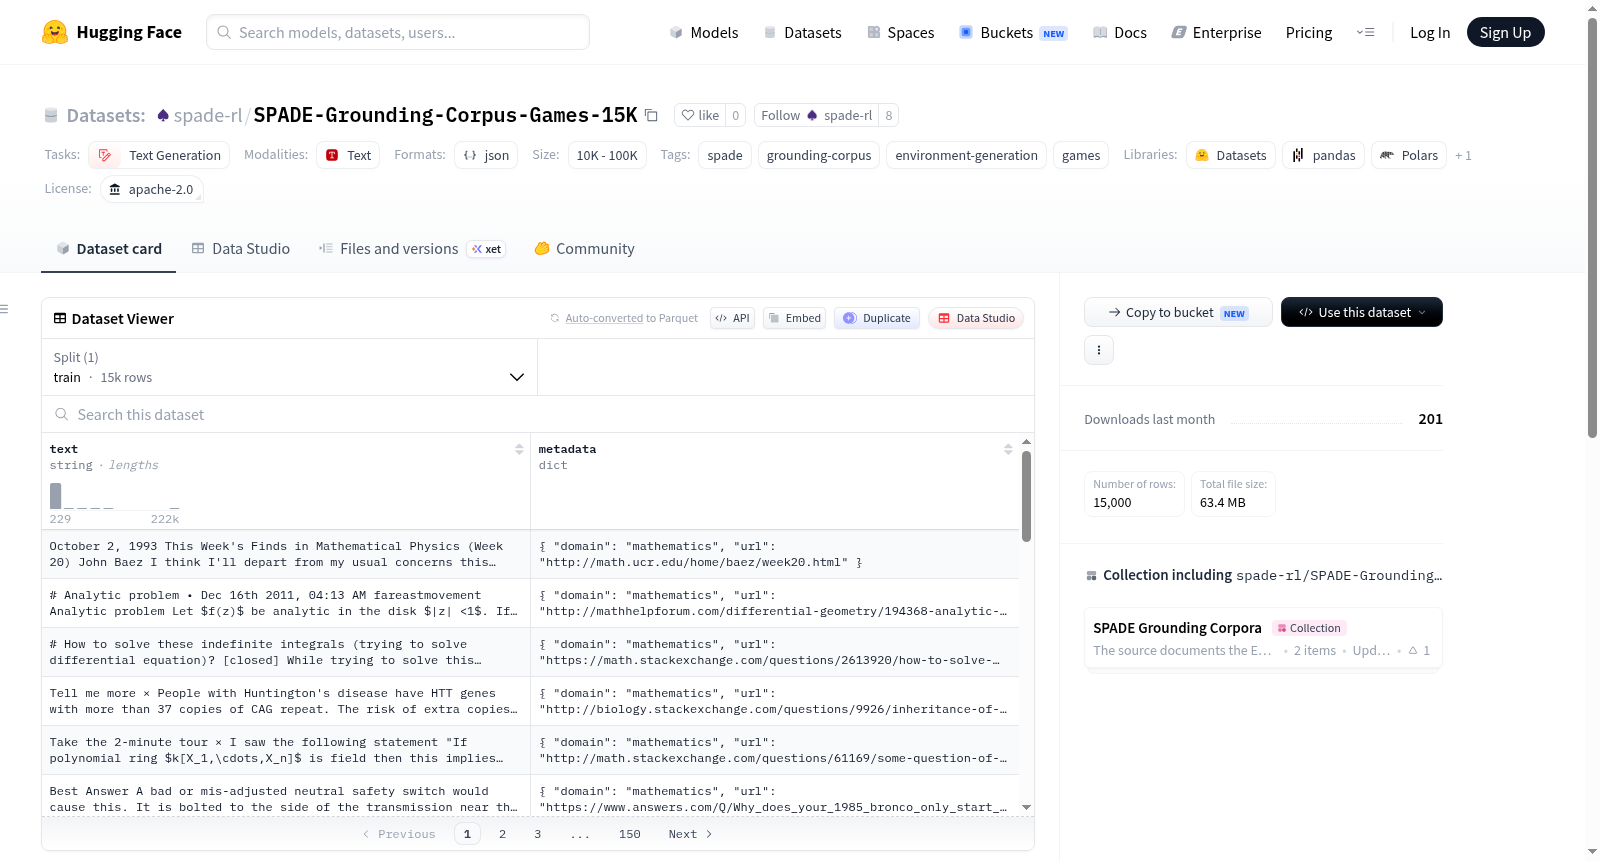
SPADE 基础语料库(游戏版)是一个包含 15,000 个文档的数据集,用于为认知技能游戏环境生成提供基础支撑。该语料库中,10,000 个文档来自数学语料库,5,000 个来自科学语料库。每个文档被嵌入到生成提示中,使得提议者生成的环境能够锚定在真实的概念或技术之上,而非自由联想。数据集包含两个字段:text(文档的原始文本,与生成提示中的内容完全一致)和 metadata(包括 domain 字段,值为 mathematics 或 science;以及 url 字段,表示来源出处)。该数据集适用于文本生成任务,特别是与游戏环境生成相关的场景。

SPADE Base Corpus (Game Edition) is a dataset containing 15,000 documents designed to provide grounding for cognitive skill game environment generation. Among them, 10,000 documents are from the mathematics corpus and 5,000 from the science corpus. Each document is embedded into a generation prompt to anchor the proposed environment in real concepts or technologies rather than free association. The dataset contains two fields: text (the original text of the document, exactly as in the generation prompt) and metadata (including the domain field with values mathematics or science, and the url field indicating the source). This dataset is suitable for text generation tasks, particularly those related to game environment generation.

创建时间:
2026-08-20
原始信息汇总

数据集概述

该数据集为 SPADE grounding corpus — games (15k),是一个用于支撑认知技能游戏环境生成任务的参考语料库。

基本信息

  • 许可证:Apache 2.0
  • 任务类型:文本生成
  • 标签:spade、grounding-corpus、environment-generation、games
  • 配置文件default(数据文件为 data.jsonl

数据规模与设置

  • 文档总数:15,000 篇
  • 环境设置games(游戏环境)

数据构成

  • 10,000 篇 来源于数学语料库
  • 5,000 篇 来源于科学语料库

字段说明

字段 描述
text 文档内容,与嵌入生成提示中的文本完全一致
metadata 包含 domain(领域,取值为 mathematicsscience)和 url(来源链接,提供溯源信息)

用途说明

每个生成提示中会嵌入一篇抽样文档,从而确保提议者生成的游戏环境能够锚定于真实的概念或技术,而非自由联想。该语料库与同时发布的生成环境数据配对使用。
搜集汇总
数据集介绍
SPADE-Grounding-Corpus-Games-15K 数据集图片
构建方式
该数据集是SPADE项目中用于生成认知技能游戏环境的参考文档集。构建方式为从数学和科学两大领域语料库中精心筛选,共整合15,000篇高质量文档,其中数学领域10,000篇,科学领域5,000篇。每篇文档以原始文本形式嵌入生成提示中,并附带元数据,包括所属领域(数学或科学)及来源URL,确保内容可追溯且与真实概念或技术紧密关联。其构建旨在为生成式模型提供坚实的知识基础,避免凭空联想,从而提升生成环境的教育价值与准确性。
特点
该数据集具有鲜明的领域针对性和结构清晰性。其内容横跨数学与科学两大核心学科,涵盖广泛的概念与技术,为生成多样化的游戏环境提供丰富素材。每份文档均附带领域标注与来源链接,便于使用者进行溯源与筛选。尤为突出的是,其与生成环境紧密配合的设计理念——每份文档对应一个生成提示,确保生成的游戏环境始终锚定于真实知识,摒弃无根据的自由发挥,从而保障了教育内容的可靠性与专业性。
使用方法
使用者可直接通过HuggingFace数据集加载接口获取默认配置,数据集以JSONL格式存储于data.jsonl文件中。每一条记录包含文本字段和元数据字段,文本字段即完整文档内容,可直接嵌入生成提示;元数据字段提供了领域和URL信息,便于进行条件筛选或来源验证。该数据集专为文本生成任务设计,尤其适用于需要基于知识增强的生成场景,如教育游戏环境生成。研究者可将其与配套生成的游戏环境数据结合使用,以训练或评估模型的生成质量与知识一致性。
背景与挑战
背景概述
SPADE-Grounding-Corpus-Games-15K数据集由SPADE项目团队构建,旨在为认知技能游戏环境生成提供坚实的知识基础。该数据集包含15,000篇文档,其中10,000篇来自数学领域,5,000篇来自科学领域,于近年发布,以支持生成模型在游戏环境设计中的概念锚定。其核心研究问题在于如何通过引入外部知识语料,增强生成内容的事实性和领域相关性,从而避免自由联想导致的偏差。该数据集在人工智能教育应用和程序化内容生成领域具有显著影响力,为后续研究提供了标准化的评测基准和训练资源。
当前挑战
该数据集面临的挑战主要源于其应用场景和构建过程。在领域问题上,生成式模型在创作教育游戏环境时,常因缺乏领域知识而输出不准确或无关内容,SPADE-Grounding-Corpus-Games-15K通过显式文档嵌入提示词来缓解这一难题,但仍需应对文档与生成内容间的语义对齐复杂性。在构建过程中,挑战包括从数学和科学语料中筛选高质量、覆盖面广的文档,确保来源可靠且版权合规,同时平衡两个领域的数据比例,以及设计元数据(如域名和URL)以支持可追溯性和可复现性,这些步骤均需大量人工审核与质量控制,成本高昂。
常用场景
经典使用场景
SPADE-Grounding-Corpus-Games-15K数据集作为SPADE框架中提议者生成认知技能游戏环境时的知识锚点,其经典使用场景聚焦于条件文本生成任务,特别是将外部知识库中的文档作为提示输入,驱动生成模型产出真实、可追溯的游戏环境描述。该数据集包含15,000篇文档,其中10,000篇源自数学语料库,5,000篇源自科学语料库,每篇文档均附有领域标签与来源URL,旨在保障生成内容扎根于具体学科概念或技术,而非凭空臆造。在文本生成任务的评估中,该数据集常被用作基准语料,以检验模型在知识引导下的生成质量、忠实度以及多样性,其设计理念体现了检索增强生成(RAG)思想在创意任务中的实践,成为连接抽象知识库与具象环境生成之间的桥梁。
实际应用
在实际应用中,该数据集可直接赋能智能教育平台,用于自动化生成贴合教学大纲的数学和科学认知训练游戏,依据文档内容动态构建游戏关卡、谜题或挑战场景,从而替代人工设计,大幅提升内容生产效率与个性化水平。此外,它也适用于开发寓教于乐的学习辅助工具,通过锚定真实概念生成互动环境,增强学习者的沉浸感与知识迁移能力。在游戏产业中,该语料可驱动程序化内容生成(PCG)系统,快速产出主题多变、知识丰富的游戏世界,降低设计成本。同时,其元数据中的领域标签与来源可支持内容筛选与溯源,满足教育产品对内容合规性和质量监控的需求,展现出从研究原型到产业部署的转化潜力。
衍生相关工作
基于此数据集,学术界已衍生出一系列相关研究,涵盖知识基元抽取与表示学习,旨在从文档中提炼可复用的游戏环境构建模块;同时催生了检索增强生成模型的改进探索,如设计更精准的文档选择策略或融合多文档信息的生成框架,以提升环境生成的连贯性与创新性。此外,该语料推动了跨领域迁移学习的发展,研究者利用数学与科学文档的差异,训练模型在不同知识域间灵活切换,促进通用生成能力的提升。在评估方面,相关工作构建了忠实度与多样性等自动评测指标,并建立与人类判断对齐的基准,为后续工作提供了可量化的比较基础。这些衍生工作不仅深化了SPADE框架本身,也为知识驱动的内容生成方向开拓了新的研究路径,持续推动着相关领域的演化与繁荣。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

