
遇见数据集

dataset-multilingue-750k

收藏
Hugging Face2026-07-24 更新2026-07-27 收录
官方服务:

资源简介:

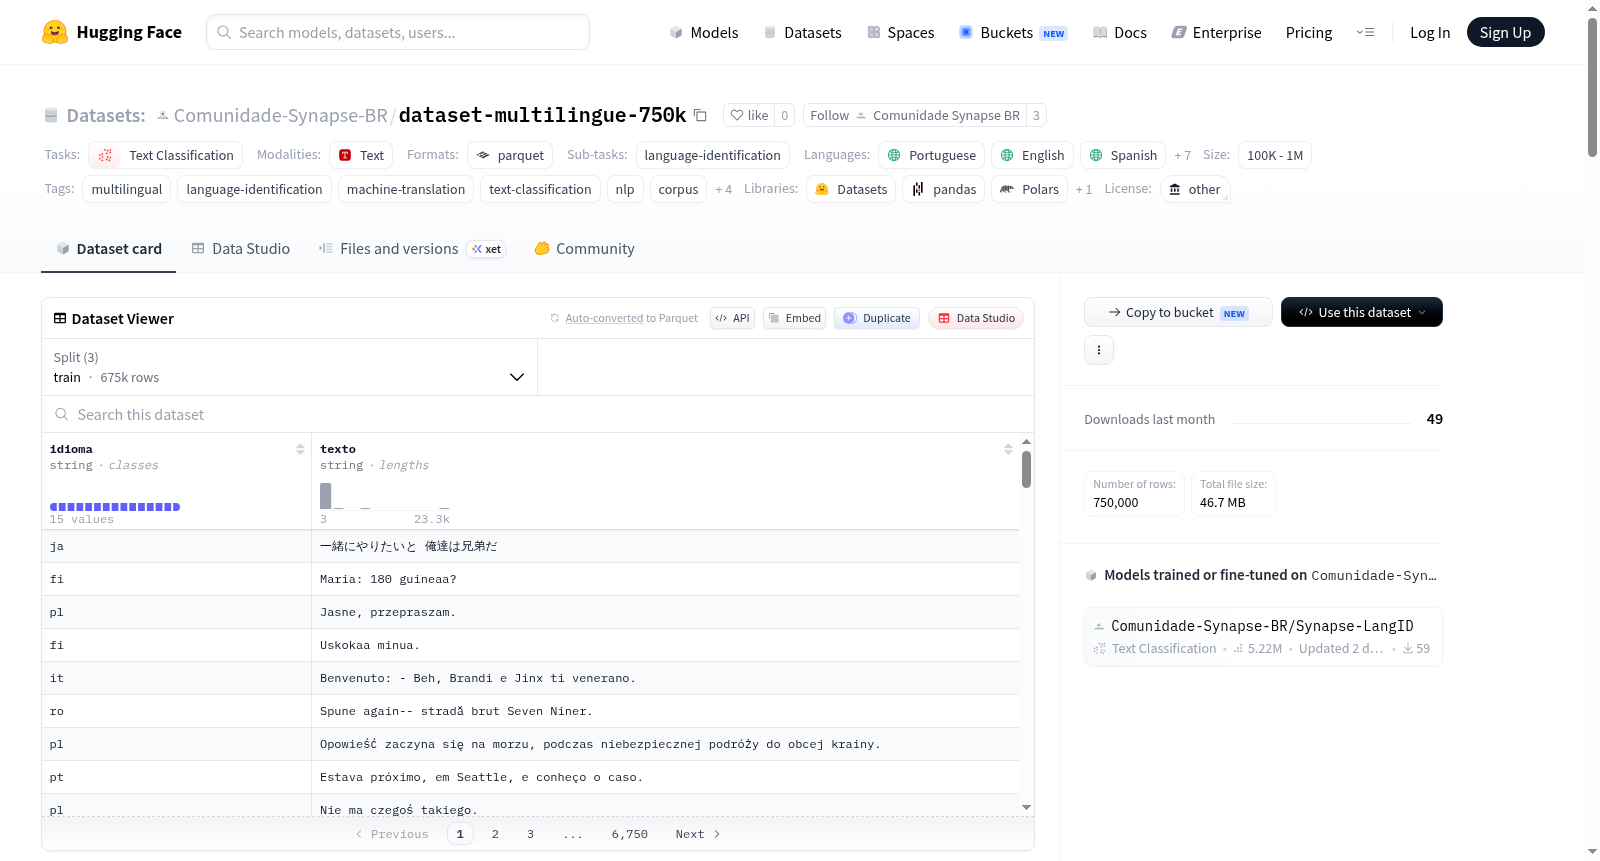
Synapse多语言数据集是一个基于OPUS-100构建的高质量多语言平行语料库,专为自然语言处理任务设计。该数据集包含10种语言:葡萄牙语(pt)、英语(en)、西班牙语(es)、法语(fr)、意大利语(it)、德语(de)、阿拉伯语(ar)、丹麦语(da)、捷克语(cs)和希腊语(el)。数据总量为75万个样本,采用JSONL格式,并以Apache-2.0许可证发布。数据集已划分为训练集(675,000个样本)、验证集(37,500个样本)和测试集(37,500个样本),划分过程随机进行以避免数据泄露。每个数据样本包含两个字段:idioma(语言代码)和texto(文本内容)。所有数据均经过清洗、标准化和去重处理,包括移除重复项、规范化空格、清理无效字符以及随机打乱。该数据集适用于多种NLP任务,如语言识别、机器翻译、多语言模型微调与预训练、文本分类以及多语言模型的基准测试。数据集由Synapse BR社区维护,是其开源自然语言处理资源计划的一部分。

The Synapse multilingual dataset is a high-quality multilingual parallel corpus built based on OPUS-100, specifically designed for natural language processing tasks. It includes 10 languages: Portuguese (pt), English (en), Spanish (es), French (fr), Italian (it), German (de), Arabic (ar), Danish (da), Czech (cs), and Greek (el). The total data volume is 750,000 samples, stored in JSONL format, and released under the Apache-2.0 license. The dataset is divided into a training set (675,000 samples), a validation set (37,500 samples), and a test set (37,500 samples), with the division performed randomly to prevent data leakage. Each data sample contains two fields: idioma (language code) and texto (text content). All data has undergone cleaning, standardization, and deduplication, including removal of duplicates, normalization of spaces, cleaning of invalid characters, and random shuffling. This dataset is suitable for various NLP tasks, such as language identification, machine translation, multilingual model fine-tuning and pre-training, text classification, and benchmarking of multilingual models. It is maintained by the Synapse BR community as part of its open-source natural language processing resource initiative.
创建时间:
2026-07-24
搜集汇总
数据集介绍
dataset-multilingue-750k 数据集图片
构建方式
该数据集源自OPUS-100大规模平行语料库,经过精细的预处理流程构建而成。具体而言,构建过程涵盖了重复记录的消除、空白字符的规范化、无效字符的清洗,以及样本的随机打乱。最终,数据被划分为训练集(675,000条)、验证集(37,500条)与测试集(37,500条),以确保各子集之间无数据泄漏,从而为模型训练与评估提供可靠基础。
特点
Synapse Multilingual Dataset共计包含750,000条文本样本,横跨10种语言,包括葡萄牙语、英语、西班牙语、法语、意大利语、德语、阿拉伯语、丹麦语、捷克语与希腊语。每个样本均由“idioma”(语言标签)与“texto”(文本内容)两个字段构成,格式简洁统一。数据集支持多语种分类、语言识别、机器翻译等多种任务,尤其在多语言自然语言处理研究与轻量级模型微调方面展现出极高的适用性与灵活性。
使用方法
用户可通过Hugging Face的datasets库便捷加载该数据集,只需调用load_dataset函数并指定存储库名称即可。加载后,数据以字典形式呈现,可通过索引访问训练集、验证集或测试集中的样本。该数据集适用于语言自动识别、文本分类、机器翻译及多语种模型的微调与预训练,同时可用作多语言自然语言处理算法的基准测试资源,支持研究人员进行广泛的实验与优化。
背景与挑战
背景概述
多语言自然语言处理(NLP)作为人工智能领域的核心方向,长期以来受制于高质量、大规模且覆盖广泛语言的标注语料匮乏。为此,由巴西Synapse社区于近年创建的Synapse Multilingual Dataset(即dataset-multilingue-750k)应运而生,旨在为多语言研究与模型训练提供坚实的数据基础。该数据集源自知名平行语料库OPUS-100,经过精细的去重、标准化与清洗,最终整合了葡萄牙语、英语、西班牙语、法语、意大利语、德语、阿拉伯语、丹麦语、捷克语和希腊语等十种语言共计75万条文本样本,并严格划分训练、验证与测试集以防止数据泄露。其出现不仅填补了小型多语言语料库在语言识别与机器翻译任务的资源空白,也为后续轻量级多语言模型的预训练与微调提供了重要基准,对推动巴西乃至全球多语言NLP社区的发展具有深远影响。
当前挑战
该数据集所应对的领域核心挑战在于:如何高效、准确地从海量混合文本中自动识别语言归属,并支持跨语言翻译任务的稳健训练。传统单语数据集难以覆盖语言多样性,而多语语料常因噪声、不平衡或语种遗漏而限制模型泛化能力。构建层面,团队面临三重挑战:首先,从OPUS-100原始语料中提取并统一处理十种不同书写体系(如拉丁字母与阿拉伯字母)的文本,需解决编码与字符规范化问题;其次,确保数据清洗过程中不丢失语义完整性,同时去除格式错误与重复项,以维持高质量;最后,精心划分75万样本为训练集(67.5万)、验证集(3.75万)与测试集(3.75万),并平衡各语种分布,避免因语料不均衡导致模型偏向高频语言。这些努力为多语言NLP研究奠定了可靠数据基石。
常用场景
经典使用场景
该数据集涵盖十种语言的75万条平行文本,广泛应用于多语言自然语言处理研究。在语言识别任务中,研究者利用其标注的语种标签训练分类模型,实现对未知文本来源的精准判别。此外,该数据集还可用于机器翻译系统的预训练与评估,支持从单一语言对扩展至多语言翻译模型的开发。其结构化的训练、验证与测试划分,为跨语言文本分类、多语言模型微调及轻量级模型预训练提供了标准化的评测基准,推动了多语言NLP领域的实验可重复性。
衍生相关工作
该数据集的衍生工作聚焦于多语言模型的效率优化与泛化探索。基于其语料,研究者开发了专用于语言识别的轻量级Transformer模型(如Synapse-LI),在保持高精度的前提下大幅降低参数量。部分工作将其与元学习框架结合,尝试在少量样本下识别未见过的语言变体。另有研究利用该数据集构建跨语言的情感分析基准,验证多语言BERT变体在十个语言上的迁移效果。此外,社区中出现了针对葡萄牙语、希腊语等特定语言的增强版本,通过加入方言数据进一步拓展了原始数据的应用边界。
数据集最近研究
最新研究方向
该数据集聚焦于多语言自然语言处理的前沿探索,尤其在低资源语言的自动识别与跨语言迁移学习领域展现出重要潜力。基于OPUS-100语料库的精细构建,它覆盖了葡萄牙语、阿拉伯语、希腊语等10种语言的平行语料,为跨语言模型的多任务训练提供了标准化基础。近期研究热点包括结合Transformer架构进行语言身份验证、优化机器翻译中的语种混合鲁棒性,以及推动开源社区在巴西等葡语区域的NLP工具链发展。该数据集的发布有效回应了多语言基准测试中对中低资源语料的迫切需求,对促进非英语世界的人工智能技术普惠具有里程碑意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

