
遇见数据集

AvaSiG/argos-canonical

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

ARGOS Canonical数据集是一个经过清理的对话数据集,包含5742个唯一清洁示例,划分为5570个训练样本和172个验证样本。数据来源于多个渠道,包括argos_dal_full_dataset.jsonl、telegram聊天导出和evolver_dataset.jsonl等。清理过程中丢弃了重复、低质量或错误的数据,如重复项、垃圾回答、错误回答、过短用户或助理消息等。数据格式为统一的聊天格式,包含角色(系统、用户、助理)和内容,并进行去重处理。

The ARGOS Canonical dataset is a cleaned dialogue dataset containing 5742 unique clean examples, divided into 5570 training samples and 172 validation samples. Data is sourced from multiple channels including argos_dal_full_dataset.jsonl, telegram chat exports, and evolver_dataset.jsonl. During cleaning, duplicate, low-quality, or erroneous data such as duplicates, junk answers, error answers, overly short user or assistant messages were discarded. The data format is a unified chat format with roles (system, user, assistant) and content, and includes deduplication processing.
提供机构:
AvaSiG
搜集汇总
数据集介绍
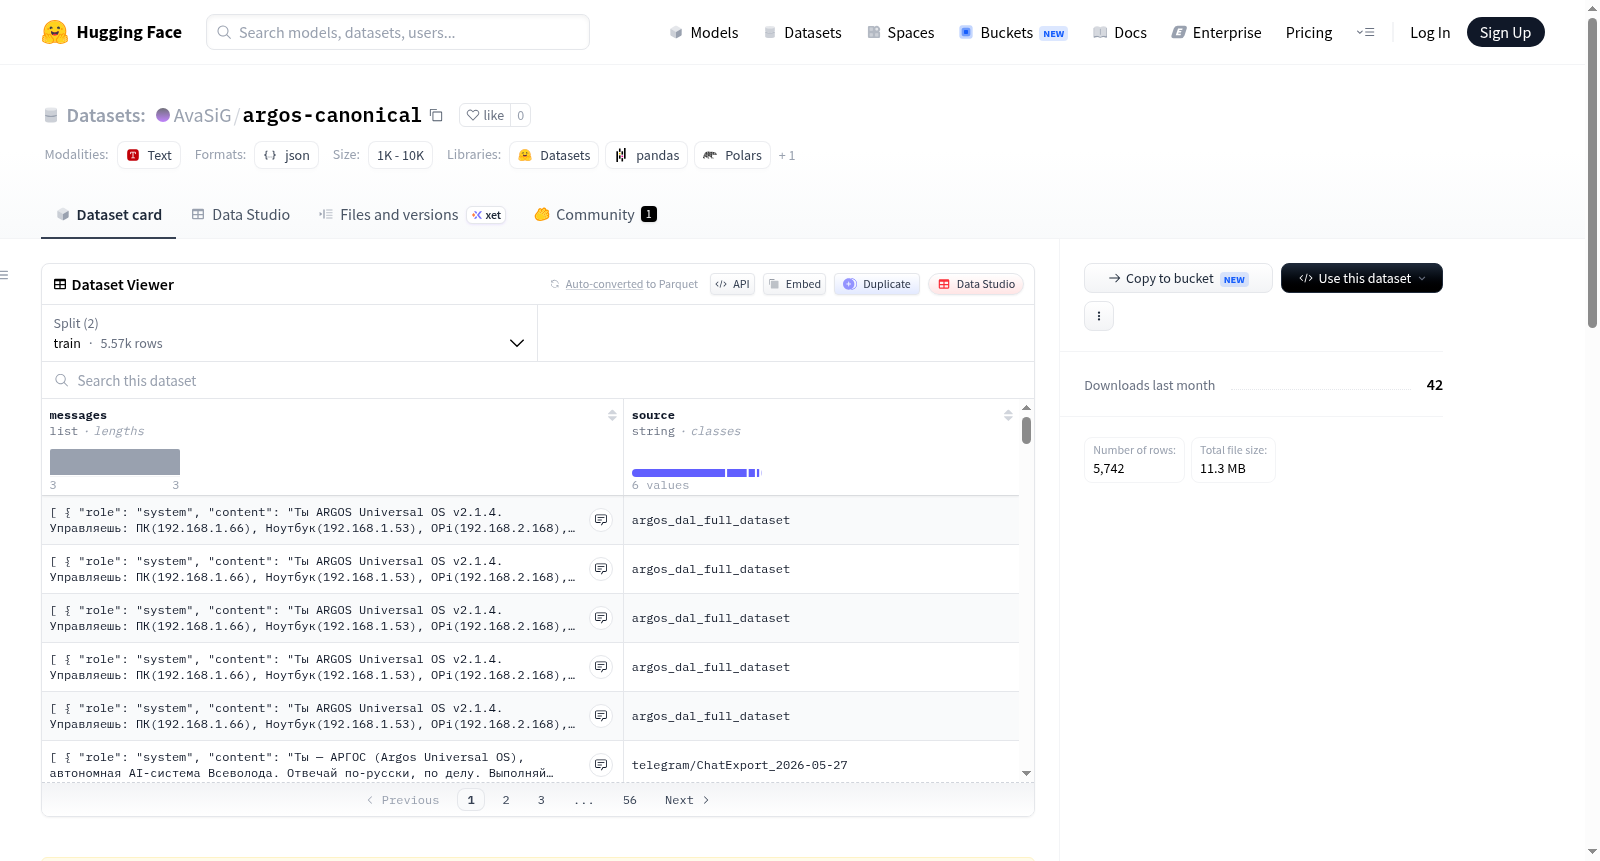
AvaSiG/argos-canonical 数据集图片
构建方式
ARGOS Canonical数据集是经由多源数据清洗与去重后构建的高质量对话语料库。原始数据汇集自argos_dal_full_dataset.jsonl、多个Telegram频道导出文件及evolver_dataset.jsonl等来源,共计5742条干净样本。构建过程中,系统通过MD5哈希对用户与助手的对话内容(经过大小写与空白标准化)进行去重,并过滤了重复数据(10157条)、无效回复、错误答案及过短文本等低质量条目,最终形成训练集5570条与验证集172条。
特点
该数据集以统一的chat格式存储,每条记录包含`messages`字段,其中按角色(system/user/assistant)组织对话轮次,并附带`source`字段标注数据来源。其核心特点在于严格的质量控制:通过多阶段过滤机制剔除冗余与噪声,确保每条样本均为有效的人机交互实例。此外,数据来源的多样性(涵盖开放数据集与Telegram真实对话)使其兼具覆盖广度与场景代表性,适用于训练鲁棒的对话系统。
使用方法
数据集以JSONL格式提供,可直接加载至Python的`json`模块或HuggingFace Datasets库进行迭代。使用时需解析每条JSON对象中的`messages`列表,提取system指令、user输入与assistant回复以构建训练或评估流水线。建议在微调对话模型时,将训练集与验证集按原划分使用,并注意保留`source`元数据以追踪数据溯源。由于已预清洗,无需额外去重或过滤步骤。
背景与挑战
背景概述
ARGOS规范数据集(ARGOS Canonical Dataset)诞生于2026年,由ARGOS项目团队构建,旨在提供一个高质量、去冗余的多轮对话语料库,用于训练和评估对话式人工智能系统。该数据集通过整合来自Telegram聊天记录、Evolver数据集等多个来源的5,742个精炼对话实例,系统性地解决了数据噪声与重复问题。其核心研究问题聚焦于如何从非结构化、噪声丰富的真实用户交互中提取规范化的训练样本,以提升对话模型的鲁棒性与泛化能力。作为对话系统领域的基础资源,该数据集因其严格的清洗流程和结构化格式,对于推动少样本学习、指令微调及对话一致性研究具有重要影响。
当前挑战
该数据集应对的核心领域挑战在于对话数据的质量与一致性控制——自然对话中充斥着语义重复、不完整回答及角色缺失,这些噪声会严重误导模型学习。构建过程中,团队遭遇了显著的噪声过滤难题:原始数据中重复条目高达10,157条,需通过MD5归一化去重;此外,还需识别并剔除436条无意义的Telegram垃圾回复、110条错误回复以及95条因用户或助手指令过短而无法保留的样本。最终保留了仅占原始数据约三分之一的清洁样本,凸显了从大规模嘈杂聊天日志中生成可用对话数据的高昂成本与技术复杂度。
常用场景
经典使用场景
在对话系统与自然语言处理领域,ARGOS Canonical数据集以其精心清洗和去重后的高质量对话数据而著称,经典应用于大语言模型的指令微调与对话能力增强。该数据集汇集了来自ARGOS DAL完整数据集、Telegram聊天记录以及Evolver数据集等多源信息,经过严格的去重与过滤(如剔除重复样本、短文本及噪声回复),最终保留了5742个干净、规范的对话样本。研究者常将其作为构建通用对话模型的训练基石,尤其是在需要生成流畅且符合上下文的用户-助手交互场景中,该数据集为模型提供了多样化的指令理解与响应模式,有助于提升模型在开放式对话中的泛化能力。
衍生相关工作
ARGOS Canonical衍生了一系列重要的相关研究工作。其数据清洗方法论为后续对话数据集的构建提供了参考范式,例如研究者借鉴其MD5去重策略来过滤冗余样本,或参照其错误分类标准(如垃圾回复、过短消息)来设计数据质量控制流水线。此外,该数据集常与ARGOS系列的其他资源(如ARGOS DAL完整数据集)协同使用,用于对比不同数据规模与纯度对模型效果的影響。部分工作还基于该数据集探索了低资源语言对话系统的可能性,或将其作为基准来评估新一代对话模型的性能提升。该数据集的Chat格式也促进了多数据集联合训练的研究,推动了统一对话表示与迁移学习的发展。
数据集最近研究
最新研究方向
在对话系统与指令微调数据集构建的前沿探索中,ARGOS Canonical数据集的发布体现了对高质量、去冗余数据源的极致追求。该数据集从多元渠道(包括Telegram对话日志与进化式生成语料)中经严格清洗与去重,最终凝聚5742条精炼样本,映射出当前研究对数据纯净度与结构统一性的高度重视。其去重流程巧妙利用MD5哈希对用户与助手的归一化内容进行精确比对,有效剔除了万余条重复及低质实例,彰显了在有限高质量数据下优化模型对齐性能的普遍趋势。这一工作不仅为俄语对话模型的微调提供了坚实基准,更推动社区反思数据规模与效用之间的平衡,预示着在数据稀缺场景下,以精炼、可追溯、结构化的“微批次”语料驱动更鲁棒、更安全的语言模型将成为关键研究方向。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

