
Kukedlc/arg-spanish-tts
收藏官方服务:
资源简介:
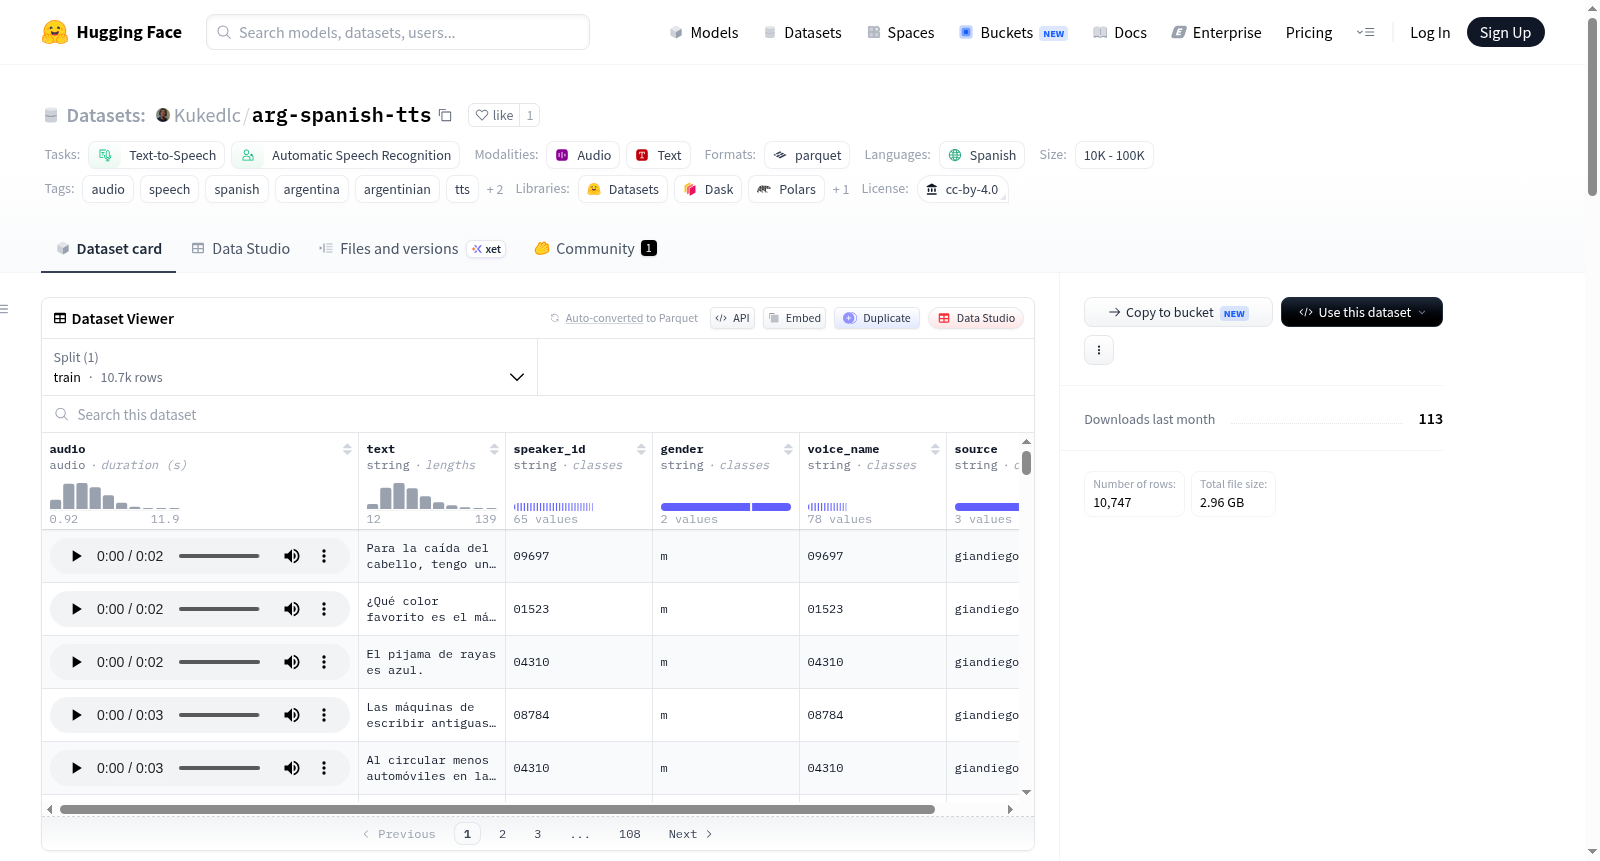
arg-spanish-tts是一个用于阿根廷西班牙语(es-AR)的统一、去重语音语料库,通过合并三个公共数据集(giandiego_ar、ylacombe和fabricio3g)并去除跨源重复项构建。所有音频已重采样为24 kHz单声道,包含10,747行数据、12.18小时总音频时长、65个独特说话人以及性别分布(女性7,419条,男性3,328条)。该数据集专为多说话人文本到语音(TTS)预训练设计,适用于在微调到目标声音之前进行模型训练,以提升单说话人训练效果。
arg-spanish-tts is a unified, deduplicated speech corpus for Argentine Spanish (es-AR), built by merging three public datasets and stripping cross-source duplicates. All audio is resampled to 24 kHz mono. It contains 10,747 rows, 12.18 hours of total audio, 65 unique speakers, and a gender split (female: 7,419, male: 3,328). Intended for multi-speaker TTS pre-training before fine-tuning to a target voice, a workflow that generally beats single-speaker training from scratch.
提供机构:
Kukedlc搜集汇总
数据集介绍
构建方式
arg-spanish-tts数据集是一个统一且去重后的阿根廷西班牙语语音语料库,通过融合三个公开数据集并剔除跨源重复样本构建而成。具体而言,数据集整合了GianDiego/latam-spanish-speech-orpheus-tts-24khz中筛选出的阿根廷国籍子集、ylacombe/google-argentinian-spanish的全部音频样本,以及fabricio3g/argentine-tts-4voices的四个说话人语音。在合并过程中,首先采用SHA-256对每段音频前8000个浮点样本进行哈希计算,剔除音频指纹重复的行;随后对经过归一化处理的文本与说话人ID组合进行匹配,移除相同说话人朗读相同文本的冗余样本。所有音频均被统一重采样至24 kHz单声道格式,最终获得包含10,747条音频记录、总时长约12.18小时的干净语料库。
特点
该数据集具有鲜明的区域性与实用性特征。语言上聚焦阿根廷西班牙语,包含65位独特说话人,音频总时长约12小时,性别分布为女性7,419条、男性3,328条,呈现一定的性别比例偏斜。数据集专为多说话人文本转语音预训练设计,其去重过程尤为严谨,通过音频哈希与文本-说话人双重过滤机制,有效消除了不同来源间的重复音频与相同说话人的重复文本,尤其解决了fabricio3g数据集几乎完全被ylacombe覆盖的问题。数据架构简洁清晰,每条记录包含音频、文本、说话人ID、性别、说话人名称及来源字段,便于下游任务灵活调用。
使用方法
建议采用两阶段训练策略使用该数据集。阶段一为多说话人预训练,利用完整12小时、65位说话人的音频数据训练模型,使其学习说话人无关的韵律特征,此阶段切勿将多个说话人ID合并为单一嵌入。阶段二为单说话人微调,在预训练模型基础上,使用目标说话人10至40分钟的干净音频进行精调,该流程通常优于从头开始的单说话人训练。数据集以CC-BY 4.0协议开源,用户可直接通过HuggingFace datasets库加载,并参考仓库中的可复现构建脚本进行定制化处理。
背景与挑战
背景概述
arg-spanish-tts数据集由研究团队于2024年创建,旨在为阿根廷西班牙语(es-AR)提供统一、去重的多说话人语音语料库,以弥补该方言在文本转语音(TTS)预训练领域的资源匮乏。该数据集通过合并三个公开语料库(giandiego_ar、ylacombe、fabricio3g)并去除跨源重复样本构建而成,涵盖65位独特说话人、总计12.18小时的24 kHz单声道音频。其核心研究问题在于,针对阿根廷西班牙语的TTS系统常因单说话人数据量有限而性能欠佳,多说话人预训练范式能够有效提升目标语音微调时的泛化能力。该数据集在拉丁美洲语音技术领域具有重要影响力,为低资源方言的TTS研发提供了可复现的基础资源。
当前挑战
数据集构建面临多重挑战:首先,在领域问题层面,阿根廷西班牙语作为低资源方言,缺乏高质量、多说话人的公开语音数据,导致TTS模型在语调和口音多样性上表现不足,且单一说话人训练易过拟合;其次,构建过程中需解决跨语料库的严重重复问题——例如fabricio3g数据集几乎完全包含于ylacombe中,研究者通过音频哈希(SHA-256)和文本-说话人ID双重去重策略,从12,070条原始数据中剔除1,323条重复样本;此外,音频需统一重采样至24 kHz并标准化转录文本,以确保多源数据兼容性,这些处理步骤共同保障了语料库的纯净度与实用性。
常用场景
经典使用场景
arg-spanish-tts数据集的核心用途在于构建多说话人文本转语音(TTS)系统的预训练基础。该数据集汇集了12小时、涵盖65位阿根廷西班牙语说话人的语音数据,统一采样至24kHz,经过精心去重处理,为研究者提供了一个高质量、低冗余的训练资源。其经典使用范式分为两阶段:首先利用全部数据对TTS模型进行多说话人预训练,使模型学习到与说话人无关的韵律和声学特征;随后,再针对目标说话人进行少量数据的微调。这一策略被广泛证实优于从零开始的单说话人训练,尤其在资源受限的场景下表现出显著优势。
实际应用
在实际应用层面,arg-spanish-tts数据集为构建面向阿根廷西班牙语用户的语音助手、有声书朗读、辅助沟通设备和个性化语音克隆服务提供了坚实基础。例如,通过基于该数据集预训练的模型,可以快速为企业或个人定制特定音色的TTS系统,用于客服机器人、车载导航、多语言学习平台等场景。其开放许可(CC-BY-4.0)和规范化构建流程,降低了技术落地门槛,使得小团队甚至独立开发者也能开发出接近商业级品质的语音合成应用,尤其有助于丰富西班牙语方言在智能设备中的可用性。
衍生相关工作
arg-spanish-tts数据集的出现,催生了若干经典衍生研究工作。首先,它可作为多说话人TTS基线模型(如VITS、FastSpeech 2、YourTTS)的预训练语料,验证模型在不同说话人数量下的泛化性能。其次,研究者利用该数据集探索了语音特征与说话人身份的解耦方法,推动了零样本说话人适配技术的进步。此外,基于该数据集还衍生出声纹识别、说话人验证和跨语言语音转换等领域的比较基准,促进了阿根廷西班牙语语音技术的系统化发展,并为其他低资源方言数据集建设提供了可复制的范式参考。
以上内容由遇见数据集搜集并总结生成


