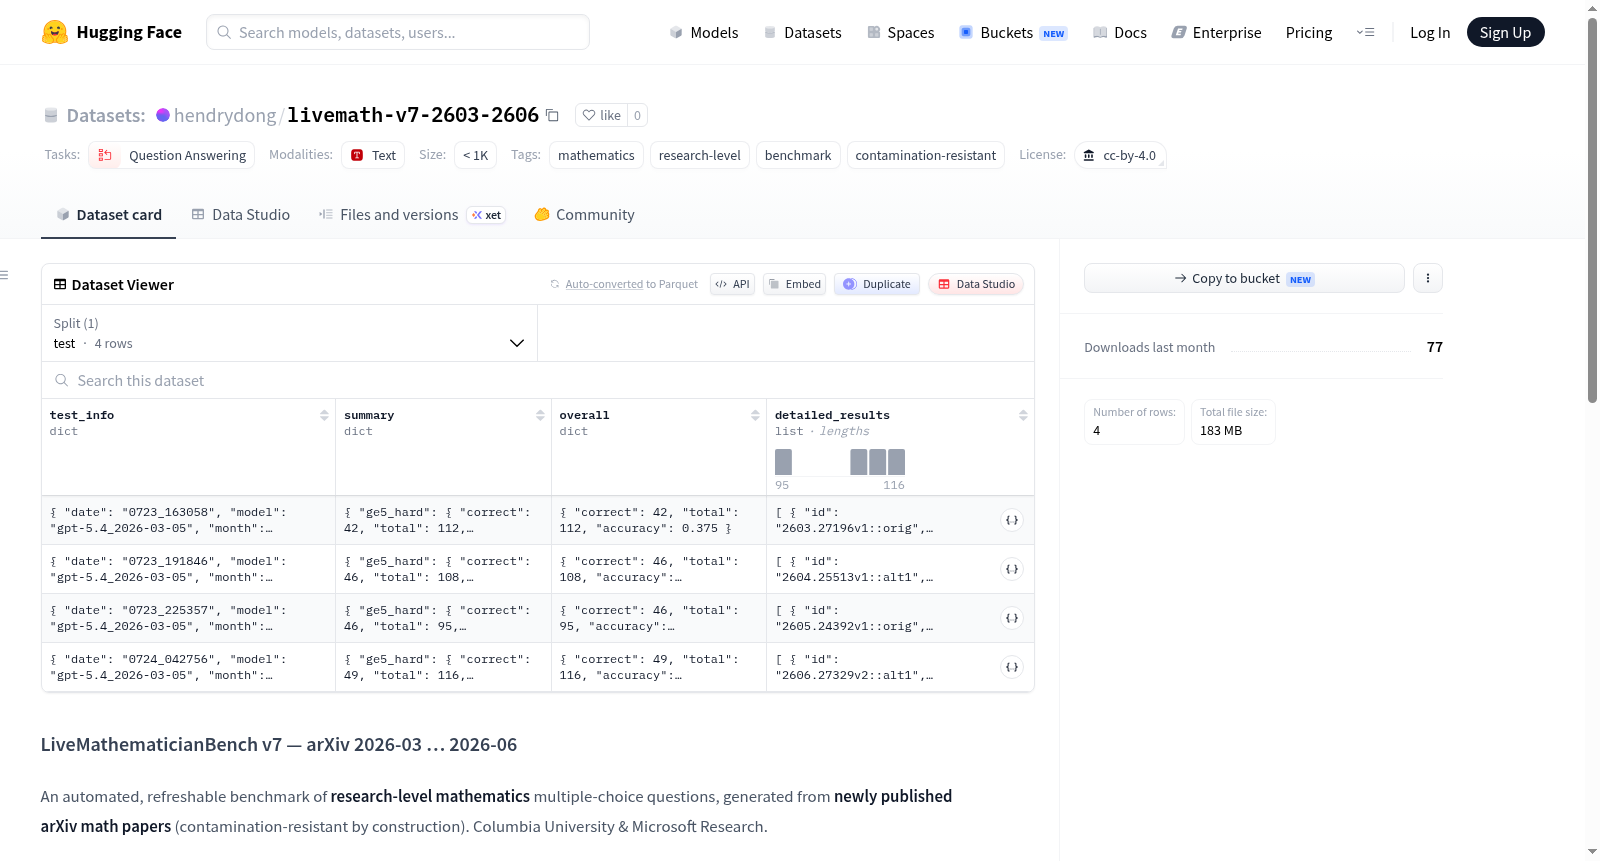
livemath-v7-2603-2606
收藏资源简介:
LiveMathematicianBench v7 是一个自动生成、可定期刷新的研究级数学多选题基准测试,专为评估前沿 AI 模型在高等数学推理能力而设计。该数据集由哥伦比亚大学和微软研究院联合创建,数据来源为 2026 年 3 月至 6 月期间新发表的 arXiv 数学论文。每个问题都基于一篇论文中的一个定理,干扰项则从该定理的证明草稿中对抗性生成,并通过多阶段难度流水线确保最终集合对最强模型也具有挑战性。数据集按月份组织,每个月份包含四个子集:所有生成的多选题(full/)、经过质量过滤(评分规则 ALS+TAS+GPS+DQS 总分≥5)的子集(ge5/)、最难的子集(hard/,每个源定理仅保留一个最难问题)以及独立的复测结果。共有 431 个 hard 级别问题,GPT-5.4(medium)在该子集上的准确率为 42.5%。该基准测试适用于衡量模型在数学问题理解、定理应用和推理方面的能力,尤其适合用于评估大型语言模型的数学推理水平。
LiveMathematicianBench v7 is an automatically generated, periodically refreshable research-grade mathematical multiple-choice benchmark designed to evaluate the advanced mathematical reasoning capabilities of cutting-edge AI models. The dataset was jointly created by Columbia University and Microsoft Research, with data sourced from arXiv mathematics papers newly published between March and June 2026. Each question is based on a theorem from a paper, and the distractors are adversarially generated from the proof sketch of that theorem. A multi-stage difficulty pipeline ensures that the final set is challenging even for the strongest models. The dataset is organized by month, with each month containing four subsets: all generated multiple-choice questions (full/), a quality-filtered subset (ge5/, with a total score of ALS+TAS+GPS+DQS ≥ 5), the hardest subset (hard/, retaining only the most difficult question per source theorem), and independent retest results. There are 431 hard-level questions, and GPT-5.4 (medium) achieves an accuracy of 42.5% on this subset. The benchmark is suitable for measuring a models ability in mathematical problem understanding, theorem application, and reasoning, especially for evaluating the mathematical reasoning level of large language models.
LiveMathematicianBench v7 数据集概述
基本信息
- 数据集名称:LiveMathematicianBench v7(覆盖 arXiv 2026年3月至6月)
- 许可证:CC-BY-4.0
- 任务类型:问答(question-answering)
- 标签:数学、研究级、基准测试、抗污染
- 来源机构:哥伦比亚大学与微软研究院
核心特点
该基准测试为自动化、可刷新的研究级数学多选题数据集,题目源自最新发表的 arXiv 数学论文,通过构造方式实现抗污染。每个问题基于近期论文中的定理,干扰项根据证明草图对抗性生成,多阶段难度流水线确保最终题目对前沿模型具有较高难度。
数据组织
按月份目录(202603/、202604/、202605/、202606/)组织,每月包含:
| 文件路径 | 内容说明 |
|---|---|
full/qaEval_<month>_full.json |
所有生成的多选题(v5) |
ge5/qaEval_<month>_ge5.json |
质量过滤后的题目(评分≥5) |
hard/qaEval_<month>_ge5_hard.json |
最终困难子集(每个源定理选一个最难题目) |
hard/accuracy_test_<month>_medium_filter2.json |
最终独立重测结果 |
summary.json |
每月漏斗数据汇总 |
基准测试结果(GPT-5.4 medium 在最终困难集上)
| 月份 | 困难题数 | 准确率 |
|---|---|---|
| 2026-03 | 112 | 37.5% |
| 2026-04 | 108 | 42.6% |
| 2026-05 | 95 | 48.4% |
| 2026-06 | 116 | 42.2% |
| 总体 | 431 | 42.5% |
注:准确率越低表示题目越难,完整的生成→过滤→非平凡题干→困难集漏斗见 summary.json。