
yuzhiliu8/Multilingual-orig
收藏官方服务:
资源简介:
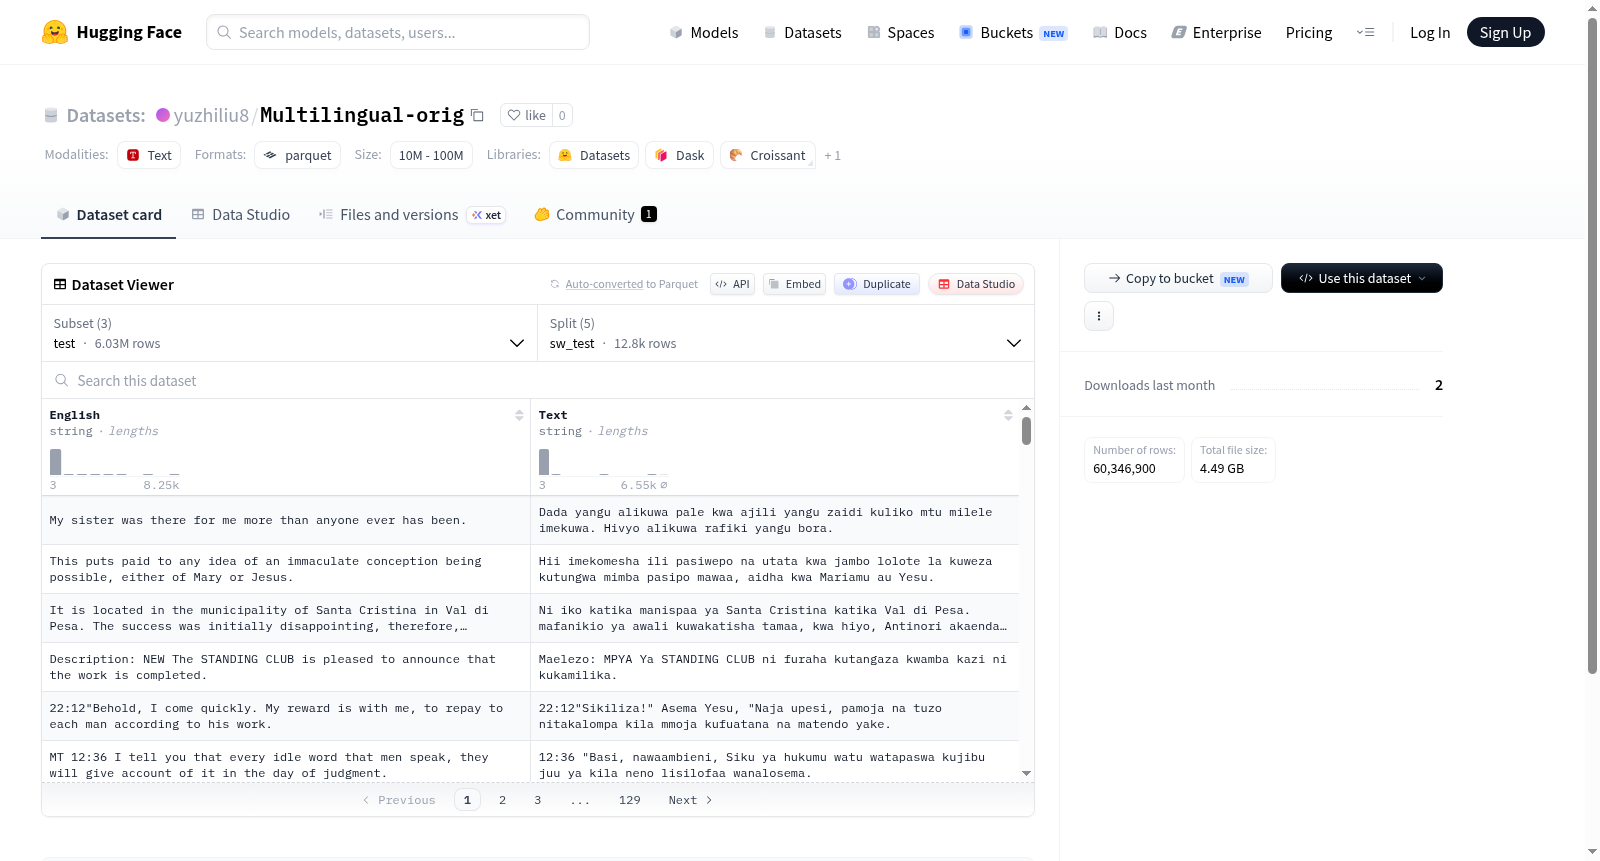
该数据集包含多个语言的分割,分为测试集(test)、训练集(train)和验证集(validation)三个配置。每个配置下包含多个语言的分割(如sw、ga、eus、bn、my等),每个分割的特征包括English和Text,数据类型均为字符串。数据文件以parquet格式存储,路径根据配置和分割的不同而有所变化。
The dataset contains multiple language splits, divided into three configurations: test, train, and validation. Each configuration includes multiple language splits (e.g., sw, ga, eus, bn, my), and each split features English and Text with string data types. The data files are stored in parquet format, with paths varying based on the configuration and split.
提供机构:
yuzhiliu8原始信息汇总
数据集概述
数据集配置
测试集 (test)
- 特征:
- English: 字符串类型
- Swahili: 字符串类型
- 分割:
- sw_test:
- 字节数: 4,201,090
- 样本数: 12,849
- sw_test:
- 下载大小: 2,903,044 字节
- 数据集大小: 4,201,090 字节
- 数据文件路径: test/sw/*.parquet
训练集 (train)
- 特征:
- English: 字符串类型
- Swahili: 字符串类型
- 分割:
- sw_train:
- 字节数: 34,143,683
- 样本数: 102,792
- sw_train:
- 下载大小: 23,674,910 字节
- 数据集大小: 34,143,683 字节
- 数据文件路径: train/sw/*.parquet
验证集 (validation)
- 特征:
- English: 字符串类型
- Swahili: 字符串类型
- 分割:
- sw_validation:
- 字节数: 4,263,998
- 样本数: 12,849
- sw_validation:
- 下载大小: 2,960,591 字节
- 数据集大小: 4,263,998 字节
- 数据文件路径: validation/sw/*.parquet
搜集汇总
数据集介绍
构建方式
在自然语言处理领域,多语言平行语料库是支撑跨语言模型训练与评估的关键资源。该数据集以英语为锚点语言,构建了涵盖斯瓦希里语、爱尔兰语、巴斯克语、孟加拉语和缅甸语五种低资源语言的平行语料。数据以Parquet格式存储,按语言和数据集划分(训练、测试、验证)组织成独立文件夹,每个样本包含英语文本及其对应的目标语言文本,形成双语对齐结构。
特点
该数据集最显著的特征在于其聚焦于低资源语言,填补了主流语料库中非洲、欧洲及亚洲部分语种的空白。每个语言子集均划分为训练、测试与验证三部分,便于标准化使用。数据规模因语言而异,例如爱尔兰语测试集包含约30.9万条样本,而斯瓦希里语测试集仅约1.2万条,反映了不同语言资源的稀缺程度差异。
使用方法
用户可通过HuggingFace Datasets库加载该数据集,指定配置名(如'train')和语言子集(如'sw_train')即可访问对应数据。数据以键值对形式提供'English'和'Text'字段,分别存储源语言与目标语言文本。适用于机器翻译、跨语言迁移学习及多语言模型微调等任务,加载时需注意各语言子集独立存在,需按需选取。
背景与挑战
背景概述
在自然语言处理领域,低资源语言的数据稀缺长期制约着多语言模型的泛化能力与公平性。由yuzhiliu8等人构建的Multilingual-orig数据集应运而生,其创建时间可追溯至2023年前后,旨在系统性地收集斯瓦希里语(sw)、爱尔兰语(ga)、巴斯克语(eus)、孟加拉语(bn)和缅甸语(my)这五种代表性低资源语言的平行语料。该数据集以英语为桥梁,构建了涵盖训练、验证与测试三阶段的标准化语料库,为跨语言迁移学习、机器翻译及多语言预训练模型提供了关键的基准资源。其发布显著推动了低资源语言处理的研究进展,成为评估模型在非主流语言上表现的重要参考,对促进语言技术的包容性发展具有深远影响。
当前挑战
Multilingual-orig数据集面临的核心挑战在于低资源语言本身的领域适配难题:这些语言在语法结构、书写系统及语义表达上与主流语言差异显著,现有模型难以直接迁移学习,导致在分类、翻译等任务上性能欠佳。构建过程中,语料收集与清洗尤为困难,例如缅甸语缺乏统一的数字化标准,巴斯克语存在大量方言变体,而斯瓦希里语的网络资源规模有限且噪声较高。此外,各语言子集的数据量极不均衡(如测试集中爱尔兰语样本达30万条,而斯瓦希里语仅1.2万条),这种长尾分布使得模型在少数语言上容易过拟合,同时加剧了跨语言评估的偏差。如何设计鲁棒的跨语言对齐策略并缓解数据稀疏性,成为该数据集持续推动领域发展的关键瓶颈。
常用场景
经典使用场景
在自然语言处理领域,多语言平行语料的稀缺性长期制约着跨语言模型的性能提升。yuzhiliu8/Multilingual-orig数据集以斯瓦希里语(sw)、爱尔兰语(ga)、巴斯克语(eus)、孟加拉语(bn)和缅甸语(my)五种低资源语言为核心,构建了与英语对齐的平行语料库,为机器翻译、跨语言文本分类及多语言预训练模型的微调提供了标准化的训练与评估基准。该数据集按标准比例划分为训练、验证和测试子集,尤其适用于探究低资源语言在神经机器翻译框架下的迁移学习效果,成为多语言NLP研究中不可或缺的基石性资源。
实际应用
在实际应用层面,该数据集为面向非洲、南亚及欧洲边缘语种的智能系统开发提供了关键支撑。例如,基于该数据集训练的机器翻译模型可广泛应用于斯瓦希里语地区的医疗咨询、爱尔兰语文化遗产数字化保护、巴斯克语政务服务平台等场景,助力打破语言壁垒,实现信息无障碍流通。此外,该数据还赋能跨国企业的本地化客服系统、多语言舆情监测工具以及教育领域的自动作文批改系统,将学术研究成果转化为切实服务多元语言社群的生产力。
衍生相关工作
该数据集的发布催生了一系列具有影响力的衍生工作,包括面向低资源语言的跨语言词嵌入对齐方法、基于对比学习的多语言句子表征模型,以及融合语言族谱先验知识的混合专家系统。研究者以该数据为基准,开发了针对斯瓦希里语-英语的鲁棒性翻译算法,并提出了利用巴斯克语形态学特征增强神经翻译模型解码效率的创新框架。这些工作不仅验证了数据集的学术价值,更拓展了其在多语言语义检索、低资源语言语音识别等前沿方向的应用边界。
以上内容由遇见数据集搜集并总结生成


