somosnlp-2026-aerospace
收藏资源简介:
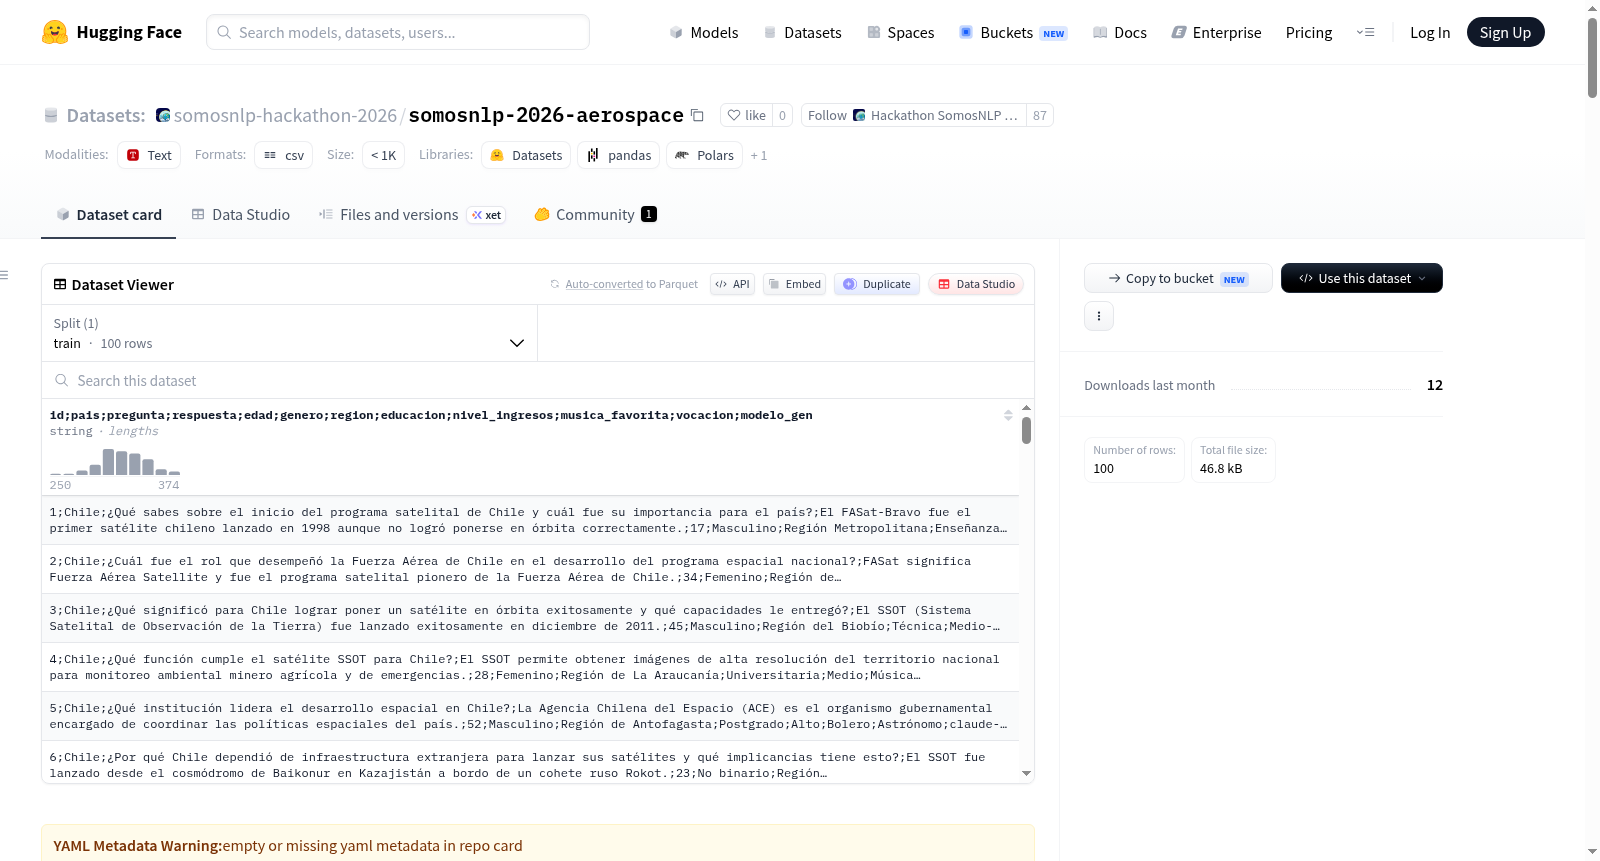
Aerospace Cultural Benchmark (LatAm) 是一个专门用于评估大型语言模型在专业领域表现的数据集。其核心目标是衡量模型在拉丁美洲(特别是智利)航空航天与文化语境下,生成教育性、技术性且文化连贯的回答的能力。该数据集包含100个经过人工审核的开放式问题,这些问题由claude-sonnet-4-20240515模型合成生成,并经过严格筛选以确保质量和可重用性。每个数据样本包含12个字段,除了问题本身和由LLM生成并审核的参考答案外,还附带了丰富的模拟用户人口统计信息,如年龄(15-63岁)、性别(男性、女性、非二元)、智利所属地区、教育水平、收入阶层、音乐偏好和职业,旨在为评估模型针对不同受众的语境适应能力提供多维背景。数据集内容覆盖智利卫星技术、天文台、空间机构、国际合作以及航天领域的社会经济影响等多个技术主题,并强调文化本地化。它被设计为一个基准测试工具,适用于模型评估、微调、文化适应性分析、偏见检测以及作为生成新数据集的模板。数据集的局限性在于其地理焦点主要限于智利,参考答案可能存在细微的不准确性,并且对拥有天文台的智利北部地区存在地理偏见。
Aerospace Cultural Benchmark (LatAm) is a dataset specifically designed for evaluating the performance of large language models in professional domains. Its core objective is to measure the models ability to generate educational, technical, and culturally coherent responses in the aerospace and cultural context of Latin America, particularly Chile. The dataset contains 100 manually reviewed open-ended questions, which are synthesized and generated by the `claude-sonnet-4-20240515` model and rigorously screened for quality and reusability. Each data sample includes 12 fields, encompassing the question itself, reference answers generated and reviewed by LLMs, and rich simulated user demographic information such as age (15-63), gender (male, female, non-binary), region in Chile, education level, income class, music preferences, and occupation, aiming to provide multi-dimensional context for evaluating the models contextual adaptation to different audiences. The dataset content covers multiple technical topics, including Chilean satellite technology, observatories, space agencies, international cooperation, and the socio-economic impact of the aerospace field, with an emphasis on cultural localization. It is designed as a benchmark tool suitable for model evaluation, fine-tuning, cultural adaptability analysis, bias detection, and as a template for generating new datasets. Limitations of the dataset include its geographical focus primarily limited to Chile, potential subtle inaccuracies in reference answers, and geographical bias towards northern Chile, which has observatories.
数据集名称:Aerospace Cultural Benchmark (LatAm)
描述
该数据集包含 100 道精选开放性问题,聚焦航空航天领域,并具有强烈的拉丁美洲(特别是智利)文化本地化特征。旨在提供一个高质量基准,用于评估大型语言模型在专业背景下生成教育性、技术性和文化一致性回答的能力。所有问题均使用 claude-sonnet-4-20250514 生成,并由人工逐一审查。
数据集结构
该数据集包含 12 列:
| 列名 | 类型 | 描述 |
|---|---|---|
id |
int | 唯一标识符 (1-100) |
pais |
str | 上下文国家 (智利) |
pregunta |
str | 关于航空航天/天文学的开放性问题 |
respuesta |
str | 参考回答 (由 LLM 生成,经人工审查) |
edad |
int | 模拟用户档案的年龄 |
genero |
str | 档案性别 (男性,女性,非二元) |
region |
str | 智利地区 |
educacion |
str | 教育水平 (基础、中等、技术、大学、研究生) |
nivel_ingresos |
str | 社会经济收入水平 (低、中、中高、高) |
musica_favorita |
str | 档案音乐偏好 (用于人口统计分析) |
vocacion |
str | 档案的职业/志向 |
modelo_gen |
str | 用于生成问题和回答的 LLM 模型 |
数据集摘要
该数据集与传统基准测试不同,它使用开放、可复用的问题,可用于多个数据集或不同上下文。问题被设计用于评估:
- 情境知识:对拉丁美洲背景下航空航天产业的理解。
- 技术推理:解释复杂概念而不使之过于简化的能力。
- 文化一致性:使语言风格适应本地受众。
- 可迁移性:足够通用,能在其他数据集中使用的问题。
质量验证
- 所有问题均使用
claude-sonnet-4-20250514生成。 - 每行包含
modelo_gen列作为生成模型的标识符。 - 每个问题和回答均经过人工审查。
- 100% 的问题为开放性和可复用性问题。
- 用需要推理和论证的问题替换了 12 道封闭式(琐事型)问题。
创建方法
问题依据以下规则设计:
- 问题开放性:允许多个有效答案,展示对主题的理解、批判性分析、技术推理和历史或文化视角。
- 文化情境化:地理重点在智利、拉丁美洲和特定区域;包含100个不同年龄、性别、教育背景和收入的多样化人口档案;包含本地音乐和职业偏好以进行人口统计分析。
- 技术领域:涵盖智利卫星及航天技术 (SSOT, SUCHAI, FASat)、天文学及观测站 (ALMA, ESO, Paranal, La Silla, CTIO)、航天机构与国际合作、航天领域的社会经济与教育影响、天文观测与科学发现。
- 人类质量:确保非琐碎性、中立性、文化多元性和可验证性。
涵盖维度
| 维度 | 描述 |
|---|---|
| 知识 | 关于拉丁美洲背景下航空航天/天文学的技术知识 |
| 推理 | 解释“为什么”和“为了什么”的能力 |
| 情境化 | 适应特定人口档案的能力 |
| 文化一致性 | 使用适合拉丁美洲的语言风格 |
| 可迁移性 | 在其他数据集中的可复用性 |
数据集分布
- 总记录数:100
- 国家:智利 (拉丁美洲地区)
- 覆盖地区:智利15个大区
- 年龄范围:15-63岁
- 教育水平:5个级别
- 性别分布:男性,女性,非二元
用例
- 在专业背景下评估 LLM。
- 多语言基准测试(评估拉丁美洲西班牙语的一致性)。
- 微调模型以利用区域视角回答航空航天主题。
- 分析模型如何根据不同人口统计信息调整回答。
- 检测关于拉丁美洲、STEM领域女性、原住民的偏见。
- 将问题用作模板来创建新数据集。
局限性
- 数据集仅聚焦于拉丁美洲内一个特定国家(智利),无法覆盖该地区的全部多样性。
- 参考回答由 LLM 生成,虽经人工审查,仍可能存在细微不准确或偏见。
- 存在地理偏见,偏向于拥有天文观测站的地区(智利北部)。
- 未涵盖补充性的航空航天学科(如火箭工程、拉丁美洲私营航天产业)。
许可和归属
- 数据许可:Apache 2.0。
- 生成内容归属:问题和回答由 Anthropic 的 Claude (claude-sonnet-4-20250514) 生成,使用条款允许在其他 LLM 的训练中使用其输出。数据集中包含
modelo_gen列,并且每个问题/回答均经过人工审查。
版本
- v1.0 (2026年1月):包含100个经过验证问题的初始版本。重组了12个问题以确保开放性和可复用性。包含
modelo_gen列以实现可追溯性。为100个记录提供了完整的人口统计档案。已完成人工质量验证。