
Siki-77/Amazon_Category
收藏官方服务:
资源简介:
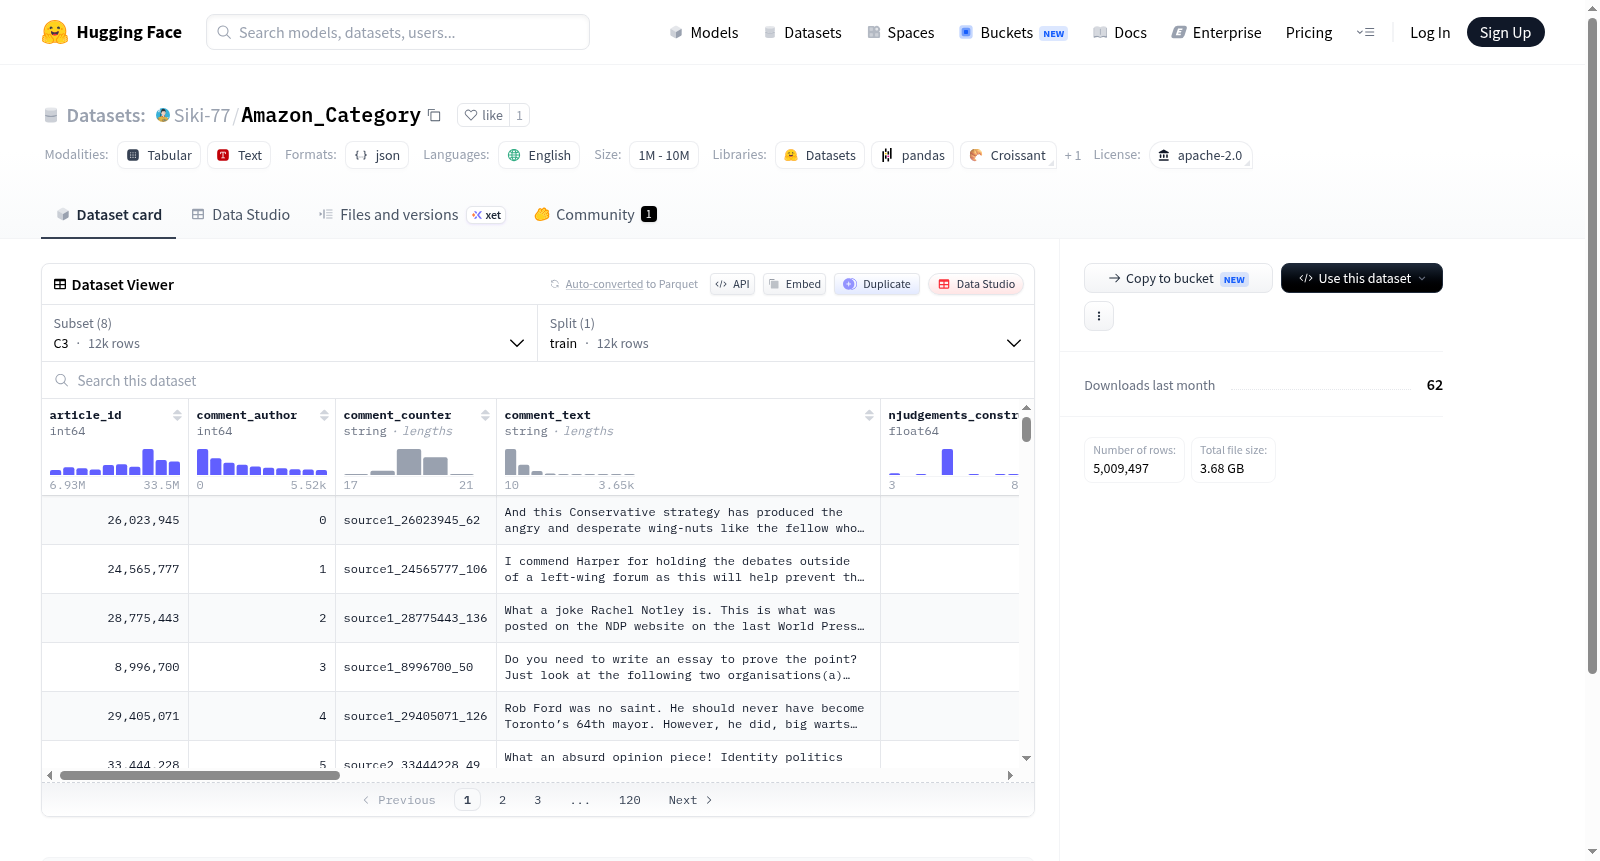
该数据集包含与美容产品、礼品卡、家电、手工艺品、健康和个人护理、电影和电视相关的不同数据配置。还包括一个名为C3的匿名清理数据集和Kindle商店数据。数据集采用Apache-2.0许可证,数据语言为英语。
The dataset includes different configurations related to beauty products, gift cards, appliances, handmade products, health and personal care, movies and TV, an anonymized clean dataset referred to as C3, and data from the Kindle Store. The dataset is licensed under Apache-2.0 and the language is English.
提供机构:
Siki-77原始信息汇总
数据集概述
配置信息
-
beauty:
- 数据文件:
All_Beauty.jsonl - 分割:
train
- 数据文件:
-
giftcard:
- 数据文件:
Gift_Cards.jsonl - 分割:
train
- 数据文件:
-
appliance:
- 数据文件:
appliances.jsonl - 分割:
train
- 数据文件:
-
handmade:
- 数据文件:
Handmade_Products.jsonl - 分割:
train
- 数据文件:
-
health:
- 数据文件:
Health_and_Personal_Care.jsonl - 分割:
train
- 数据文件:
-
movie:
- 数据文件:
longer_Movies_&_TV.jsonl - 分割:
train
- 数据文件:
-
C3:
- 数据文件:
C3_anonymized_clean.jsonl - 分割:
train
- 数据文件:
许可证
- apache-2.0
语言
- en
搜集汇总
数据集介绍
构建方式
在电商数据分析领域,高质量的分类数据集是模型训练与评估的基石。Siki-77/Amazon_Category数据集基于亚马逊平台的多品类商品信息构建而成,整合了美容、礼品卡、家电、手工制品、健康个护、影视娱乐、匿名化第三方商品及Kindle电子书等八个细分领域的子集。每个子集以JSONL或JSON格式存储,分别对应独立的配置名称(config_name),便于按需加载。数据来源明确,结构统一,旨在为商品分类、推荐系统及自然语言处理任务提供标准化的训练数据。
特点
该数据集的核心特点在于其多领域覆盖与模块化设计。美容、健康个护等高频消费品类与影视、Kindle等数字内容类别并存,兼顾实体商品与虚拟产品,展现了丰富的语义多样性。各子集独立存储,支持灵活调用,降低了数据冗余。此外,数据集采用Apache-2.0开源协议,语言统一为英文,确保了广泛的可复现性与学术合规性。其匿名化处理(如C3子集)进一步强化了隐私保护,契合现代数据伦理要求。
使用方法
使用者可通过HuggingFace Datasets库便捷加载该数据集。指定配置名称(如'beauty'或'movie')即可获取对应子集的训练数据,默认仅包含训练分割(split='train')。数据以字典形式返回,字段结构与原始JSONL文件一致,适用于文本分类、序列标注等下游任务。建议根据任务需求选择单一子集或组合多个子集以扩充样本量,并注意不同类别间的标签体系差异。数据预处理时,需解析JSON格式以提取文本与标签字段。
背景与挑战
背景概述
在电子商务飞速发展的当下,商品分类作为信息检索与推荐系统的核心基石,其精准度直接关乎用户体验与商业效益。Siki-77/Amazon_Category数据集应运而生,由研究团队基于亚马逊平台的海量商品数据构建而成,涵盖美容、礼品卡、家电、手工艺品、健康个护、影视、匿名化类别及Kindle商店等多个垂直领域。该数据集旨在为多类别文本分类任务提供标准化训练基准,其丰富的领域覆盖与大规模样本特性,为自然语言处理与电商智能研究注入了新的活力,推动了商品属性理解与分类模型的迭代演进。
当前挑战
该数据集面临的挑战主要源自两方面:其一,电商商品类别间存在高度语义重叠与层级模糊性,例如“健康个护”与“美容”在描述上常有交叉,导致模型难以精准区分细粒度类别,这是领域分类任务的核心难点;其二,构建过程中需处理海量非结构化文本,商品标题与描述中混杂品牌名、型号、促销语等噪声信息,且部分子集(如C3)经过匿名化处理,进一步加剧了语义稀疏性,对特征提取与泛化能力构成了严峻考验。
常用场景
经典使用场景
在电子商务与推荐系统研究领域,Siki-77/Amazon_Category数据集以其丰富的商品类别覆盖和高质量的用户行为记录,成为经典的多领域推荐系统评估基准。研究者常利用其涵盖的美妆、礼品卡、家电、健康护理、影视等多个垂直品类数据,来验证跨域推荐算法、多任务学习模型以及类别自适应方法的有效性,尤其适用于探索商品类别间用户偏好的迁移与泛化能力。
解决学术问题
该数据集有效解决了电子商务研究中长期存在的类别稀疏性与冷启动问题。通过提供多个商品类别的统一用户行为序列,它允许学者系统性地分析不同品类间的用户兴趣关联,从而推动跨域推荐、元学习以及图神经网络等前沿方法在缓解数据稀疏性方面的理论突破。其公开的匿名化处理亦保障了隐私合规性,为可复现的学术研究奠定了坚实基础。
衍生相关工作
该数据集衍生了一系列具有影响力的学术工作,包括基于注意力机制的跨品类推荐模型(如CAT-Transformer)、融合类别层次信息的对比学习框架(如CL4Rec),以及利用多任务学习同时优化点击率与购买率的联合建模方法。这些工作不仅深化了对用户多兴趣行为的理解,还推动了大规模商品分类与检索技术的演进,成为后续研究的重要参照基准。
以上内容由遇见数据集搜集并总结生成


