
遇见数据集

english_nuer_sentence-pairs_1M

收藏
Hugging Face2026-07-07 更新2026-07-08 收录
官方服务:

资源简介:

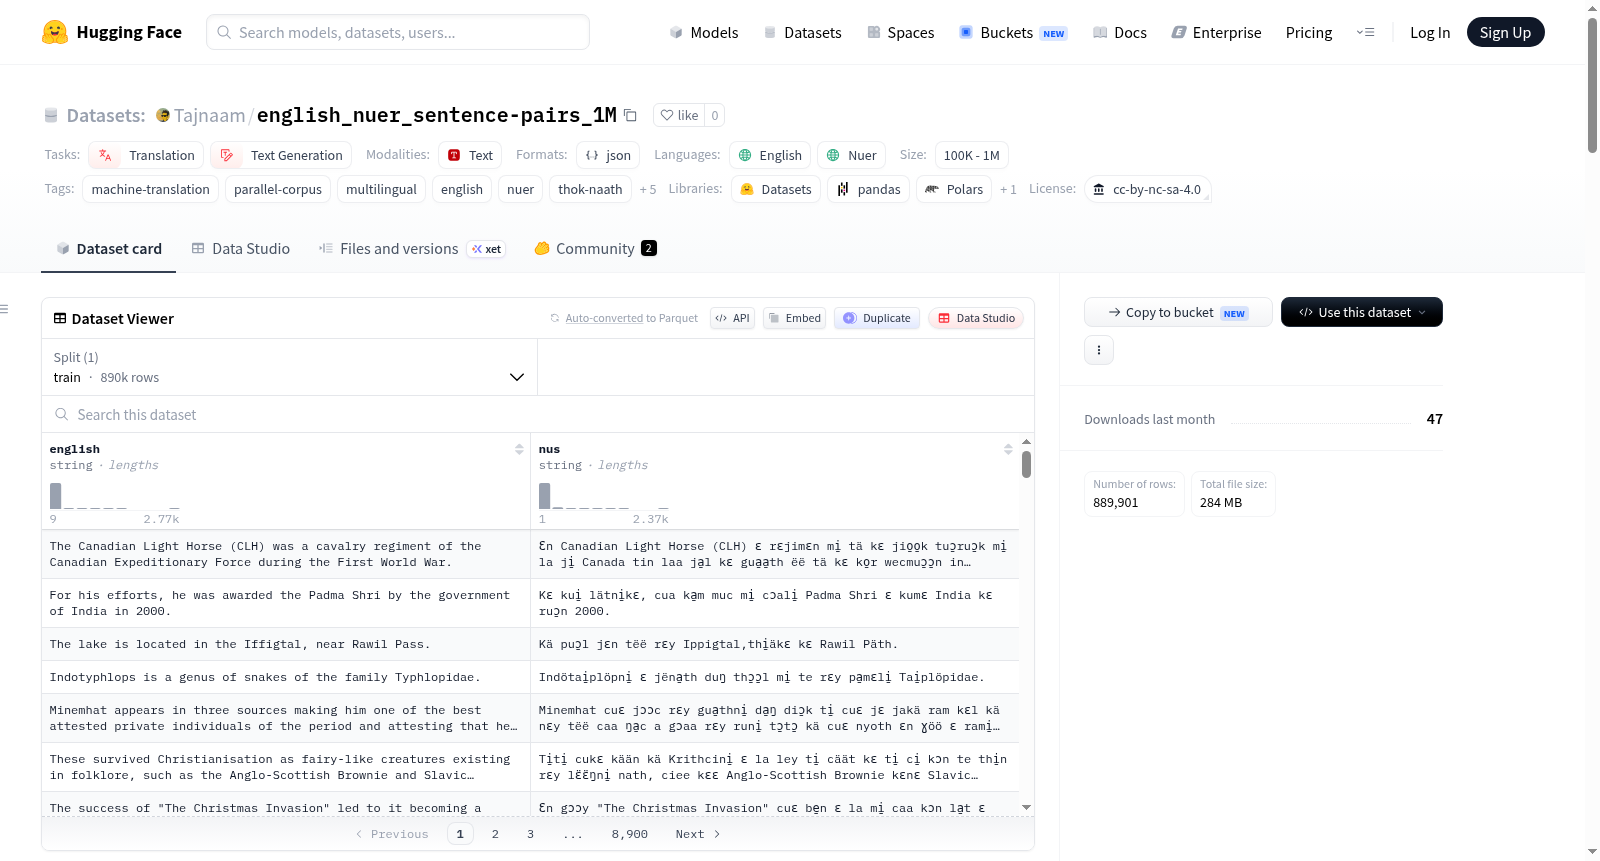
English–Nuer Sentence Pairs (1M) 是一个大规模双语平行语料库,包含约100万条对齐的英语和努尔语(Thok Naath)句子对。该数据集旨在支持机器翻译、多语言自然语言处理(NLP)、跨语言表示学习以及低资源非洲语言技术的开发研究。同时,该项目也有助于努尔语(Thok Naath)的数字保存和可访问性。

English–Nuer Sentence Pairs (1M) is a large-scale bilingual parallel corpus containing approximately 1 million aligned English and Nuer (Thok Naath) sentence pairs. This dataset aims to support machine translation, multilingual natural language processing (NLP), cross-lingual representation learning, and the development of technologies for low-resource African languages. Additionally, this project contributes to the digital preservation and accessibility of the Nuer (Thok Naath) language.

创建时间:
2026-07-02
原始信息汇总

数据集概述

  • 名称: English–Nuer Sentence Pairs (1M)
  • 规模: 约 100 万条对齐的英语–努埃尔语(Thok Naath)句子对
  • 语言: 英语 (en)、努埃尔语/Thok Naath (nus)
  • 许可协议: Creative Commons Attribution–NonCommercial–ShareAlike 4.0 International (CC BY-NC-SA 4.0),仅限研究和教育用途,禁止商业使用

任务与标签

  • 任务类别: 翻译、文本生成
  • 标签: 机器翻译、平行语料库、多语言、英语、努埃尔语、Thok Naath、低资源语言、非洲语言、语言保护、大语言模型、神经机器翻译

数据集用途

  • 神经机器翻译
  • 大语言模型预训练与微调(仅限研究)
  • 跨语言表示学习
  • 句子嵌入模型
  • 平行语料库研究
  • 多语言自然语言处理
  • 语言学分析
  • 低资源语言研究
  • 基准评估
  • 语言保护与语言学研究

使用限制

  • 仅限学术研究与教育目的
  • 严禁商业用途,包括:训练商业AI或大语言模型、商业翻译系统、付费API、SaaS产品、专有AI服务、销售或再分发数据集、将数据集集成到商业软件或产品中
  • 商业使用需联系作者获取独立商业许可证

数据记录结构

  • 每条记录包含一个英语句子及其对应的努埃尔语翻译

引用信息

bibtex @dataset{tajnaam2026english_nuer_1m, author = {Tajnaam}, title = {English–Nuer Sentence Pairs (1M)}, year = {2026}, publisher = {Hugging Face}, url = {https://huggingface.co/datasets/Tajnaam/english_nuer_sentence-pairs_1M} }

许可详情

致谢与伦理

  • 数据集旨在支持努埃尔语(Thok Naath)的语言保护,鼓励低资源非洲语言研究
  • 鼓励负责任地使用数据集,尊重努埃尔语社区
  • 翻译错误或文化问题可通过 Hugging Face 仓库提交 issue

免责声明

  • 数据集按“原样”提供,不提供任何担保,作者对错误、遗漏或误用不承担责任

联系

  • 可通过 Hugging Face 仓库联系作者,处理问题、合作、更正或商业许可咨询
搜集汇总
数据集介绍
english_nuer_sentence-pairs_1M 数据集图片
构建方式
English–Nuer Sentence Pairs (1M) 数据集通过对齐英语与努埃尔语(Thok Naath)的句子对构建而成,涵盖约一百万条平行语料。该数据集致力于支持机器翻译、跨语言表示学习及低资源非洲语言的自然语言处理研究,显著增强了方言复杂、资源稀缺语言的数字表现力。数据来源严格遵循可验证性原则,每一对句子均经过细致校对,确保语言转换的准确性和语义的完整性。
特点
该数据集的一大特色在于其规模宏大且面向低资源语言——努埃尔语,这是南苏丹及埃塞俄比亚地区的主要语言之一。它不仅提供了丰富的双语对齐示例,为神经机器翻译模型和大型语言模型的预训练与微调奠定数据基础,还助力语言学分析及跨语言嵌入模型的研究。同时,数据集以非商业分享许可发布,着重促进学术探索与语言保护。
使用方法
数据集以 Hugging Face 格式呈现,用户可便捷地加载并纳入机器学习流水线。研究者可利用该平行语料训练翻译模型、进行双语语料研究,或作为评测基准。使用时应尊重社区文化敏感性,并遵循CC BY-NC-SA 4.0许可协议,禁止任何未授权的商业用途。建议使用方在公开成果中标注适当引用,以示对原始贡献者的认可。
背景与挑战
背景概述
该数据集由研究者Tajnaam于2026年创建并发布在Hugging Face平台,聚焦于英语与努埃尔语(Thok Naath)之间的平行语料构建,是针对极低资源非洲语言机器翻译与自然语言处理研究的重要资源。核心研究问题在于如何通过大规模高质量的双语句对,推动神经机器翻译、跨语言表征学习以及大型语言模型在低资源场景下的应用。包含约100万条对齐句对,该数据集不仅为学术研究提供了基准训练与评估数据,更助力于努埃尔语言的数字化保存与可及性提升,对非洲语言保护与多语言NLP领域具有深远影响。
当前挑战
所解决的领域挑战在于低资源语言的机器翻译研究长期受限于数据匮乏,尤其是像努埃尔语这类使用人数较少、数字化语料稀缺的语言,难以支撑现代数据驱动的NLP模型训练。数据集构建过程面临的双重挑战包括:一是如何从有限且分散的源材料(如口述记录、宗教文本等)中系统性地获取并验证高质量的平行句对;二是在跨语言对齐与翻译过程中,需应对语法结构差异巨大、文化语境复杂等问题,确保语义保真性与文化敏感性,避免引入偏见或错误信息。
常用场景
经典使用场景
在神经机器翻译与跨语言自然语言处理领域,英语-努埃尔语句对数据集凭借百万级别的高质量平行语料,成为构建和评估低资源语言翻译系统的基石。研究团队通常利用该数据集训练端到端的序列到序列模型,包括基于Transformer架构的神经机器翻译系统,以及基于预训练语言模型的微调范式。该数据集的经典使用模式是将英语作为源语言、努埃尔语作为目标语言,通过监督学习的方式实现双语翻译能力的习得,进而为非洲低资源语言的机器翻译研究提供可复现的基准实验平台。
实际应用
在实际应用层面,该数据集为努埃尔语的数字化生存与传播提供了技术支撑。构建的机器翻译系统可服务于南苏丹地区的教育信息化场景,辅助英语与努埃尔语的双语教学材料生成。在 humanitarian 领域,该数据集支持开发面向努埃尔语社区的信息传播工具,例如将公共卫生指南、农业技术手册等关键内容从英语精准翻译为努埃尔语,提升跨语言信息可达性。此外,基于该数据集的翻译模块可集成到多语言对话系统或内容管理平台中,助力低资源语言用户在数字世界中的平等参与。
衍生相关工作
围绕该数据集已衍生出一系列具有代表性的研究工作。在模型层面,研究者基于该平行语料进行了低资源神经机器翻译的迁移学习实验,探索了多语言预训练模型在努埃尔语上的零样本与少样本翻译能力。在评估体系方面,该数据集被用作构建低资源语言翻译质量评估基准的重要组件,推动了对新兴语种翻译性能客观度量的方法论研究。此外,基于该数据集的句子对齐技术研究与跨语言词嵌入训练工作,也为后续构建更大规模的低资源语言语料库提供了可复现的技术范式与经验积累。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

