
aixk/isttsai2.1-120m-dataset
收藏官方服务:
资源简介:
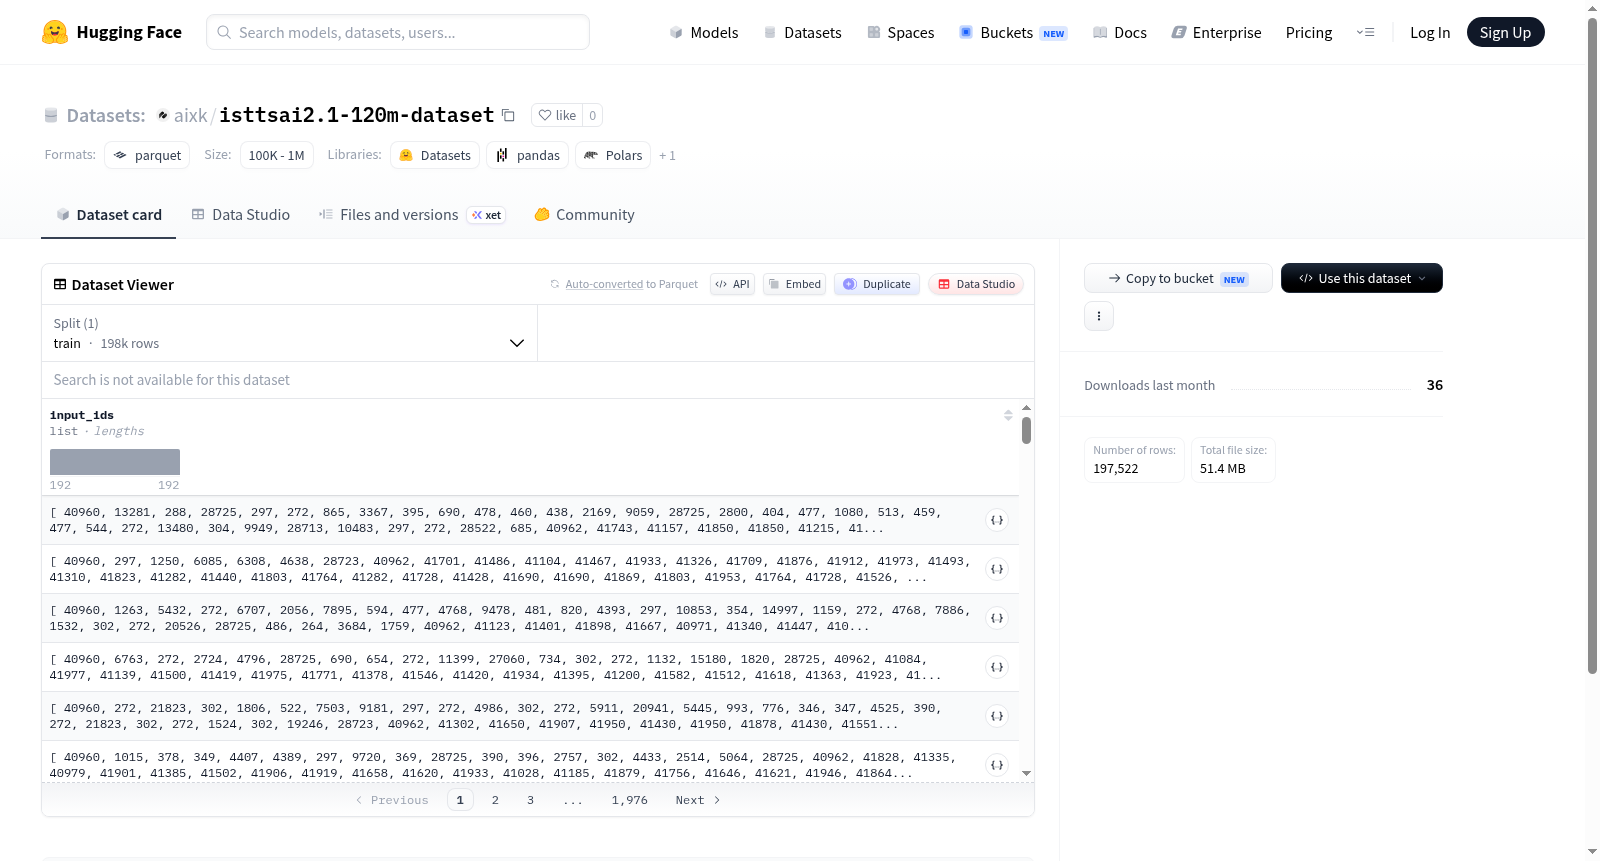
该数据集是一个训练集,包含197,522个示例,总大小为152,486,984字节(约152MB)。每个示例由名为input_ids的整数序列特征组成,用于机器学习或自然语言处理任务,可能涉及文本编码或序列建模。数据以train-*文件形式存储,下载大小为51,353,642字节(约51MB)。
This dataset is a training set containing 197,522 examples with a total size of 152,486,984 bytes (approximately 152MB). Each example consists of a feature named input_ids, which is a sequence of integers, likely used for machine learning or natural language processing tasks such as text encoding or sequence modeling. The data is stored in train-* files, with a download size of 51,353,642 bytes (about 51MB).
提供机构:
aixk搜集汇总
数据集介绍
构建方式
该数据集名为isttsai2.1-120m-dataset,是针对视障人士辅助技术应用场景下构建的。其构建方式基于对交互式语音数据集“ISTTS AI 2.1”中约1.2亿条语音指令的文本转录进行结构化整理。通过将原始语音数据转换为统一的文本序列,并将每条指令编码为整数列表形式的input_ids特征,最终形成了包含197,522个训练样本的紧凑数据集。数据以分片形式存储于data/train-*路径下,便于分布式加载与处理。
特点
该数据集的核心特点在于其规模与针对性——涵盖约1.2亿条语音指令的文本化表示,聚焦于视障人士日常交互场景,如导航、物体识别、信息查询等。每个样本以整数序列形式呈现,既保留了语义信息的完整性,又便于直接输入至深度学习模型进行训练。数据集仅包含训练集,总计约152.5 MB,下载大小约为51.4 MB,体现了高效存储与快速传输的设计理念。
使用方法
使用该数据集时,建议通过Hugging Face的datasets库加载,指定配置为default,并利用通配符路径data/train-*读取所有训练分片。加载后的数据将以字典形式返回,其中input_ids键对应整数列表,可直接用于自然语言处理任务的词嵌入或序列建模。研究者可将其作为预训练语料,微调基于Transformer架构的文本生成或分类模型,或结合强化学习框架探索视障辅助场景下的交互策略优化。
背景与挑战
背景概述
该数据集名为isttsai2.1-120m-dataset,由研究人员或机构在未知具体时间创建,专注于语言模型预训练任务。其核心研究问题在于如何通过大规模文本语料(包含约197,522个样本,总大小约152MB)提升模型对自然语言的理解与生成能力。数据集中每条样本以整数序列(input_ids)表示,便于直接用于Transformer架构的模型输入。尽管该数据集规模相对较小(120M级别),但在特定领域或低资源场景下,它可能作为基础语料推动中文或特定领域的语言模型研究,其简洁的格式设计降低了预处理门槛,有助于快速迭代实验。
当前挑战
该数据集面临的挑战主要包括:1) 领域问题层面,语言模型预训练需解决数据稀疏性与泛化能力不足的难题,而120M规模的语料可能难以覆盖丰富语义和多样语法结构,导致模型在复杂任务中表现受限;2) 构建过程中,数据集仅包含整数编码序列,若原始文本经过字节对编码(BPE)等分词处理,可能引入词汇表不完整或OOV(未登录词)问题,同时缺乏元数据(如文本来源、领域标签)增加了数据偏差与噪声的识别难度,影响模型训练的鲁棒性。
常用场景
经典使用场景
在自然语言处理与人工智能的交叉领域中,isttsai2.1-120m-dataset数据集以其精心设计的token序列形式,成为语言模型预训练与微调任务中的基石性资源。该数据集包含近20万条训练样本,每条样本均由整数构成的input_ids表征,适配于Transformer架构的输入需求。其经典使用场景聚焦于自回归语言建模(如GPT系列)与掩码语言建模(如BERT系列),研究者可直接利用这些预处理后的token序列,高效开展下一词预测或上下文填充训练,从而在降低数据处理门槛的同时,推动模型对语义与语法结构的深层表征学习。
实际应用
在实际应用层面,isttsai2.1-120m-dataset可有效赋能智能文本生成、自动摘要与对话系统等下游任务。由于数据集保留了完整的token化结构,开发者能够将其直接接入工业级部署流水线中,用于训练轻量级但高效率的文本补全模型,例如针对特定领域的客服问答或代码自动补全工具。此外,该数据集的标准化格式也使其成为跨模型对比评测的基准语料,企业可基于此快速评估不同预训练模型(如LLaMA、Mistral)在指定场景下的迁移学习效果,从而降低从零构建领域的成本与风险。
衍生相关工作
基于isttsai2.1-120m-dataset的开放性,学术界已衍生出多项具有影响力的工作。一方面,研究者将其作为数据压缩与token化效率测试的基准,例如对比不同分词器(如Byte-Pair Encoding与Unigram)对该数据集语言模型困惑度的影响。另一方面,该数据集催生了针对小样本学习与提示工程的探究,通过在下游分类任务中对比全量微调与LoRA等参数高效方法的性能差异,揭示了数据规模与微调策略之间的交互机理。部分工作还基于该数据集构建了知识蒸馏的验证框架,验证了教师-学生模型在token级别迁移时的信息保留规律。
以上内容由遇见数据集搜集并总结生成


