
Samsoup/yelp2018
收藏官方服务:
资源简介:
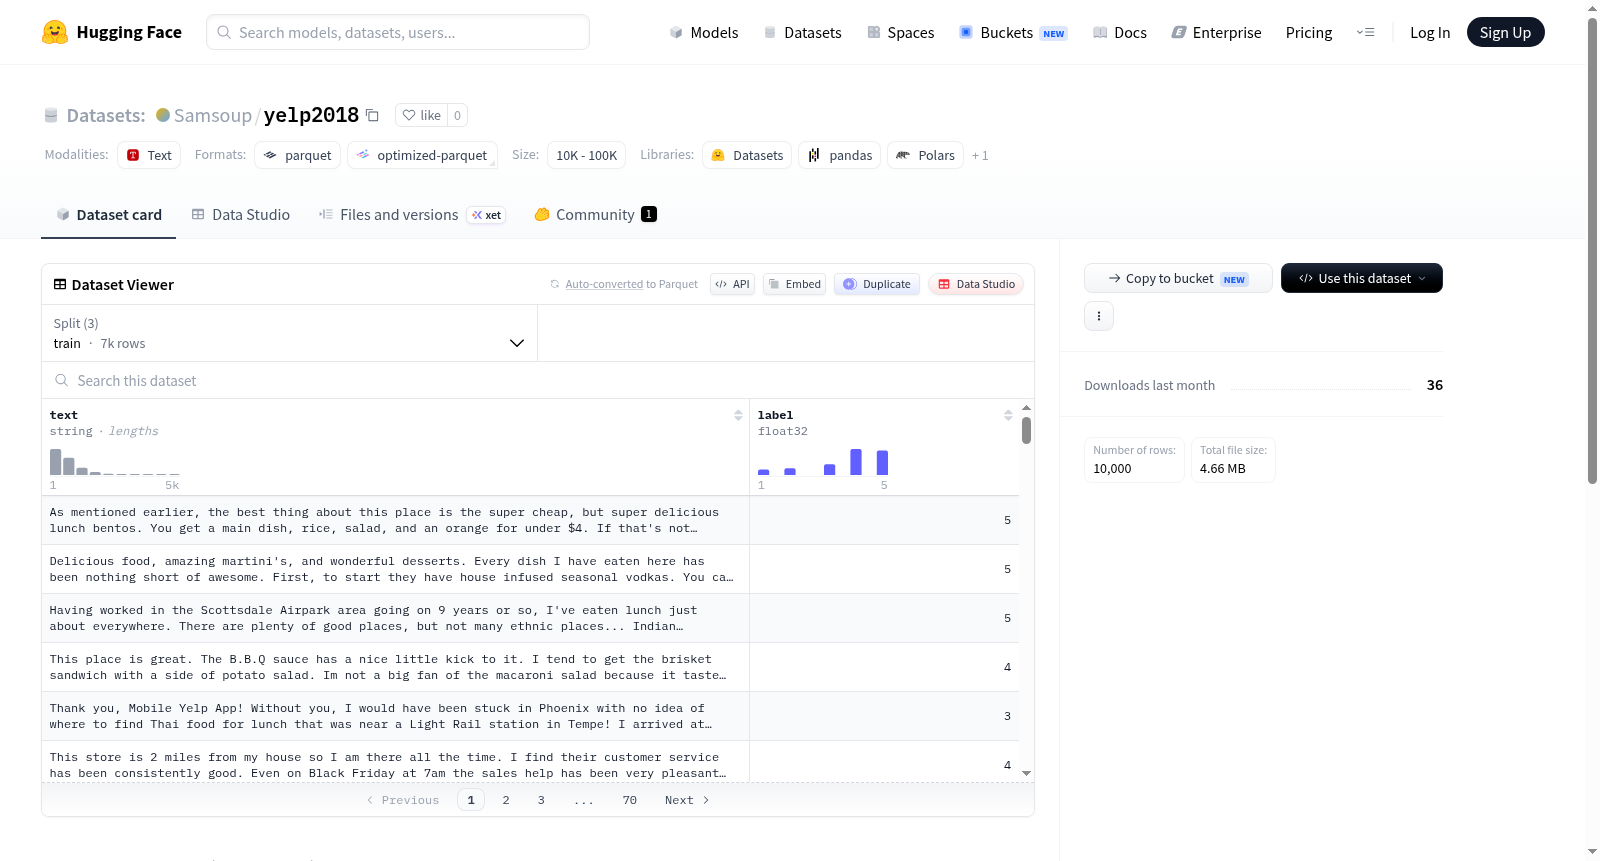
这是一个来自Kaggle的Yelp评论数据集的情感回归数据集,包含了评论文本和对应的星级评分(1.0到5.0之间的浮点数)。数据集被划分为训练集、验证集和测试集,比例为70%训练集、15%验证集和15%测试集。数据集经过筛选和处理,以确保数据的质量和分布。
This is a sentiment regression dataset derived from the Kaggle Yelp Reviews Dataset, containing review text and corresponding star ratings (floats between 1.0 and 5.0). The dataset is split into training, validation, and test sets with a ratio of 70% training, 15% validation, and 15% test. The dataset has been filtered and processed to ensure data quality and distribution.
提供机构:
Samsoup搜集汇总
数据集介绍
构建方式
在情感分析领域,细粒度的评分预测任务对于理解用户反馈具有重要价值。Samsoup/yelp2018数据集源自Kaggle上的Yelp评论数据集,经过精心筛选与重构,保留了评论文本及其对应的星级评分。原始星级评分被直接转换为浮点型标签,取值范围为1.0至5.0,确保了数值的连续性与原始语义的一致性。基于离散的星级分布,采用分层抽样策略将数据划分为训练集(70%)、验证集(15%)和测试集(15%),最终形成了包含7000条训练样本、1500条验证样本及1500条测试样本的标准化回归数据集。
特点
该数据集的核心特点在于其专为文本回归任务设计,区别于传统的分类情感分析。标签以连续浮点数形式呈现,能够捕捉用户情感倾向的细微差异,而非简单的离散类别。数据来源为真实的Yelp用户评论,文本内容涵盖丰富的表达方式与多样化的评价维度,具有高度的生态效度。分层划分策略有效维护了各类别星级的比例平衡,避免了因数据分布不均导致的模型偏差,为训练鲁棒的回归模型提供了坚实基础。
使用方法
使用该数据集时,可直接通过HuggingFace的datasets库加载,获取包含'text'和'label'字段的字典结构。'text'字段为评论文本字符串,可作为模型输入;'label'字段为浮点数目标值,用于回归损失计算。推荐将文本进行分词与嵌入后,输入预训练语言模型(如BERT)进行微调,以预测连续的评分值。评估指标可选用均方误差(MSE)或平均绝对误差(MAE),以衡量预测评分与真实星级之间的数值偏离程度。
背景与挑战
背景概述
在自然语言处理领域,情感分析一直是研究热点,而情感回归任务作为其分支,旨在预测文本对应的连续情感强度值,比传统的分类任务更具细腻度与挑战性。Samsoup/yelp2018数据集正是为此而生,由Yuxia Wang、Daniel Beck、Timothy Baldwin和Karin Verspoor等研究者于2022年创建,源自Kaggle上的Yelp评论数据集。该数据集聚焦于将用户对商家的星级评分(1.0至5.0)转化为回归任务中的连续标签,以探究预训练模型在文本回归中的不确定性估计与性能优化。作为情感回归研究的基准资源,它推动了模型对评论文本细粒度情感理解的进展,尤其在Yelp这一真实商业场景中具有重要影响力,为后续不确定性量化方法的发展提供了数据支撑。
当前挑战
该数据集面临的核心挑战首先来自领域问题层面:情感回归任务要求模型精准捕捉评论文本中隐含的情感强度,但用户评分的主观性、语言表达的多样性(如讽刺、反语)以及评分分布的不均衡性,导致模型难以稳定地输出连续值,尤其在极端评分(1星或5星)处易产生较大偏差。其次,构建过程中存在数据清洗与标注一致性难题:原始Yelp评论数据包含噪声(如无关文本、格式错误),需严格筛选;且将整数星级评分直接作为回归标签时,忽略了不同用户对相同星级的情感解读差异,可能引入标签模糊性。此外,数据集仅含7000条训练样本,规模相对有限,对深度模型的泛化能力构成显著制约。
常用场景
经典使用场景
作为源自Yelp平台海量用户评论的文本回归数据集,Samsoup/yelp2018将评论内容与1至5分的连续星级评分相对应,为情感分析领域提供了精准的数值预测基准。其最经典的应用场景在于训练和评估能够从评论文本中学习情感强度的回归模型,通过捕捉词汇、句式和语义中蕴含的情感倾向,实现对用户满意度的细腻量化。该数据集以其连续标签特性,超越了传统分类任务中离散情感标签的局限,推动了从粗略情感极性判断向精细情感强度估计的范式转变。
解决学术问题
该数据集有效解决了文本回归任务中标注数据匮乏与标签分布不均衡的学术难题。通过提供经过分层抽样的训练、验证与测试划分,研究者能够系统性地评估模型在预测连续情感分数时的泛化能力与不确定性。它促进了预训练语言模型在回归场景下的适配研究,例如如何将分类头替换为回归头并优化损失函数,以及如何量化模型预测的置信区间,从而为情感分析、推荐系统等领域的理论探索提供了标准化实验平台。
衍生相关工作
该数据集直接支撑了Wang等人(2022)在TACL上发表的关于预训练模型文本回归不确定性估计与降低的经典工作,该研究利用此数据集验证了多种不确定性量化方法在连续情感预测中的有效性。后续衍生研究包括基于该数据集探索对比学习增强的回归表示、多任务联合训练框架(如同时预测评分与情感维度),以及将回归输出与可解释性词项关联的注意力机制模型,这些工作共同拓展了文本回归任务的方法论边界。
以上内容由遇见数据集搜集并总结生成


