遇见数据集

Lumina-Math-Foundations-200M

收藏
Hugging Face2026-08-16 更新2026-08-17 收录
官方服务:

资源简介:

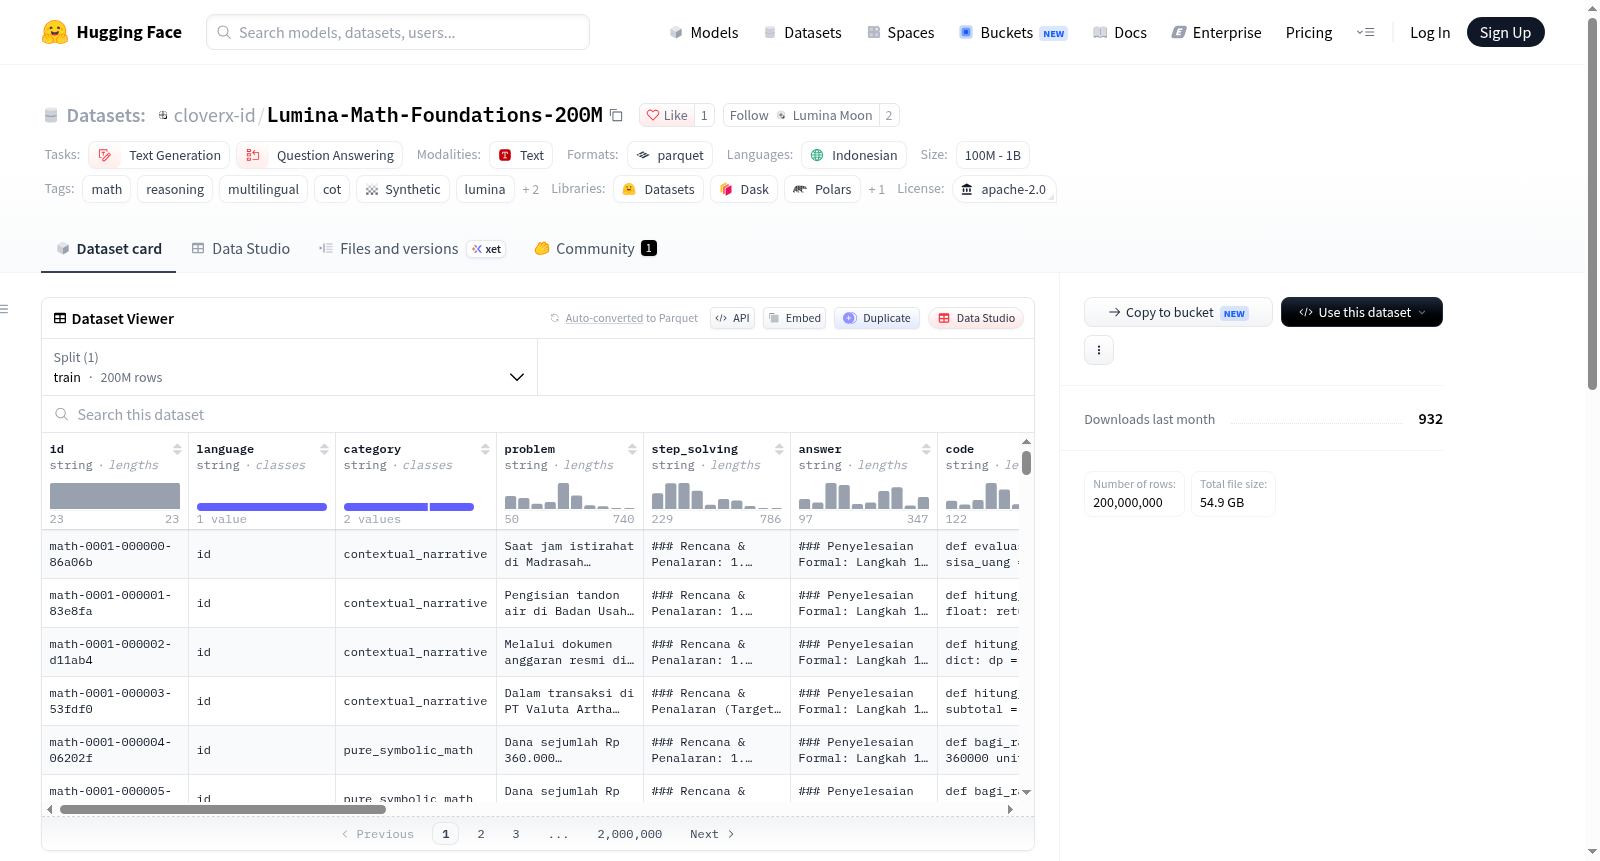
Lumina-Math-Foundations-200M是一个工业级的多语言基础数学推理数据集,专为大规模基础模型预训练、继续预训练和推理对齐而设计。该数据集当前包含印尼语数据,未来版本将扩展至英语、韩语、中文和日语。数据集规模在1亿到10亿样本之间,涵盖数学、推理、多语言、思维链(CoT)和合成数据等标签。数据以Apache Parquet格式存储于data/目录下,适用于文本生成和问答任务。

Lumina-Math-Foundations-200M is an industrial-grade multilingual foundational mathematical reasoning dataset, designed for large-scale foundation model pre-training, continued pre-training, and reasoning alignment. The dataset currently contains Indonesian data, with future versions to be expanded to English, Korean, Chinese, and Japanese. It ranges from 100 million to 1 billion samples, covering tags such as mathematics, reasoning, multilingual, chain-of-thought (CoT), and synthetic data. The data is stored in Apache Parquet format in the data/ directory and is suitable for text generation and question-answering tasks.

创建时间:
2026-08-16
原始信息汇总

数据集概述

Lumina-Math-Foundations-200M 是一个面向工业界的大规模多语言基础数学推理数据集,专为高容量基础模型的预训练、持续预训练以及推理对齐而设计。

基本信息

  • 语言:印度尼西亚语(id
  • 许可证:Apache-2.0
  • 任务类型:文本生成、问答
  • 数据集规模:100M < n < 1B
  • 标签:数学、推理、多语言、思维链(CoT)、合成数据、lumina、foundations、grandmaster-math

数据格式

所有记录以 Apache Parquet 文件格式存储在 data/ 目录下。

版本计划

当前版本支持印度尼西亚语,v2 版本将新增以下语言支持:

  • 英语(en
  • 韩语(ko
  • 中文(zh
  • 日语(ja

这些语言支持均为 即将推出 状态。

搜集汇总
数据集介绍
Lumina-Math-Foundations-200M 数据集图片
构建方式
在面向高容量基础模型预训练与推理对齐的数学语料需求日益增长的背景下,该数据集的构建立足于印尼语这一相对稀缺的低资源语言场景,采用工业级多语言合成数据生成流水线,针对数学推理任务专门设计。其构建过程融合了符号计算引擎、程序化题目模板与链式思维(Chain-of-Thought)标注机制,通过系统化生成涵盖基础算术、代数、几何及高阶竞赛数学的多样化题目,并为每道题配备结构化的分步推理解答。全部记录以Apache Parquet格式统一存储,兼顾大规模训练场景下的读取效率与数据溯源能力。
特点
该数据集的核心特质在于其规模与语言覆盖的差异化定位。数据集总量达到两亿条量级,处于一亿至十亿规模区间,归属于foundations系列,定位于为数学推理能力提供底层预训练支撑。语言维度上,当前版本以印尼语(id)为唯一支持语言,并已在规划中将英语、韩语、中文与日语纳入v2版本,体现出多语言扩展的演进路线。数据内容以数学推理与链式思维为标签核心,兼具合成数据与grandmaster-math的高难度题目特征,任务类别覆盖文本生成与问答,可支撑从预训练到推理对齐的多阶段训练需求。
使用方法
在具体使用层面,使用者可依据Hugging Face平台标准的数据集加载接口获取该数据集,所有记录均以Apache Parquet文件形式存放于数据目录中,便于与主流深度学习训练框架无缝对接。针对预训练或持续预训练的用途,可直接将数学文本与推理链数据作为语料输入;针对推理对齐任务,则可抽取题目与链式解答构成监督微调或偏好优化样本。使用方需注意当前版本仅提供印尼语数据,若涉及其他语言场景,应关注v2版本的发布进展。在学术研究中引用该数据集时,应参照其提供的BibTeX条目进行规范著录。
背景与挑战
背景概述
在大规模语言模型持续演进的浪潮中,数学推理能力始终被视为衡量机器智能深度的关键标尺。Lumina-Math-Foundations-200M数据集由Lumina Moon机构的Silver Moon与Earl Pan等研究人员于2026年构建并发布,旨在为高容量基础模型的预训练、持续预训练及推理对齐提供工业级多语言数学推理语料。该数据集以印尼语为核心,规划扩展至英语、韩语、中文和日语,其核心研究问题在于如何通过大规模合成数据弥合低资源语言在数学推理领域的表征鸿沟。该数据集的影响力在于,它为多语言数学推理研究提供了可扩展的基础设施,推动了推理密集型任务在非英语语境下的范式探索,并为后续多语言思维链研究奠定了数据基石。
当前挑战
该数据集所应对的领域问题在于,数学推理对逻辑严密性和符号一致性具有极高要求,而现有大规模语料多集中于英语,低资源语言在数学表达和推理步骤上存在严重的资源匮乏与质量参差。构建过程中的挑战尤为突出:其一,合成数据的生成需确保数学推导的绝对正确性,避免逻辑谬误或幻觉传播;其二,多语言扩展要求在处理印尼语等形态复杂语言时,维持数学符号与自然语言描述之间的精确对齐;其三,工业级规模下,如何在数据多样性与领域覆盖之间取得平衡,同时规避合成数据中潜在的分布偏差和重复模式,成为确保数据集泛化能力的关键难题。
常用场景
经典使用场景
在数学推理与多语言基础模型预训练的领域中,Lumina-Math-Foundations-200M以其工业级规模成为构建高容量基础模型的核心资源。该数据集最经典的使用场景在于支撑基础模型的预训练、持续预训练以及推理对齐任务,尤其是针对印尼语数学推理能力的系统性提升。研究者常将其作为训练语料,通过大规模自监督学习与指令微调,使模型掌握从基础算术到复杂证明的链式推理能力,从而在数学问题解答任务中展现出类人的逻辑演绎水平。
解决学术问题
该数据集有效缓解了低资源语言在数学推理研究中长期面临的数据稀缺与质量参差问题,为印尼语及后续多语言环境下的数学推理研究提供了标准化、大规模且带有思维链标注的语料基础。其学术意义在于推动了跨语言数学推理能力的可迁移性研究,使得模型能够在多语言背景下保持推理一致性,并为探索合成数据在数学教育领域的效用提供了实证依据。
衍生相关工作
围绕该数据集,已衍生出一系列经典工作,包括基于其训练的印尼语数学推理模型、多语言思维链蒸馏框架以及数学推理基准测试套件。这些工作进一步拓展了数据集在推理对齐、少样本学习与跨语言迁移中的应用边界,并催生了针对合成数据质量评估与去偏方法的研究,形成了从数据构建到模型评估的完整生态。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务