
遇见数据集

Trelis/VoxPopuli-Platinum-en

收藏
Hugging Face2026-05-30 更新2026-06-14 收录
官方服务:

资源简介:

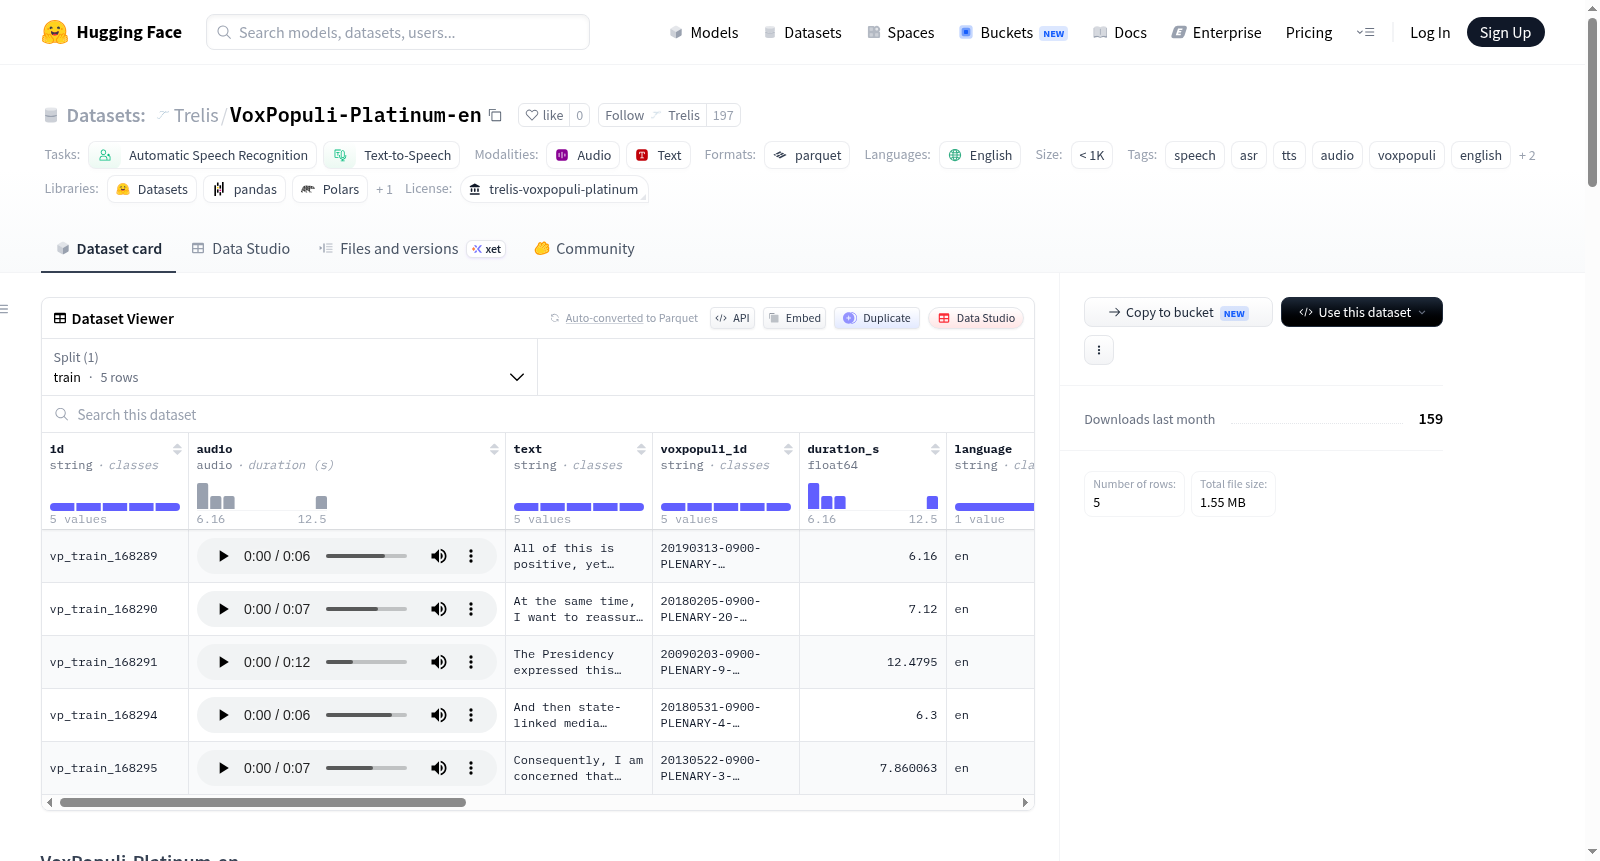
VoxPopuli-Platinum-en是一个英语语音数据集,基于VoxPopuli资源构建,包含142,066行数据,总计约404小时的16 kHz音频。数据集提供了清理后的训练文本、词级时间戳、说话人ID(部分来自原始VoxPopuli,部分通过推断获得),以及原始VoxPopuli的原始和标准化转录文本。元数据包括语言(英语)、性别、口音、是否为黄金转录等字段。该数据集适用于自动语音识别(ASR)微调、时间戳感知的ASR实验、字幕/对齐工作流程、说话人感知过滤和文本到语音(TTS)实验。数据以Parquet格式存储,分为10个分片,许可证为商业Trelis许可证,禁止重新分发。

VoxPopuli-Platinum-en is an English speech dataset based on VoxPopuli, containing 142,066 rows and approximately 404 hours of 16 kHz audio. It provides cleaned training text, word-level timestamps, speaker IDs (some preserved from original VoxPopuli, others inferred), and original VoxPopuli raw and normalized transcript texts. Metadata includes language (English), gender, accent, and whether the transcript is gold. The dataset is suitable for ASR fine-tuning, timestamp-aware ASR experiments, captioning/alignment workflows, speaker-aware filtering, and TTS experiments. Data is stored in Parquet format across 10 shards, with a commercial Trelis license that prohibits redistribution.
提供机构:
Trelis
搜集汇总
数据集介绍
Trelis/VoxPopuli-Platinum-en 数据集图片
构建方式
VoxPopuli-Platinum-en 数据集源自欧洲议会语音语料库 VoxPopuli,由 Trelis 公司通过内部专有启发式过滤与清洗流程构建而成。该流程旨在甄别并修复原始标签与音频之间的不匹配现象,剔除低质量样本,同时保留对自动语音识别任务有益的有效信号。数据集包含 142,066 条样本,累计约 404 小时的 16 kHz 英文语音,并辅以清洗后的训练文本、词级时间戳、说话人身份标识等丰富元信息。
特点
本数据集的核心特质在于其经过精炼的标签质量,显著优于原始 VoxPopuli 转录本。在多个评测集上的实验表明,基于该数据集微调的模型在词错误率上表现更优,同时避免了原始数据带来的域外性能退化。此外,数据集提供了多样化的说话人标识来源,包括直接保留的原始标识及通过匹配与聚类生成的推断标识,增强了数据的可追溯性与分析维度。
使用方法
该数据集适用于多种语音技术任务,包括自动语音识别微调、结合时间戳的识别实验、字幕生成与对齐工作流、基于说话人的数据筛选,以及文本转语音研究。对于 TTS 应用,建议将其视为带有说话人标识的议会语音数据,而非工作室级的声音克隆素材。使用者需通过邮件联系 Trelis 公司以获取商业许可,且数据集不允许再分发。
背景与挑战
背景概述
VoxPopuli-Platinum-en数据集由Trelis公司于2023年创建,专注于英语自动语音识别(ASR)与文本转语音(TTS)研究。该数据集源自大规模多语种议会语音语料库VoxPopuli,经过精细筛选与标注,最终包含约142,066条、总计404小时的16kHz英语语音片段。核心研究问题在于如何通过高质量标注数据提升ASR模型在跨领域场景下的泛化能力,避免传统大规模语音数据中标签噪声导致的域外性能退化。实验表明,基于该数据集微调的Qwen3-ASR-0.6B与Whisper Large v3 Turbo模型,在多个测试集上均显著优于使用原始VoxPopuli转录本的结果,尤其在保留域内精度的同时有效减少了域外误差,从而突显了数据质量对于语音识别系统鲁棒性的关键作用。该数据集已对ASR与TTS领域产生重要影响,成为验证数据清洗策略有效性的标杆资源。
当前挑战
该数据集所应对的核心领域挑战是语音识别中标注噪声引发的泛化能力下降问题。原始VoxPopuli转录本虽在域内(如议会语音)表现良好,但直接用于微调会严重损害模型在自然对话或脚本化语音等域外场景的识别准确率,例如Whisper Large v3 Turbo在Common Voice脚本化测试集上的词错误率(WER)从8.38%飙升至15.75%。构建过程中遇到的挑战在于设计精确的过滤与修复策略:Trelis需开发专有启发式算法以识别并剔除标签与音频不匹配的样本,同时保留VoxPopuli中有价值的语音特征。此外,数据来源的多样性导致说话人身份信息的缺失(约36%的行无原始ID),需借助声纹聚类与匹配技术推断说话人标签,这一过程需要在聚类精度与计算效率间取得平衡。最终,该数据集以商业许可形式发布,限制了其广泛复现与再分发。
常用场景
经典使用场景
VoxPopuli-Platinum-en作为经过严格清洗和标注的高质量英文语音数据集,其经典使用场景集中在自动语音识别(ASR)模型的微调与评估。相较于原始VoxPopuli数据,该数据集通过内部启发式规则剔除或修复了音频与文本不匹配的样本,保留了最具价值的语音信号。研究者和工程师常将其用于提升ASR模型的鲁棒性,特别是在跨领域泛化场景中,如议会语音的准确转写。
衍生相关工作
基于VoxPopuli-Platinum-en衍生的经典工作包括探索高质量数据筛选策略对语音模型训练的影响、对比不同音频洁净度下ASR微调效果的实证研究,以及开发融合说话人信息的端到端语音处理系统。此外,该数据集的词级时间戳特性推动了时序对齐技术的研究,并催生了若干结合注意力机制的语音识别与合成联合模型。
数据集最近研究
最新研究方向
VoxPopuli-Platinum-en数据集聚焦于高质量自动语音识别(ASR)与文本转语音(TTS)的前沿优化,通过精细化的标注清洗和说话人身份推断,显著提升了跨领域泛化能力。该数据集在学术界和工业界近期研究中成为热点,尤其在处理噪声标签导致领域外性能退化这一关键挑战上,展示了突破性进展——基于Trelis内部启发式过滤的“白金级”标注,使模型在VP-test、FLEURS等测试集上的词错误率(WER)相较原始转录本大幅降低,同时避免了传统微调对领域外数据的负面影响。这一方向呼应了语音领域对高质量、可审计训练数据的迫切需求,为构建鲁棒性更强的语音系统提供了新范式,对推动低资源场景下的ASR应用与多说话人TTS合成具有深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

