gsm8k-paraphrase-deepseek
收藏资源简介:
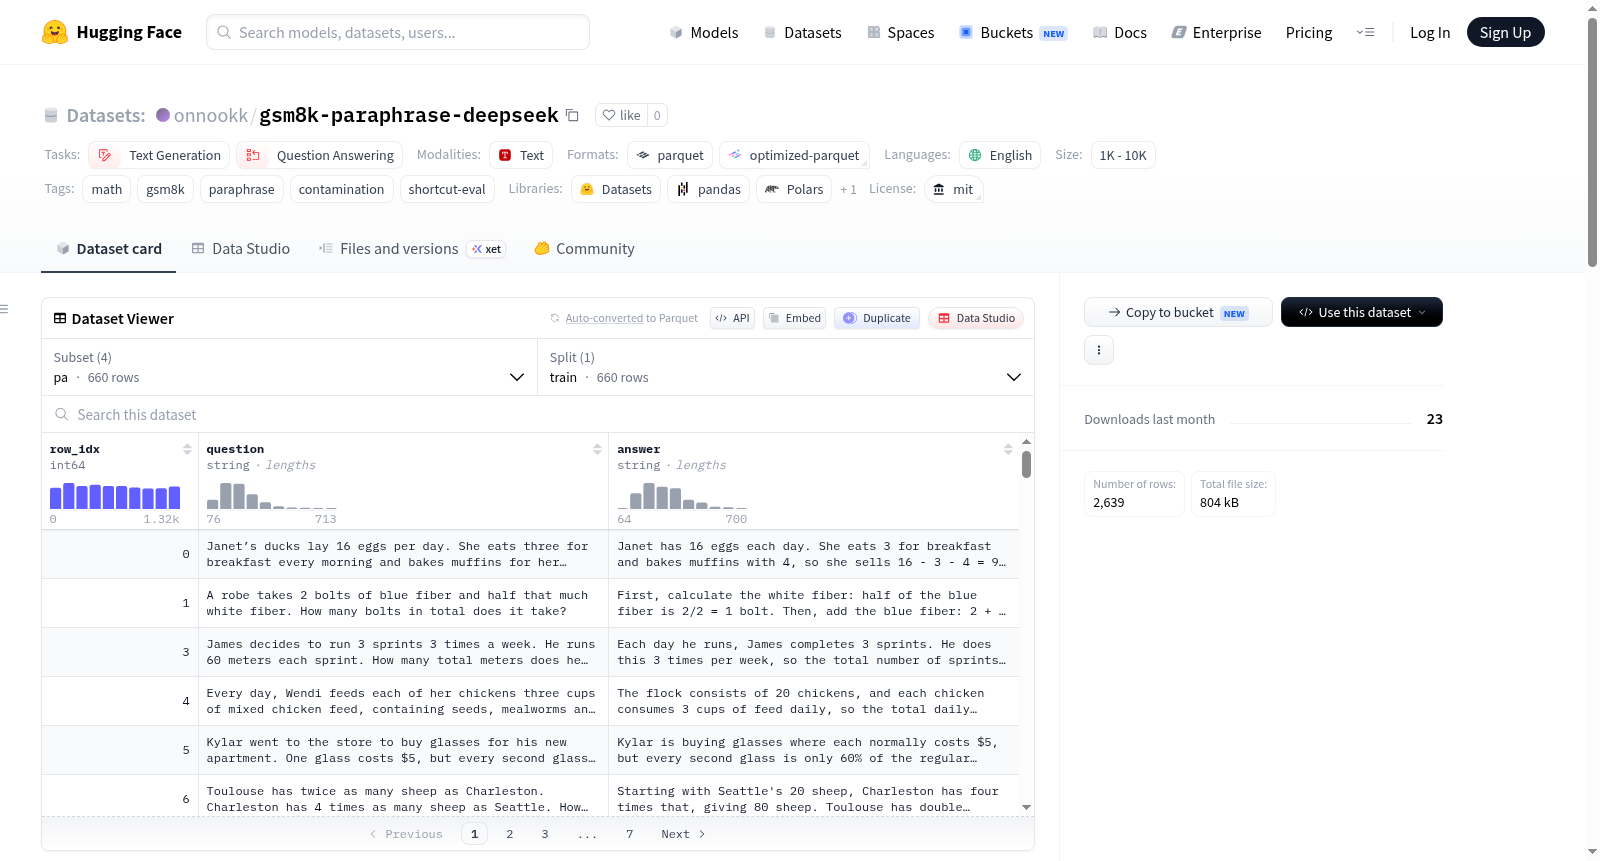
GSM8K重述变体数据集是基于GSM8K数学问题测试集构建的消融实验数据集,使用DeepSeek-v4-flash模型生成多种重述变体。该数据集旨在研究模型对数学问题的理解和推理能力,特别是在面对重述问题或推理链时的表现。数据集包含四个配置:pq配置包含DeepSeek重述的问题和原始GSM8K答案;pa配置包含原始GSM8K问题和DeepSeek重述的推理链;pqa配置包含DeepSeek重述的问题和推理链;pq_complement配置包含重述问题和原始答案,覆盖测试集剩余部分。每个样本包含三个字段:row_idx(在原始GSM8K测试集中的索引,0-1318)、question(问题文本,在pq、pqa、pq_complement中为重述版本,在pa中为原始版本)、answer(推理链文本,以#### N结尾,其中N为最终答案)。数据集总规模为1319个样本,其中前三个配置各包含660个样本(来自污染训练集的相同子集),第四个配置包含659个样本(剩余部分)。该数据集适用于数学问题求解、文本生成、问答系统等任务,可用于评估模型对问题重述的鲁棒性和推理能力。
The GSM8K rephrasing variant dataset is an ablation experiment dataset constructed based on the GSM8K math problem test set, using the DeepSeek-v4-flash model to generate multiple rephrasing variants. This dataset aims to study the models understanding and reasoning capabilities for math problems, especially when faced with rephrased questions or reasoning chains. The dataset includes four configurations: the pq configuration contains DeepSeek-rephrased questions and original GSM8K answers; the pa configuration contains original GSM8K problems and DeepSeek-rephrased reasoning chains; the pqa configuration contains DeepSeek-rephrased questions and reasoning chains; and the pq_complement configuration contains rephrased questions and original answers, covering the remaining part of the test set. Each sample contains three fields: row_idx (index in the original GSM8K test set, 0-1318), question (question text, rephrased version in pq, pqa, pq_complement, and original version in pa), and answer (reasoning chain text, ending with #### N, where N is the final answer). The total dataset size is 1319 samples, with the first three configurations each containing 660 samples (from the same subset of the contaminated training set), and the fourth configuration containing 659 samples (the remaining part). This dataset is suitable for tasks such as math problem-solving, text generation, and question-answering systems, and can be used to evaluate the robustness and reasoning capabilities of models in response to question rephrasing.
数据集概述:GSM8K Paraphrase Variants (DeepSeek-v4-flash)
基本信息
- 语言:英语
- 许可证:MIT
- 任务类别:文本生成、问答
- 标签:数学、GSM8K、释义、污染、捷径评估
- 数据集大小:1,000 < n < 10,000 条
- 数据集名称:GSM8K paraphrase variants (DeepSeek-v4-flash)
数据集结构与配置
该数据集包含 4 个配置,每个配置包含训练集,基于 GSM8K 测试集(共 1319 条数据)的子样本构建,子样本通过 random.Random(42).sample(range(1319), 660) 抽取。
| 配置名称 | 问题来源 | 答案来源 | 训练集行数 | 覆盖内容 |
|---|---|---|---|---|
pq |
DeepSeek 释义 | 原始 GSM8K 答案 | 660 | 660 条污染子样本 |
pa |
原始 GSM8K 问题 | DeepSeek 释义推理链 | 660 | 660 条污染子样本 |
pqa |
DeepSeek 释义 | DeepSeek 释义推理链 | 660 | 660 条污染子样本 |
pq_complement |
DeepSeek 释义 | 原始 GSM8K 答案 | 659 | 剩余 659 条保留项(补集) |
pq与pq_complement的并集可重构完整的 GSM8K 测试集(1319 条)。
数据字段
每条数据包含以下字段:
| 字段 | 类型 | 含义 |
|---|---|---|
row_idx |
int | 在 openai/gsm8k 测试集中的索引(0-1318) |
question |
str | 问题文本(在 pq、pqa、pq_complement 中为释义版本,在 pa 中为原始版本) |
answer |
str | 推理链后接 ` |
N` 格式的答案 |
构建方法
- 从 GSM8K 测试集中随机抽取 660 条子样本,与 M2 混合污染训练集一致,剩余 659 条作为
pq_complement配置。 - 使用 DeepSeek
deepseek-v4-flash模型对子样本进行:- 问题释义:重述问题,保留数字和正确答案。
- 答案释义(仅
pa、pqa):重述推理链,保留所有算术,以文字The answer is N.结尾。
- 将答案重新格式化为 `
N 后缀,以匹配 openai/gsm8k 格式。原始 GSM8K 答案中的计算标签(<<...>>`)被移除。
pq、pa、pqa配置通过api.deepseek.com释义;pq_complement通过阿里云 Dashscope OpenAI 兼容端点释义(同样使用deepseek-v4-flash模型)。
引用与许可证
- 继承 openai/gsm8k 的 MIT 许可证。
- 引用时需注明:
openai/gsm8k为原始测试集。- DeepSeek 为释义模型(
deepseek-v4-flash)。