
Anime Filler List Data
收藏官方服务:
资源简介:
一个开放数据集,将45部旗舰动漫的每一集分类为“正片”、“填充”或“混合”——总共9,552集。
This open dataset categorizes each episode of 45 flagship anime into three categories: main storyline episodes, filler episodes, and mixed episodes, totaling 9,552 episodes.
创建时间:
2026-08-19
原始信息汇总
数据集概述
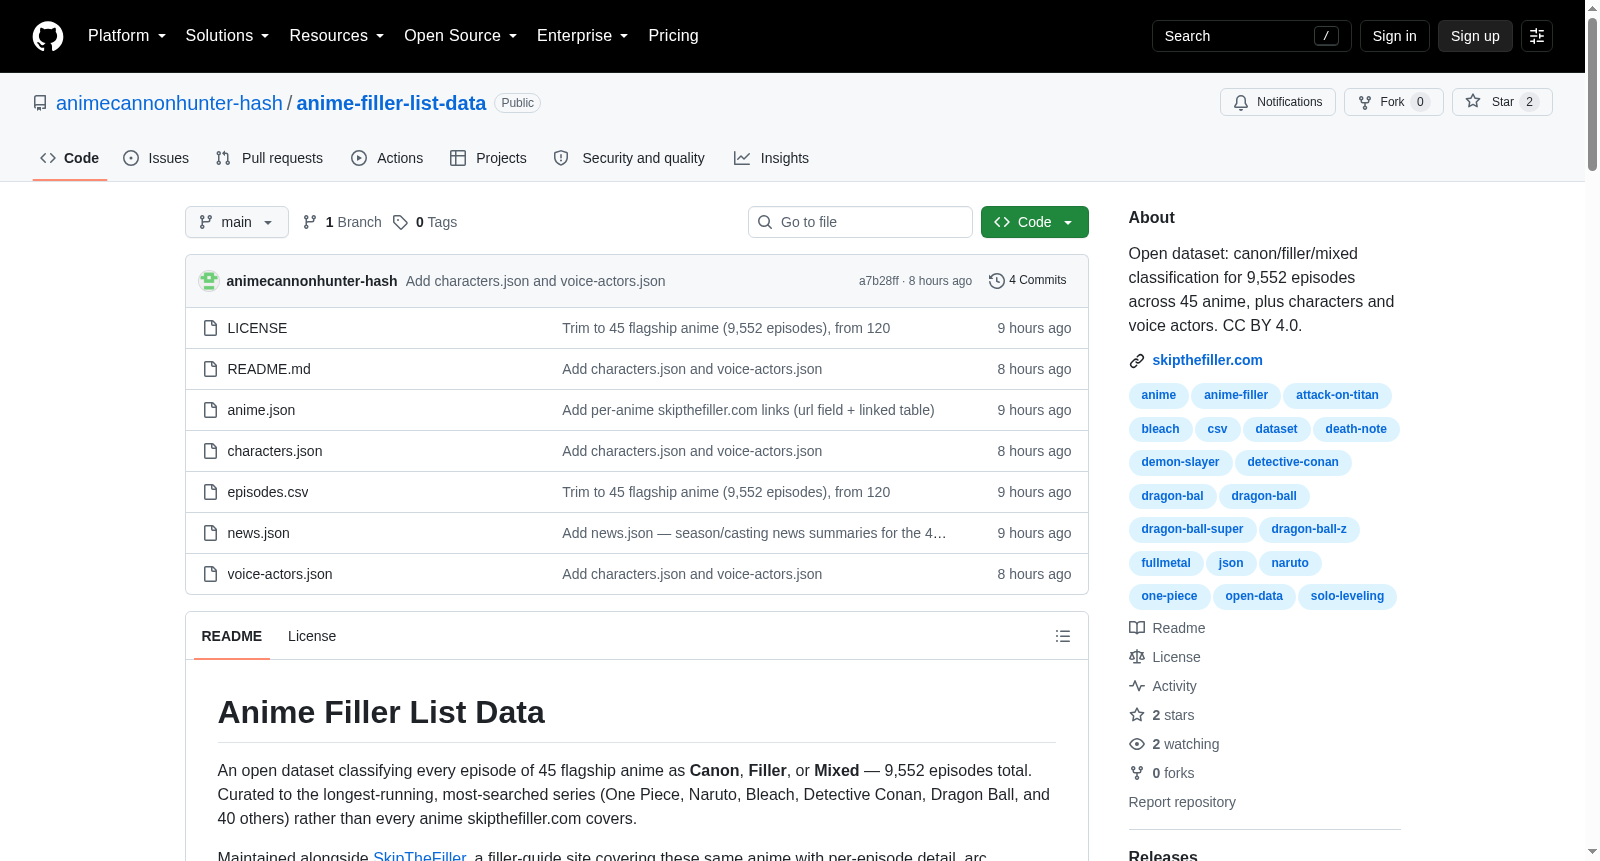
Anime Filler List Data 是一个开放数据集,对45部主流长篇动漫的每一集进行分类,标注为 原作集数(Canon)、原创集数(Filler) 或 混合集数(Mixed),总计覆盖9,552集。该数据集聚焦于播放时间长、搜索量高的系列作品,如《海贼王》、《火影忍者》、《死神》、《名侦探柯南》、《龙珠》等,而非收录 SkipTheFiller 网站上的全部动漫。
数据文件
| 文件 | 说明 |
|---|---|
anime.json |
每部动漫一条记录(包含别名、标题、类型、制作公司、集数统计),并嵌套其全部分集信息 |
episodes.csv |
同一数据扁平化为每集一行,便于使用电子表格或数据分析工具处理 |
news.json |
每部动漫的简短事实性新闻摘要(如季度公告、配音、改编消息),以动漫别名为键 |
characters.json |
每部动漫的角色信息(角色、阵营/团体、标签、投票数),以动漫别名为键 |
voice-actors.json |
出现在这些动漫中的声优列表,按声优去重,包含其配音的每部动漫、角色、语言 |
数据结构
动漫条目字段:
| 字段 | 类型 | 说明 |
|---|---|---|
slug |
string | 与 skipthefiller.com 的 URL 别名一致 |
title |
string | 动漫标题 |
genres |
string[] | 类型列表 |
studio |
string | null |
premiered |
string | null |
status |
string | Ongoing(连载中)或 Completed(已完结) |
totalEpisodes |
number | 总集数 |
canonCount / fillerCount / mixedCount |
number | 各类别集数统计 |
url |
string | 该动漫在 skipthefiller.com 的具体页面链接 |
episodes |
array | 分集列表(结构见下) |
分集条目字段:
| 字段 | 类型 | 说明 |
|---|---|---|
number |
number | 集数 |
title |
string | 集标题 |
type |
"Canon" |
"Filler" |
arc |
string | null |
airDate |
string (YYYY-MM-DD) |
null |
覆盖动漫列表(45部)
该数据集收录了以下动漫(节选):One Piece(1173集)、Naruto: Shippuden(500集)、Bleach(408集)、Detective Conan(1209集)、Dragon Ball(153集)等。完整列表见 README 文件中的表格,每部动漫均提供集数、原作集数、原创集数、混合集数统计。
数据特性
- 快照日期:2026-08-19。本数据集是特定时间点的导出文件,非实时更新;最新分类可在 SkipTheFiller 查看。
- 许可协议:采用 CC BY 4.0 许可,允许任何用途(包括商业项目),但需注明来源,链接至 skipthefiller.com。
- 关联网站:该数据集与 SkipTheFiller 同步维护,后者提供分集详情、篇章划分及原创时间计算器。
搜集汇总
数据集介绍
构建方式
该数据集以SkipTheFiller网站为数据源,精选了45部备受关注的长篇动漫,覆盖了《海贼王》《火影忍者》《死神》等经典及热门作品,共计9,552集。数据以结构化形式呈现,包含多个文件:anime.json存储每部动漫的元数据及其嵌套的剧集信息,episodes.csv则将其扁平化以方便表格处理;news.json记录每部动漫的简要新闻,characters.json与voice-actors.json分别提供角色和声优数据。每条剧集记录均标注了其类别(原作、原创或混合)、所属篇章及播出日期,构建方式严谨且具有可扩展性。
使用方法
使用该数据集时,可根据需要选择合适的文件格式:若希望解析嵌套结构,可读取anime.json;若偏好行列式数据,可直接加载episodes.csv至数据分析工具(如Pandas)。通过关键字段如slug(标识符)可关联不同文件,例如将episodes.csv与characters.json中的角色信息结合,或利用voice-actors.json分析声优多作品参演情况。数据集中每集的type字段便于快速筛选出仅观看原作或原创部分的列表,而arc和airDate字段则支持按篇章或时间进行深入分析。用户亦可访问skipthefiller.com获取实时更新版本,本数据集可作为历史快照用于研究或应用开发。
背景与挑战
背景概述
Anime Filler List Data数据集由SkipTheFiller团队于2026年8月19日发布,旨在系统性地分类45部旗舰动漫的每一集为原作、填充或混合类型,总计覆盖9,552集。该数据集的核心研究问题在于解决动漫社群中长期存在的填充集识别难题,为观众提供精准的跳过指南。其依托于持续更新的网站SkipTheFiller,并为研究者提供了结构化数据(包括角色、声优及新闻摘要),在动漫分析领域具有开创性意义,为内容推荐、叙事结构研究及观众行为分析提供了宝贵资源。
当前挑战
该数据集面临的挑战多维且复杂。在领域层面,动漫填充集的判定缺乏统一标准,常因主观解读而异,尤其当一集同时包含原作和填充内容时(如'Mixed'类型),准确标注成为难题。此外,数据集的时效性构成严峻挑战,由于新剧集持续播出及分类可能修订,静态快照无法实时反映变化,导致数据滞后。构建过程中,团队需处理跨文化语义差异、不同动画工作室的叙事风格差异,以及从海量剧集和角色信息中提取一致且无冗余的数据,同时确保所有分类的客观性和可验证性,这要求高度严谨的方法论和持续的人工审核。
常用场景
经典使用场景
该数据集在动漫内容分析与推荐系统领域具有经典应用价值。研究者可基于其细粒度的剧集分类(正典、填充、混合)及元数据(如播出时间、剧情篇章),构建动漫观看路径优化模型,帮助观众跳过填充内容以提升观看体验。此外,该数据亦适用于叙事结构分析,通过比较不同长篇动漫的填充比例及分布模式,探究改编自漫画的动画在节奏控制上的共性与差异,为研究动漫产业生产逻辑提供量化依据。
解决学术问题
此数据集解决了动漫研究中长期存在的‘填充内容’标注缺失与标准不一问题。此前学术界对动漫改编忠实度的探讨多依赖定性判断,缺乏系统化、可验证的数据支持。该数据集以明确的三分类标注和跨45部旗舰作品的覆盖,为研究者提供了标准化基准,使得量化分析动画与源材料的偏离程度、填充内容对观众留存及叙事连贯性的影响成为可能。其公开的CC BY 4.0许可亦促进了可复现研究,推动了计算媒体学与粉丝文化研究的实证转向。
实际应用
在实际应用层面,该数据集已赋能SkipTheFiller网站,为全球观众提供跳过填充剧集的指引,显著优化了长篇动漫的观看效率。其结构化的数据亦可直接集成至流媒体平台或第三方观看辅助工具中,实现自动精准的剧集推荐与导航。此外,数据集中角色、声优及新闻摘要等信息,可用于构建动漫知识图谱,支持智能问答、角色关联分析及跨作品声优检索等应用,从而提升用户体验并拓展动漫IP的数字化服务场景。
数据集最近研究
最新研究方向
在全球动漫产业蓬勃发展的浪潮中,长篇连载动画的剧情分类研究正成为连接内容生产与受众体验的关键纽带。该数据集以45部标志性动漫的9552集为样本,开创性地引入Canon、Filler与Mixed的三元分类体系,精准映射了动画改编中原创剧情与主线故事的复杂交织。其研究价值不仅体现在对'跳剧'现象的量化解析,更延伸至内容消费行为分析、流媒体播放策略优化以及动漫创作模式的文化批判等前沿领域。通过整合制作公司、角色声优及新闻动态的多维数据,该数据集为理解日本动画产业的叙事结构、粉丝经济效应及跨媒介传播提供了结构化视角,尤其为长跑作品的内容冗余与观众留存率的相关性研究奠定了数据基础。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


