
nycu-ai113-dl-final-project/TurtleBench-extended-zh
收藏官方服务:
资源简介:
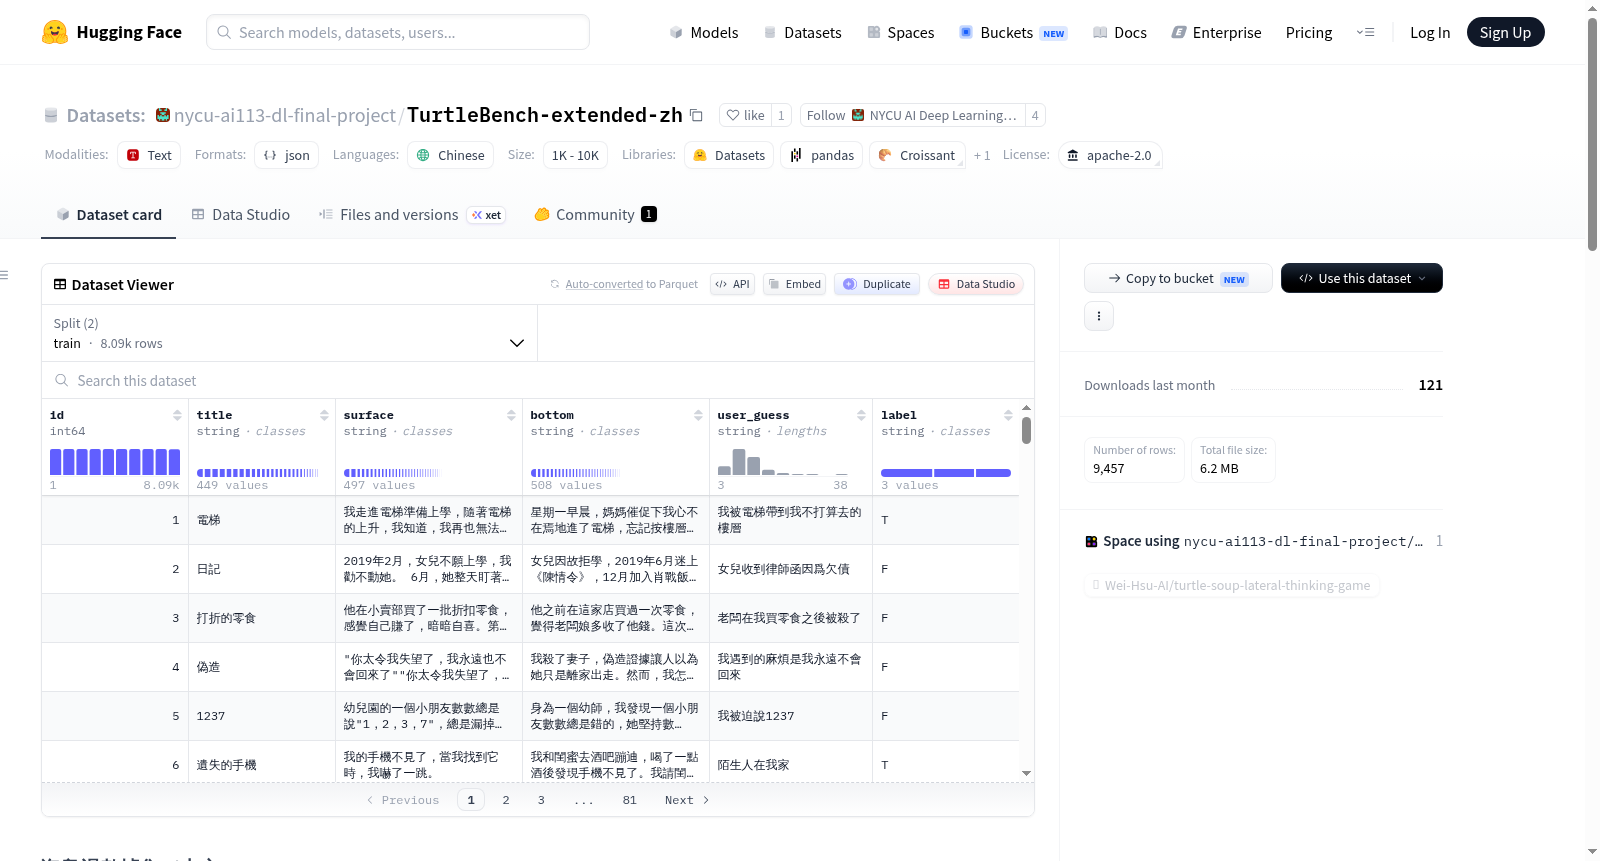
本数据集包含中文的海龜湯謎題,用于逆向思维游戏。数据集包括训练集和测试集,分别包含8000条和1500条数据。每个数据条目包含id、title、surface、bottom、user_guess和label等字段。
This dataset contains Chinese turtle soup riddles, used for reverse thinking games. The dataset includes a training set with 8000 entries and a test set with 1500 entries. The structure of the dataset includes id, title, surface, bottom, user_guess, and label.
搜集汇总
数据集介绍
构建方式
TurtleBench-extended-zh数据集立足于中文逆向思维推理领域,以Duguce/TurtleBench1.5k为基础进行系统性扩展。构建过程融合了四种互补策略:翻译生成数据通过将中文文本经韩文中转再译回中文,在保持语义逻辑的同时注入多样性,占比59.0%;手动标注聚焦于生成与问题无关的推测样本,以均衡标签分布,占20.0%;基准题库专门设计高难度推理情境,提供标准化测试基准,占15.0%;模型生成数据借助语言模型产出初始样本,再经人工筛选优化,占6.0%。最终形成包含10000条样本的数据集,其中训练集8000条、测试集2000条,确保测试故事与训练故事无重叠。
特点
该数据集的核心特点在于其精心设计的标签体系与均衡的类别分布。每条记录包含id、title、surface、bottom、user_guess和label六个字段,其中label分为T(正确推测,46.4%)、F(错误推测,42.4%)和N(无关推测,11.2%)三类,通过手动标注显著提升了N类样本的比例,使模型能够更精准地识别无关推理。数据集的构建策略兼顾了逻辑严谨性与内容多样性,翻译生成保证了语义的连贯性,基准题库涵盖了从日常谜题到复杂情境的广泛推理场景,而模型生成与人工筛选的结合则进一步扩充了推理边界的覆盖范围。整体上,该数据集为评估和提升语言模型在逆向思维游戏中的推理能力提供了高质量的基准。
使用方法
该数据集专为海龟汤游戏中的逆向推理任务设计,适用于训练和评估语言模型的逻辑推断能力。使用时,用户可将surface字段作为模型输入,要求模型基于表面线索预测bottom所隐藏的深层背景;user_guess字段可用于模拟玩家猜测过程,而label字段则作为监督信号指导模型学习正确、错误与无关推测的判别。数据集已预分割为训练集(8000条)和测试集(2000条),可直接加载用于模型微调或零样本评估。推荐采用序列到序列或分类架构,将推理任务转化为答案生成或标签预测问题。此外,基准题库部分可用于标准化测试,以横向对比不同模型在复杂推理情境下的表现。
背景与挑战
背景概述
海龜湯謎題作為一種經典的逆向思維遊戲,長期以來被廣泛用於測試人類的邏輯推理與情境分析能力。然而,在自然語言處理領域,針對此類高階推理任務的數據資源極為稀缺,限制了相關模型在複雜推理場景中的表現。為填補這一空白,國立陽明交通大學人工智慧113深度學習課程團隊於近期構建了TurtleBench-extended-zh數據集,該數據集基於Duguce等人發布的TurtleBench1.5k進行擴展,旨在為中文環境下的海龜湯遊戲提供高質量、多樣化的推理數據。研究團隊通過翻譯、手動標註、基準題庫構建及模型生成等多種方法,系統性地豐富了數據的邏輯層次與語言覆蓋面,使其成為評估和提升大型語言模型在逆向推理、常識推理以及多步因果推斷能力的重要基準。該數據集的誕生不僅推動了中文推理數據庫的發展,也為學術界探索語言模型在開放式推理任務中的潛力提供了堅實的基礎。
当前挑战
當前數據集面臨的核心挑戰主要體現在兩個層面。其一,在領域問題層面,海龜湯遊戲本質上要求模型具備從碎片化線索中還原隱含因果鏈的能力,這遠超傳統的文本分類或問答任務,現有模型往往難以準確區分正確推測(T)、錯誤推測(F)與無關推測(N),尤其無法有效處理邏輯陷阱與信息缺失導致的歧義情境。其二,在數據構建過程中,團隊需克服多個難點:原始數據僅含1500筆,標籤分布不均(無關推測僅佔11.2%),為平衡類別需大量人工標註;翻譯擴增雖提升多樣性,卻可能引入語義漂移或文化適應性問題;模型生成數據雖效率高,但需經嚴格人工篩選以剔除邏輯矛盾樣本。此外,確保訓練集與測試集故事無重疊,對數據分割策略的精確性提出了極高要求,這些挑戰共同制約著數據集的規模與推理任務的難度上限。
常用场景
经典使用场景
TurtleBench-extended-zh数据集的核心应用在于评估和提升大语言模型在逆向推理与逻辑演绎任务中的表现。海龟汤谜题作为一种独特的语言游戏,要求模型从表层线索出发,逐步逼近隐藏的深层情境,这天然契合了机器常识推理与因果推断的研究需求。该数据集通过精心设计的1500条原始样本与多策略扩增,为模型提供了丰富的正误与无关推理样例,使其成为检验模型能否在信息不完备条件下进行多步逻辑链推理的权威基准。研究者常利用此数据集构建零样本或少样本评测任务,系统性地考察模型对隐性知识、反事实思维以及语境矛盾识别的能力,从而推动语言智能在复杂叙事理解领域的进步。
解决学术问题
该数据集有效解决了当前自然语言处理领域在评估模型深层推理能力时面临的样本稀缺与场景单一问题。传统基准测试多聚焦于事实问答或简单逻辑关系,难以触及人类思维中的逆向推理与假设检验过程。TurtleBench-extended-zh通过引入海龟汤这一需要从结果反推原因、从表象挖掘本质的谜题形式,填补了学术界对非单调推理与开放域常识验证的评测空白。其多标签机制(T/F/N)不仅能够区分正确与错误推理,还可识别无关干扰,为研究模型在噪声信息下的鲁棒性提供了独特视角。这一数据集的发布促使学界重新审视语言模型在模拟人类创造性思维方面的局限,并催生了针对隐性前提挖掘与多步推理链构建的新方法论。
衍生相关工作
围绕TurtleBench-extended-zh数据集,学术界已衍生出多项具有影响力的研究工作。其一,研究者基于该数据集提出了面向逆向推理的提示工程优化策略,通过设计多轮对话式提示框架显著提升了GPT系列模型在复杂谜题上的准确率。其二,有工作将海龟汤任务与知识图谱结合,构建了显式推理路径可视化系统,揭示了模型在隐含关系抽取中的薄弱环节。此外,该数据集还被用作对抗性训练的基础资源,衍生出专门针对无关干扰(N类标签)的鲁棒性增强算法。近期,有团队在此基础上扩展出多语言版本,并引入跨文化背景的谜题,探索了不同语言模型在常识推理上的文化偏差,这些成果共同推动了可解释推理与可信AI的边界拓展。
以上内容由遇见数据集搜集并总结生成


