28kTeluguQa
收藏资源简介:
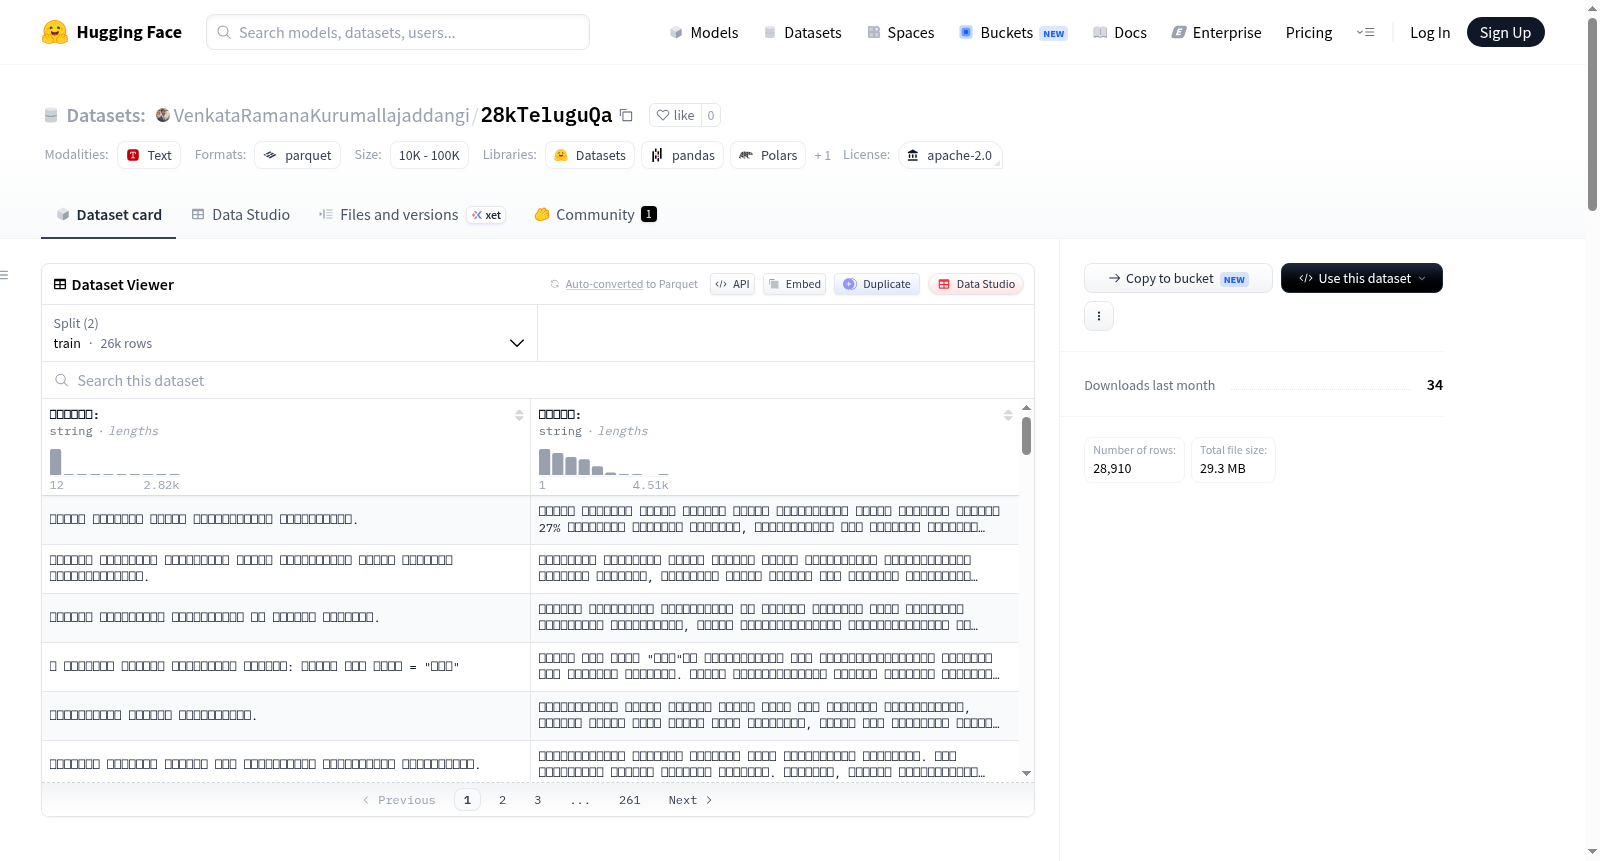
该数据集是一个泰卢固语(Telugu)问答对数据集,包含两个字段:ప్రశ్న:(问题)和జవాబు:(答案)。数据集划分为训练集和验证集,其中训练集包含26,019个样本,验证集包含2,891个样本,总计约28,910个样本。数据集以Apache-2.0许可证发布,适用于泰卢固语的问答任务、文本生成或语言模型微调等自然语言处理应用。
This dataset is a Telugu question-answer pair dataset, containing two fields: ప్రశ్న: (question) and జవాబు: (answer). The dataset is split into training and validation sets, with 26,019 samples in the training set and 2,891 samples in the validation set, totaling approximately 28,910 samples. It is released under the Apache-2.0 license and is suitable for natural language processing applications such as question answering, text generation, or language model fine-tuning in Telugu.
数据集概述
数据集名称: 28kTeluguQa
简介: 该数据集是一个泰卢固语(Telugu)问答(QA)数据集,包含约2.8万条问答对,内容为泰卢固语的问题和对应的答案。
数据集规模与划分:
- 训练集(train): 26,019 条样本,占用约 73.2 MB
- 验证集(validation): 2,891 条样本,占用约 7.9 MB
- 总数据集大小: 约 81.1 MB
- 下载大小: 约 29.3 MB
数据字段:
- ప్రశ్న(问题): 字符串类型,表示泰卢固语的问题
- జవాబు(答案): 字符串类型,表示对应的泰卢固语答案
文件格式与配置:
- 配置文件名为
default - 训练集文件路径:
data/train-* - 验证集文件路径:
data/validation-*
许可证:
- Apache 2.0
用途与限制:
- 数据集卡片中未提供具体的用途、创建背景、数据来源、标注过程、偏差与局限性等详细信息(均标记为“[More Information Needed]”)。
- 提示用户应了解数据集的潜在风险、偏差和局限性,但未给出进一步的具体建议。
引用与联系:
- 未提供引用格式(BibTeX、APA)、术语表、额外信息、数据集卡片作者及联系方式。
注意: 该README文件是基于Hugging Face公开的模板生成的,大部分描述性内容为占位符,实际有效的关键信息集中在数据集的规模、划分、字段和许可证部分。