遇见数据集

REALIS

收藏
arXiv2026-09-26 更新2026-10-01 收录
官方服务:

资源简介:

REALIS是由莫斯科国立大学人工智能研究所等机构构建的大规模AI图像检测数据集,包含143万张真实与合成图像,覆盖42种现代文本到图像生成模型,涵盖开源与专有系统。数据集通过从真实图像自动生成提示、多阶段质量过滤和分层采样策略,有效减少类别特定偏差并保持内容多样性,其中真实与合成图像在语义和视觉特征上高度对齐。构建过程包括严格的真实图像筛选、对称的联合过滤以及基于密度和聚类的困难样本采样,最终形成训练、验证、测试及专家子集。该数据集旨在为评估AI图像检测器在跨生成器泛化、图像处理鲁棒性等实际挑战中的表现提供统一基准,推动检测技术在媒体取证和内容审核等领域的可靠性提升。

REALIS is a large-scale AI image detection dataset constructed by the AI Research Institute of Lomonosov Moscow State University and other institutions. It contains 1.43 million real and synthetic images, covering 42 modern text-to-image generation models including both open-source and proprietary systems. The dataset adopts automatic prompt generation from real images, multi-stage quality filtering and hierarchical sampling strategies, which effectively mitigates category-specific biases and maintains content diversity, with real and synthetic images highly aligned in semantic and visual features. Its construction process involves strict real image screening, symmetric joint filtering, and density-and-clustering based hard sample sampling, ultimately forming training, validation, test and expert subsets. This dataset is designed to provide a unified benchmark for evaluating the performance of AI image detectors in practical challenges such as cross-generator generalization and robustness against image processing, and to advance the reliability enhancement of detection technologies in fields such as media forensics and content moderation.

创建时间:
2026-09-26
原始信息汇总

REALIS 数据集概述

基本信息

  • 数据集名称:REALIS(匿名发布版本)
  • 任务类型:图像分类(image-classification)
  • 标签:image、ai-generated-image-detection
  • 发布形式:作为匿名提交的一部分,发布数据集的一部分,主要为测试划分(test split)

数据集摘要

  • 图像总数:100,000 张
    • 真实图像:50,000 张
    • AI 生成图像:50,000 张
  • 生成来源:AI 生成图像来自 10 个文本到图像(text-to-image)生成器
  • 用途:用于评估二分类的真实图像与生成图像检测器

构建方式

  • 构建细节在提交的论文中呈现

文件与组织

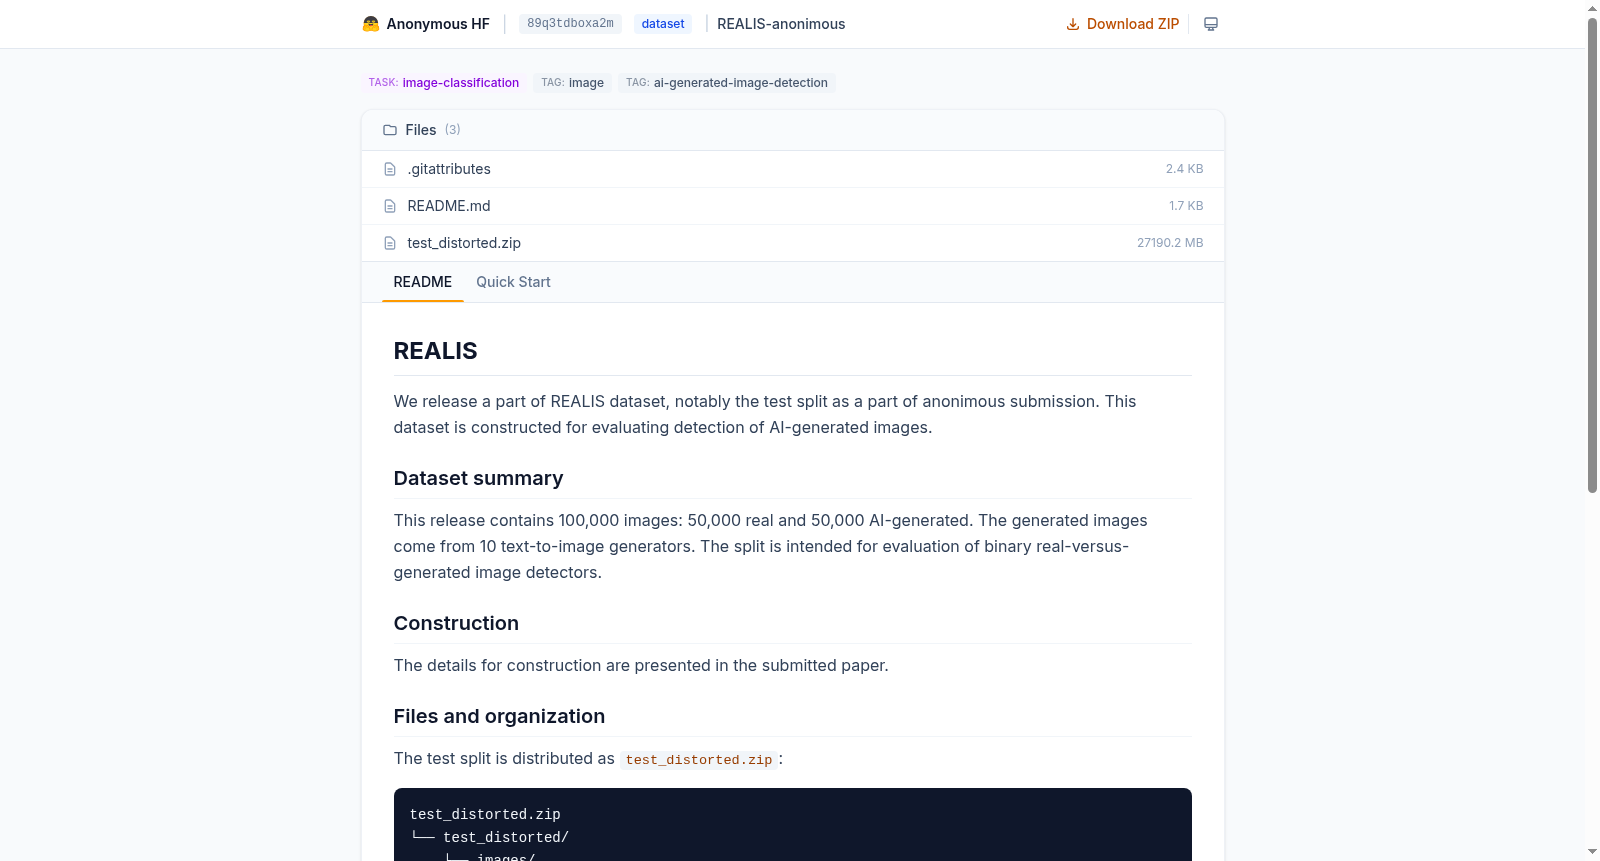
测试划分以 test_distorted.zip 分发,目录结构如下:

test_distorted.zip └── test_distorted/ ├── images/ │ ├── real/ │ │ ├── XXX.jpg │ │ └── ... │ ├── flux_1/ │ │ ├── XXX.jpg │ │ └── ... │ └── .../ ├── labels/ │ ├── labels-0-3125.csv │ └── ... └── img_paths.ft

  • images/:图像目录,按来源标识(real 或文本到图像生成器名称)
  • labels/:包含标注 CSV 文件
  • img_paths.ft:附带的图像路径索引

文件清单

  • .gitattributes(2.4 KB)
  • README.md(1.7 KB)
  • test_distorted.zip(27190.2 MB)

推荐评估方法

  • 发布的验证划分支持对单个样本进行独立检查,并评估生成图像的质量、内容多样性以及真实图像与生成图像之间主题的相似性
  • 使用连续检测器分数报告 ROC-AUC
  • 该划分支持评估匿名提交中描述的检测器及测试结果
搜集汇总
数据集介绍
REALIS 数据集图片
构建方式
面对AI生成图像检测领域长期存在的基准偏差与泛化瓶颈,REALIS的构建立足于内容对齐与对称过滤的核心理念。其起点为逾千万幅开放用户生成图像,经去重、几何质量、内容构成、来源水印及视觉语言模型五重级联筛选,保留约二百九十万幅高质量真实图像;继而借助视觉语言模型与指令微调语言模型为每幅真实图像生成紧凑的内容描述提示,并将其分配给三至四款随机选取的文本到图像模型进行渲染,确保真伪样本在语义层面高度匹配。随后对两类图像施以对称滤波,滤除生成失败样本,最终形成四百二十万幅图像池。采样阶段采用密度准则与分层聚类两种互补策略,分别构建面向难例的Expert子集与保持内容多样性的基础划分,所有划分以提示为粒度严格隔离,杜绝内容泄漏。
特点
REALIS的显著特征在于其规模、多样性与难度梯度的有机结合。数据集涵盖一百四十三万幅图像,由四十二款当代文本到图像模型生成,其中既包括Stable Diffusion、FLUX、Kandinsky等开源谱系,亦涵盖GPT-Image-2、Nano-Banana-2、Imagen-4-Ultra等十二款闭源前沿系统,时间跨度从二〇二二至二〇二六年,覆盖潜在扩散、流匹配、自回归及统一多模态等多种生成范式。为系统评估检测器鲁棒性,REALIS设计了包含三十五类变换、五个强度等级的退化流水线,涉及模糊、色彩失真、算法压缩、神经压缩、多重再压缩、噪声、亮度调整、几何变换、空间畸变、隐形水印及对抗攻击等十一组操作,并以随机链式方式组合施加于验证、测试与Expert划分,同时保留干净版本以供配对分析。此外,REALIS-Expert子集通过局部对数密度比准则筛选出统计上最难归因的样本,使真伪类分布高度对齐,从而剥离语义与光度捷径,为检测器提供更具挑战性的评估基准。
使用方法
REALIS为AI生成图像检测研究提供了统一的评估框架与基准协议。使用者可利用REALIS-Base的一百一十万训练图像、十万验证与十万测试图像进行模型微调与泛化测试,其中训练、验证与测试划分按生成器质量与架构家族梯度分配,难度递增;REALIS-Expert则作为压力测试子集,包含十三万幅语义与视觉特征高度匹配的真伪图像,用于评估检测器在类分布对齐条件下的判别能力。评估指标以ROC-AUC为主,辅以生成器宏平均AUC、假阳性率、假阴性率、召回率及F1分数,以全面刻画操作点行为。对于鲁棒性分析,使用者可将干净图像与经退化流水线处理的失真版本进行配对比较,流水线记录了每幅图像的变换链与强度参数,支持按变换类型、组别及强度等级进行细粒度诊断。基准测试涵盖预训练专用检测器、在REALIS上微调的模型以及零样本视觉语言模型,并鼓励在跨生成器与跨后处理偏移条件下联合评估检测器的可靠性与泛化边界。
背景与挑战
背景概述
生成式人工智能的迅猛演进使文本到图像合成系统产出的图像愈发逼真,深度伪造检测遂成为媒体取证与内容审核的关键屏障。2026年,由莫斯科国立大学人工智能研究所与俄罗斯科学院可信人工智能研究中心等机构联合发布的REALIS数据集,恰在此背景下问世。该数据集包含约143万幅真实与合成图像,覆盖42个当代文本到图像生成器,其中既有Stable Diffusion、FLUX等开源模型,亦囊括GPT-Image-2、Nano-Banana-2等专有系统。其核心研究问题在于突破既有基准因内容错位与生成器偏见所致的评估失真,通过由真实图像衍生提示词、对称过滤与分层采样,构建内容对齐、难度递进的评测框架,并配套发布面向高质量合成图像的REALIS-Expert压力测试子集,为检测器的跨生成器泛化与后处理鲁棒性提供统一度量。
当前挑战
REALIS所直面的领域难题根植于检测器在真实应用场景中的三重脆弱性:面对未见生成器时泛化能力骤降,图像内容偏离训练分布时判别依据失效,以及图像经由压缩、缩放、水印等常见在线媒体处理后检测性能急剧衰退。构建过程中,亦面临诸多技术挑战:需从千万级网络图像中剔除水印、低质与重复样本以消除类别捷径,同时保持真实与合成图像在语义与视觉特征上的紧密对齐;需设计密度比准则以在不依赖检测器预测的前提下甄选出统计上最难归属的样本,避免将现有模型的盲区编码进数据集;还需建立涵盖35种变换、五级强度的退化流水线,以模拟复合处理链并保留各阶段参数,从而支撑可追溯的鲁棒性分析。
常用场景
经典使用场景
在AI生成图像检测领域,REALIS的经典使用场景在于跨生成器泛化与后处理鲁棒性的联合评测。其构建的1.43M图像覆盖42种当代文生图模型,真伪两类数据经由内容对齐提示、对称过滤与分层采样,并配有35种五级强度退化流水线。研究者依此可将检测器置于生成器迁移与图像处理双重偏移下,系统评估其排序与判决表现的衰减规律,从而摆脱对特定数据捷径的依赖,获得贴近部署条件的可靠性刻画。
衍生相关工作
REALIS的发布催生并支撑了一系列后续研究:NTIRE 2026鲁棒AI图像检测挑战赛即以其42生成器与复合退化协议为基准,推动稳健检测器的发展;面向生成器归因与内容偏差的分析工作借助其生成器感知划分,审视训练暴露与迁移难度的非线性关系;此外,针对神经网络压缩、水印嵌入及对抗攻击的检测脆弱性研究亦在其流水线上展开系统评测,进一步拓展了AI图像取证的方法论边界。
数据集最近研究
最新研究方向
在AI生成图像检测领域,生成器泛化与后处理鲁棒性长期被割裂评估,REALIS数据集以143万图像、42个当代文生图模型为基石,将语义对齐、生成器多样性及35种五级强度退化变换纳入统一框架,并构建REALIS-Expert困难子集,使检测器在内容匹配与分布对齐条件下接受压力测试;该工作揭示轻微处理即可致性能骤降,假阳性成为主要误差源,推动领域从单一基准精度转向跨生成器与跨退化联合评估,为媒体取证和内容审核提供更贴近真实部署的可靠性标尺。
相关研究论文
  • 1
    REALIS: A Curated Dataset for Studying the Challenges of AI Image Detection莫斯科国立大学·人工智能研究所; 俄罗斯科学院·可信人工智能研究中心; 罗蒙诺索夫莫斯科国立大学 · 2026年
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务