
leminda-ai/s2orc_small
收藏官方服务:
资源简介:
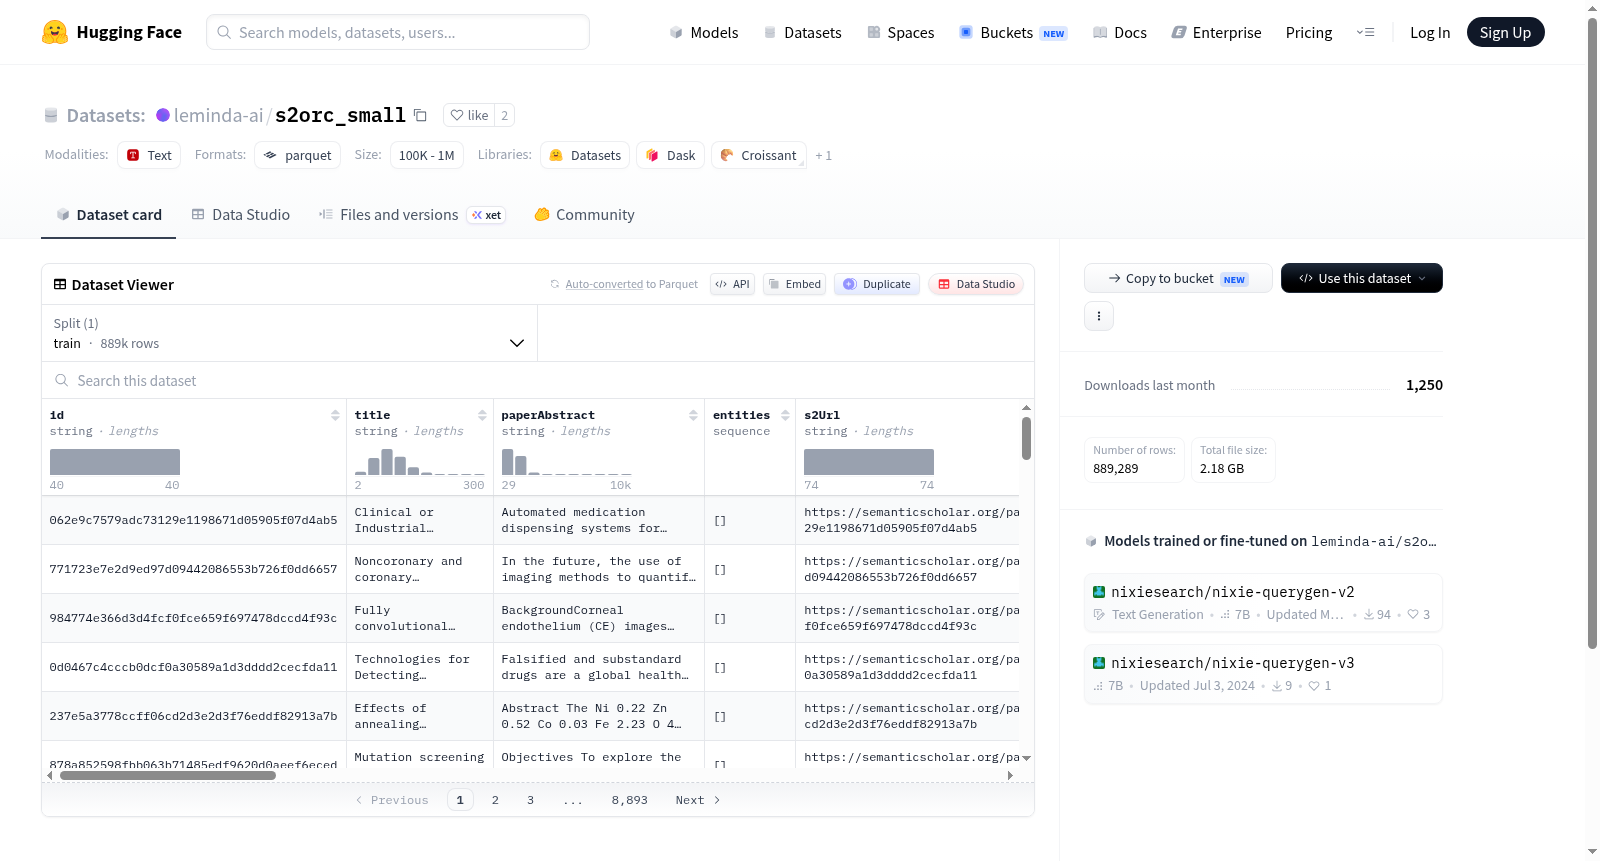
这是一个名为s2orc_small的小型数据集,包含约90万篇英文论文,每篇论文都包含摘要。数据集的结构包括多个特征字段,如论文ID、标题、摘要、实体、作者信息、引用信息等。
This is a small dataset named s2orc_small, which contains approximately 900,000 English papers, each with an abstract. The structure of the dataset includes multiple feature fields such as paper ID, title, abstract, entities, author information, citation information, and others.
提供机构:
leminda-ai原始信息汇总
数据集概述
数据集名称
"s2orc_small"
数据集描述
包含约90万篇英文论文,每篇论文均包含摘要。
数据集特征
- id: 字符串类型
- title: 字符串类型
- paperAbstract: 字符串类型
- entities: 字符串序列
- s2Url: 字符串类型
- pdfUrls: 字符串序列
- s2PdfUrl: 字符串类型
- authors: 列表,包含:
- name: 字符串类型
- ids: 字符串序列
- inCitations: 字符串序列
- outCitations: 字符串序列
- fieldsOfStudy: 字符串序列
- year: 整数类型(int32)
- venue: 字符串类型
- journalName: 字符串类型
- journalVolume: 字符串类型
- journalPages: 字符串类型
- sources: 字符串序列
- doi: 字符串类型
- doiUrl: 字符串类型
- pmid: 字符串类型
- magId: 字符串类型
数据集分割
- train:
- 数据量: 1725313131.1503427 字节
- 示例数量: 889289
数据集大小
- 下载大小: 2180008218 字节
- 数据集大小: 1725313131.1503427 字节
搜集汇总
数据集介绍
构建方式
在学术文献挖掘领域,大规模结构化语料库的构建对于自然语言处理模型的训练至关重要。leminda-ai/s2orc_small数据集源自Allen AI发布的S2ORC(语义学者开放研究语料库)全集,经过精心筛选与精简,形成了一个包含约89万篇英文论文的子集。该数据集保留了原始语料中具有摘要的论文条目,通过提取论文的唯一标识符、标题、摘要、实体列表、引用关系、作者信息、研究领域、发表年份、会议或期刊名称、DOI、PubMed ID以及Microsoft Academic Graph ID等多元结构化字段,构建出适用于信息检索、文本摘要、引文分析等任务的标准化数据资源。其构建过程强调数据的可复现性与学术研究的严谨性,为下游应用提供了高质量的初始语料。
特点
该数据集最显著的特征在于其涵盖学术论文全貌的丰富元数据。每篇论文均包含标题与摘要文本,支持语义层面的深度理解;实体字段以序列形式存储,便于提取关键概念与术语;引用关系(inCitations与outCitations)的完整保留使得学术网络分析成为可能。此外,作者信息、研究领域、发表年份、会议/期刊名称及多种标识符(DOI、PubMed ID、MAG ID)的并存,赋予了数据跨库链接与多维度筛选的能力。数据规模控制在约90万篇,既保留了大规模语料的统计意义,又避免了全量数据带来的存储与计算负担,尤其适合中等规模模型的预训练与微调。
使用方法
作为Hugging Face Datasets库支持的标准格式,该数据集可通过加载函数直接获取训练集。用户能够利用其结构化特性,针对特定任务进行字段筛选与组合:例如,将标题与摘要拼接用于生成式摘要模型的训练,或利用引用关系构建图神经网络所需的边信息。研究领域字段可用于领域自适应学习,作者信息则支持协作网络分析。由于数据以Parquet格式高效压缩存储,加载后可直接转换为Pandas DataFrame或PyTorch/TensorFlow的张量格式,便于集成到现有深度学习流水线中。建议在研究初期使用该子集进行原型验证,再迁移至全量S2ORC数据集进行大规模实验。
背景与挑战
背景概述
在自然语言处理与科学文献挖掘领域,大规模结构化论文语料库的匮乏长期制约着学术知识图谱构建、引文分析及跨学科研究的发展。leminda-ai/s2orc_small数据集由Leminda AI团队于近年创建,作为原始S2ORC(Semantic Scholar Open Research Corpus)的轻量级子集,精选了约89万篇包含摘要的英文论文。该数据集的核心研究问题聚焦于为学术文本理解提供高质量、多模态的标注样本,涵盖论文元数据、引用关系、研究领域标签及实体序列等关键信息。作为S2ORC生态的重要补充,其精简规模降低了计算资源门槛,使中小型研究机构也能便捷开展科学文献挖掘实验,推动信息检索、自动摘要生成与学术影响力预测等方向的进展。
当前挑战
该数据集当前面临的挑战主要体现在两方面。在领域问题层面,尽管其覆盖了多学科论文,但仅包含英文文献且缺乏对非英语学术资源的整合,限制了跨语言知识迁移研究的深度;同时,摘要文本的语义稀疏性与引文网络的不完整性,使得论文主题聚类与新兴趋势探测任务易受噪声干扰。在构建过程中,从原始S2ORC的1700万篇论文中筛选出含摘要的子集时,需处理PDF解析误差、元数据字段缺失(如部分条目缺失DOI或期刊卷号)以及作者消歧难题,这些质量控制环节的复杂性直接影响了数据集的标注一致性与覆盖均衡性。
常用场景
经典使用场景
在自然语言处理与科学计量学交叉领域中,leminda-ai/s2orc_small数据集以其精炼而丰富的学术文献信息,成为构建和评估科学论文理解模型的理想基石。该数据集汇聚了约90万篇英文论文的元数据,涵盖标题、摘要、作者、引用关系及研究领域等多维信息,尤其适用于学术文本分类、摘要生成、引文网络分析等经典任务。研究者可借助其结构化的特征,如研究领域标签(fieldsOfStudy)和引用关系(inCitations/outCitations),训练能够自动识别学科归属、预测论文影响力或挖掘科研合作模式的深度学习模型。这一数据集降低了大规模学术语料获取的门槛,为科学文献挖掘的基准实验提供了标准化平台。
衍生相关工作
该数据集衍生了一系列具有深远影响的经典工作。在预训练语言模型领域,基于s2orc_small训练的Specter模型开创性地利用论文标题和摘要的对比学习,生成了能够捕捉学术文本相似性的嵌入表示,成为后续SciBERT、Longformer等科学领域模型的训练基石。在引文预测方面,研究者利用其引用网络数据开发了GraphSage的学术变体,实现了对论文未来被引次数的精准预测。此外,该数据集还催生了科学实体识别与关系抽取的基准测试任务,如SciERC,推动了学术文献结构化信息抽取技术的突破。这些工作共同验证了s2orc_small作为学术NLP研究“标准试验田”的学术价值。
数据集最近研究
最新研究方向
在学术文献挖掘与自然语言处理领域,s2orc_small数据集作为大规模学术图谱s2orc的精简版本,聚焦于约90万篇含摘要的英文论文,正成为推动前沿研究的重要基石。当前研究方向集中于利用其丰富的元数据(如引用关系、学科领域、作者信息)进行科学知识图谱构建与语义理解,尤其在引文预测、学术影响力评估和跨学科趋势分析中展现关键价值。该数据集与开放科学运动及可重复性研究热潮紧密相连,为训练大规模语言模型(如SciBERT)和探索科学文献中的实体关系抽取提供了高质量基准,其影响力延伸至科研政策制定与学术推荐系统优化,显著加速了文献计量学与人工智能的交叉创新。
以上内容由遇见数据集搜集并总结生成


