finassure-audit-telemetry
收藏资源简介:
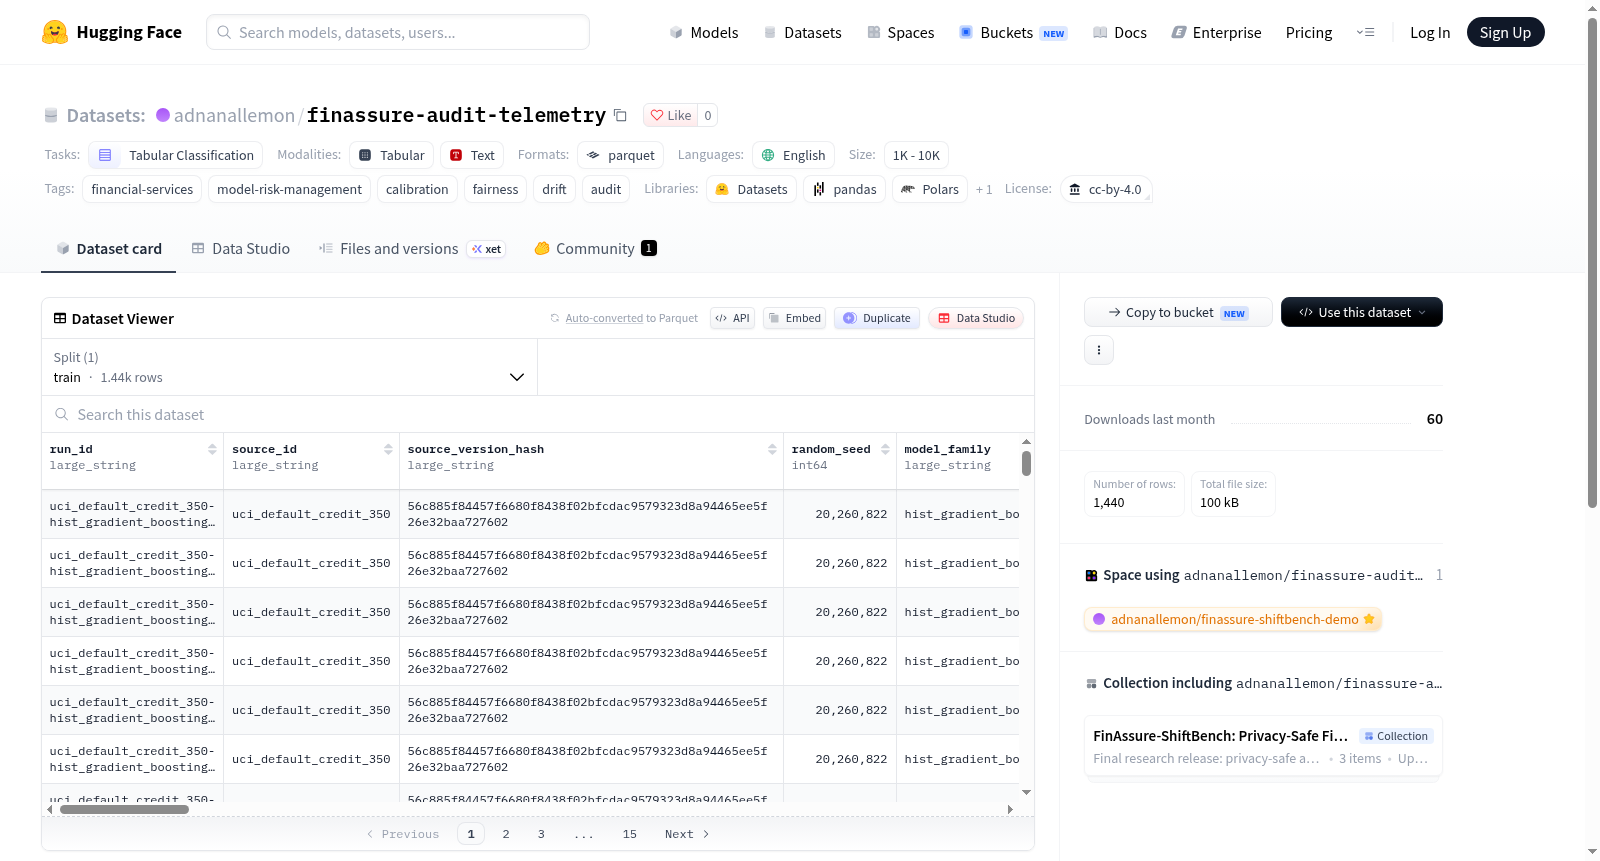
FinAssure–ShiftBench 是一个原创的聚合级别基准测试数据集,旨在研究在声明分布漂移场景下,审计遥测是否能够估计预先注册的基准保证策略违规的概率。该数据集包含 1,440 条审计运行记录,这些记录源自公共 UCI 信用数据源,并以可重复的方式生成。数据集不包含任何客户记录、账户ID、交易、源特征、原始标签、评分向量或预测向量。该基准测试的 v1.1 版本(ESWA 实验扩展)通过分组 Brier 评分选择正则化逻辑 FFI 模型,模型是策略和场景条件化的。消融和跨源检查被报告为局限性,而非可移植性声明。基准标签是受控保留重采样环境中的透明协议结果,不代表真实世界事件、监管发现、个人信用决策或部署批准。
FinAssure-ShiftBench is an original aggregated-level benchmark dataset designed to study whether audit telemetry can estimate the probability of pre-registered benchmark guarantee policy violations under declared distribution drift scenarios. The dataset contains 1,440 audit run records derived from the public UCI credit data source and generated in a reproducible manner. The dataset does not include any customer records, account IDs, transactions, source features, original labels, scoring vectors, or prediction vectors. The v1.1 version of this benchmark (ESWA experimental extension) selects regularized logistic FFI models via grouped Brier score, with models conditioned on policies and scenarios. Ablation and cross-source checks are reported as limitations, not as portability claims. Benchmark labels are transparent protocol results in a controlled hold-out resampling environment, not representing real-world events, regulatory findings, personal credit decisions, or deployment approvals.
FinAssure–ShiftBench 审计遥测数据集
数据集概述
FinAssure–ShiftBench 是一个仅含聚合数据的原始基准数据集,用于研究审计遥测能否在已声明的分布漂移场景中,估计预先登记的基准保证策略违规的概率。该数据集包含 1,440 条审计运行记录,可复现地来源于公开的 UCI 信用数据源,且不包含任何客户记录、账户 ID、交易、源特征、原始标签、评分向量或预测向量。
数据集属性
- 语言:英语
- 许可证:CC-BY-4.0
- 任务类别:表格分类
- 标签:金融服务、模型风险管理、校准、公平性、漂移、审计
- 数据规模:1K < n < 10K
实验扩展
v1.1 ESWA 实验扩展通过分组 Brier 评分选择,采用正则化逻辑回归 FFI。该模型受政策和场景条件约束;消融实验与跨源检查被报告为局限性说明,而非可移植性声明。
重要说明
基准标签是在受控留出重采样环境中的透明协议结果,并非真实世界事件、监管发现、个体信用决策或部署批准。
相关资源
- 完整数据集卡片:https://github.com/adnanomar77/finassure-shiftbench/blob/main/cards/DATASET_CARD.md
- 数据集协议:https://github.com/adnanomar77/finassure-shiftbench/blob/main/research/DATASET_PROTOCOL.md
- ESWA 匿名手稿:https://github.com/adnanomar77/finassure-shiftbench/blob/main/paper/FINASSURE_ESWA_ANON_MANUSCRIPT.md
- 在线演示 Space:https://huggingface.co/spaces/adnanallemon/finassure-shiftbench-demo