
jet-ai/RULER-500
收藏官方服务:
资源简介:
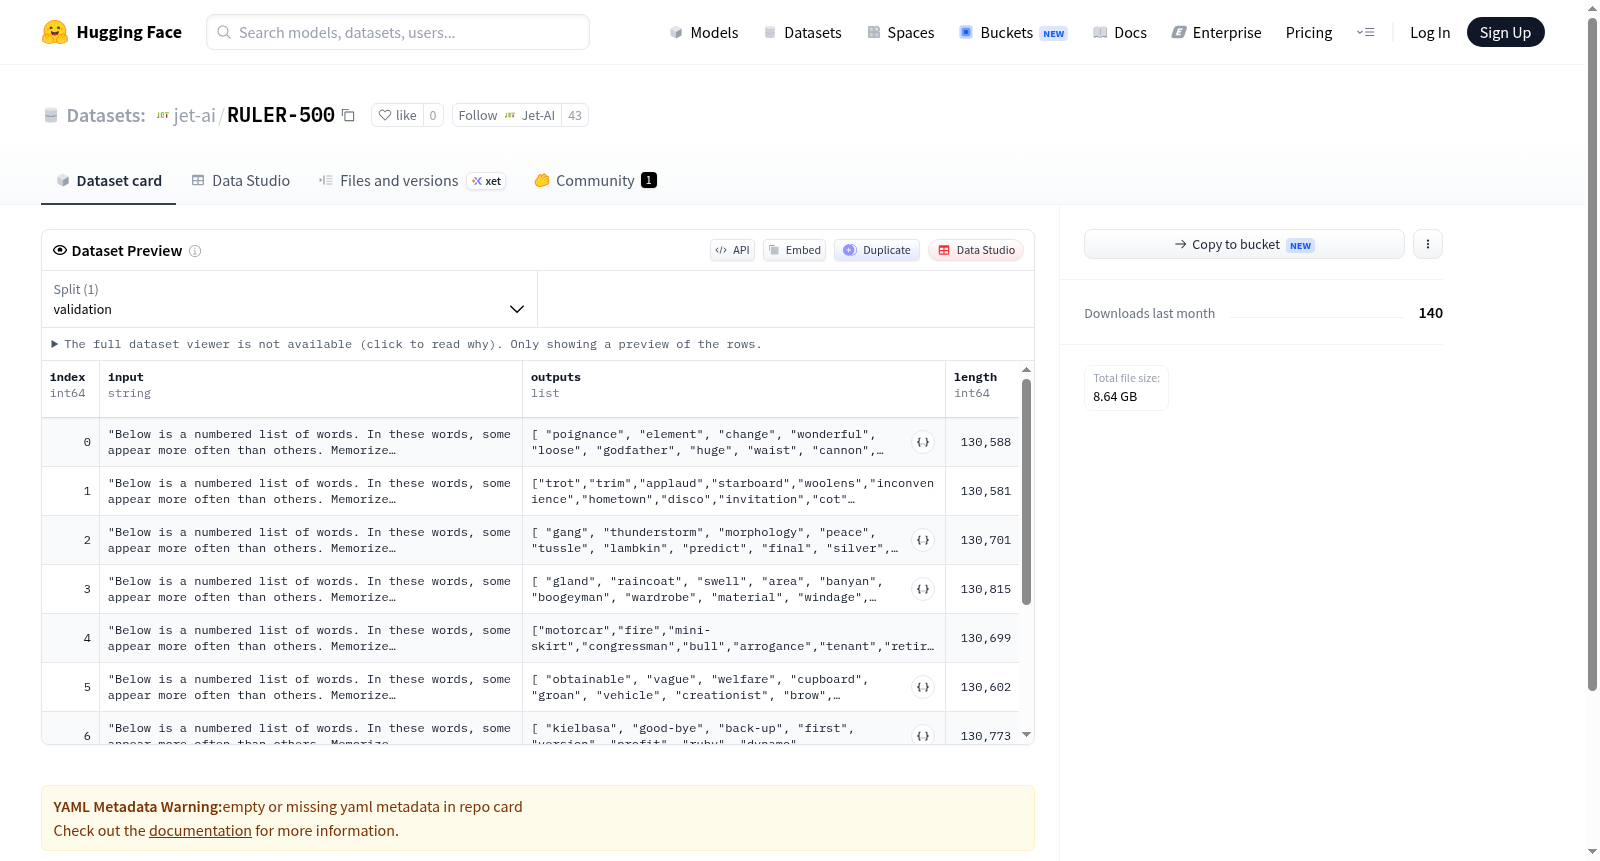
该数据集是从RULER(https://github.com/NVIDIA/RULER.git)生成的,用于长上下文评估。
Dataset generated from RULER (https://github.com/NVIDIA/RULER.git) for long context evaluation.
提供机构:
jet-ai搜集汇总
数据集介绍
构建方式
RULER-500数据集源自NVIDIA发布的RULER项目,专为评估大语言模型长上下文理解能力而设计。该数据集通过系统化生成方式构建,采用Qwen3分词器对原始文本进行处理,确保生成的样本与目标模型兼容。其核心构建逻辑在于模拟长序列场景下的信息检索与推理任务,通过控制序列长度、关键信息位置及干扰项密度等参数,生成包含500个样本的测试集,为模型的长文本处理能力提供标准化评估基准。
特点
该数据集的核心特色在于其精准聚焦长上下文场景的评估需求,所有样本均经过Qwen3分词器的适配处理,确保与最新语言模型体系的兼容性。每个样本包含丰富的干扰信息与目标查询,可有效检测模型在超长序列中的信息定位与逻辑推理能力。数据集规模精简至500例,既保证评估效率,又通过多样化的难度层级设计,为不同能力的模型提供差异性诊断。
使用方法
使用者可直接加载RULER-500数据集,通过将其拆分为查询-上下文对的形式输入待评估模型。推荐采用困惑度、精确匹配或F1分数等指标计算模型输出与标准答案的一致性。评估时应关注模型在不同有效信息位置和干扰密度下的表现差异,从而系统性分析其长上下文理解瓶颈。该数据集无需额外预处理,可直接用于模型对比测试与能力诊断。
背景与挑战
背景概述
RULER-500数据集诞生于长上下文语言模型评估的前沿需求,由NVIDIA研究团队基于其开源的RULER框架生成,旨在系统性地衡量模型对超长序列的处理能力。随着Transformer架构的演进,模型上下文窗口已扩展至数千乃至数万token,但现有基准如LAMBADA或SQuAD多聚焦于短文本,难以揭示模型在长距离依赖建模中的真实表现。该数据集采用Qwen3分词器重新编码,确保与新一代语言模型的无缝适配。其核心研究问题在于探索模型在复杂推理、信息检索和上下文关联中能否有效利用长达500个token的序列上下文,从而为长上下文NLP任务提供可复现的标准化评估工具,对提升文档级问答、多轮对话和长文本生成等应用的鲁棒性具有重要推动作用。
当前挑战
该数据集主要应对两方面的挑战。一是领域问题层面,长上下文场景中模型常面临‘注意力分散’或‘中间信息遗忘’现象,现有指标难以精确捕捉模型在关键信息定位与逻辑连贯性上的缺陷,RULER-500需设计精细化的任务模板来暴露这些瓶颈。二是构建过程中,生成足够多样化且覆盖多种推理策略的样本面临难度,包括确保不同样本间上下文长度与复杂度的一致性,同时避免分词器编码差异引入的偏差。此外,对500 token这一阈值的选择需兼顾测试敏感性与计算成本,过度增加长度可能降低实际测试效率,过短则无法有效区分模型能力,这要求数据生成流程在语料库选择、任务难度平衡和验证标准上达到严格把控。
常用场景
经典使用场景
在自然语言处理领域,长文本理解与生成能力始终是衡量大语言模型性能的关键维度。RULER-500数据集正是为评估模型在超长上下文场景下的表现而精心构建的基准测试集,其经典使用场景聚焦于对模型在长达500个token级别的上下文窗口中进行信息检索、推理与记忆能力的系统性检验。研究者常借助该数据集,通过设计精细化的任务模板,探究模型能否从冗长文本中准确提取关键实体、遵循复杂指令或完成跨段落逻辑推理,从而为优化模型的注意力机制与上下文建模提供量化依据。
实际应用
在实际应用中,RULER-500数据集为部署长文档智能处理系统提供了关键的测试验证工具。例如,在金融领域,模型需要从数百页的年度报告中提取财务指标并进行趋势分析;在法律场景中,模型必须在一整份案卷材料中定位关键条款并完成逻辑推演。利用该数据集,开发者可以评估模型在真实长文本业务中的稳健性,从而针对性地调整模型规模、上下文窗口大小或推理策略,确保落地系统的可靠性与效率。其应用范围已扩展至科研文献综述的自动生成、医疗病历的连贯理解以及长篇代码仓库的辅助编程等前沿领域。
衍生相关工作
RULER-500的诞生催生了一系列关于长上下文评估方法与模型改进的经典研究。基于该数据集,研究者提出了诸如分段式注意力增强、递归上下文压缩以及基于检索的稀疏记忆机制等多种优化策略,并在相关论文中将其作为基准进行评估。同时,它也启发了一批衍生工作,例如LongBench系列与Scrolls等数据集在任务设计上借鉴其分层挑战理念,进一步拓展了评估维度。此外,针对该数据集中暴露的模型在位置编码与tokenizer兼容性上的缺陷,催生了如YaRN位置插值与ALiBi等高效长序列建模方案的提出与验证,形成了从问题发现到技术创新的良性循环。
以上内容由遇见数据集搜集并总结生成


