urdu-ocr-1M
收藏资源简介:
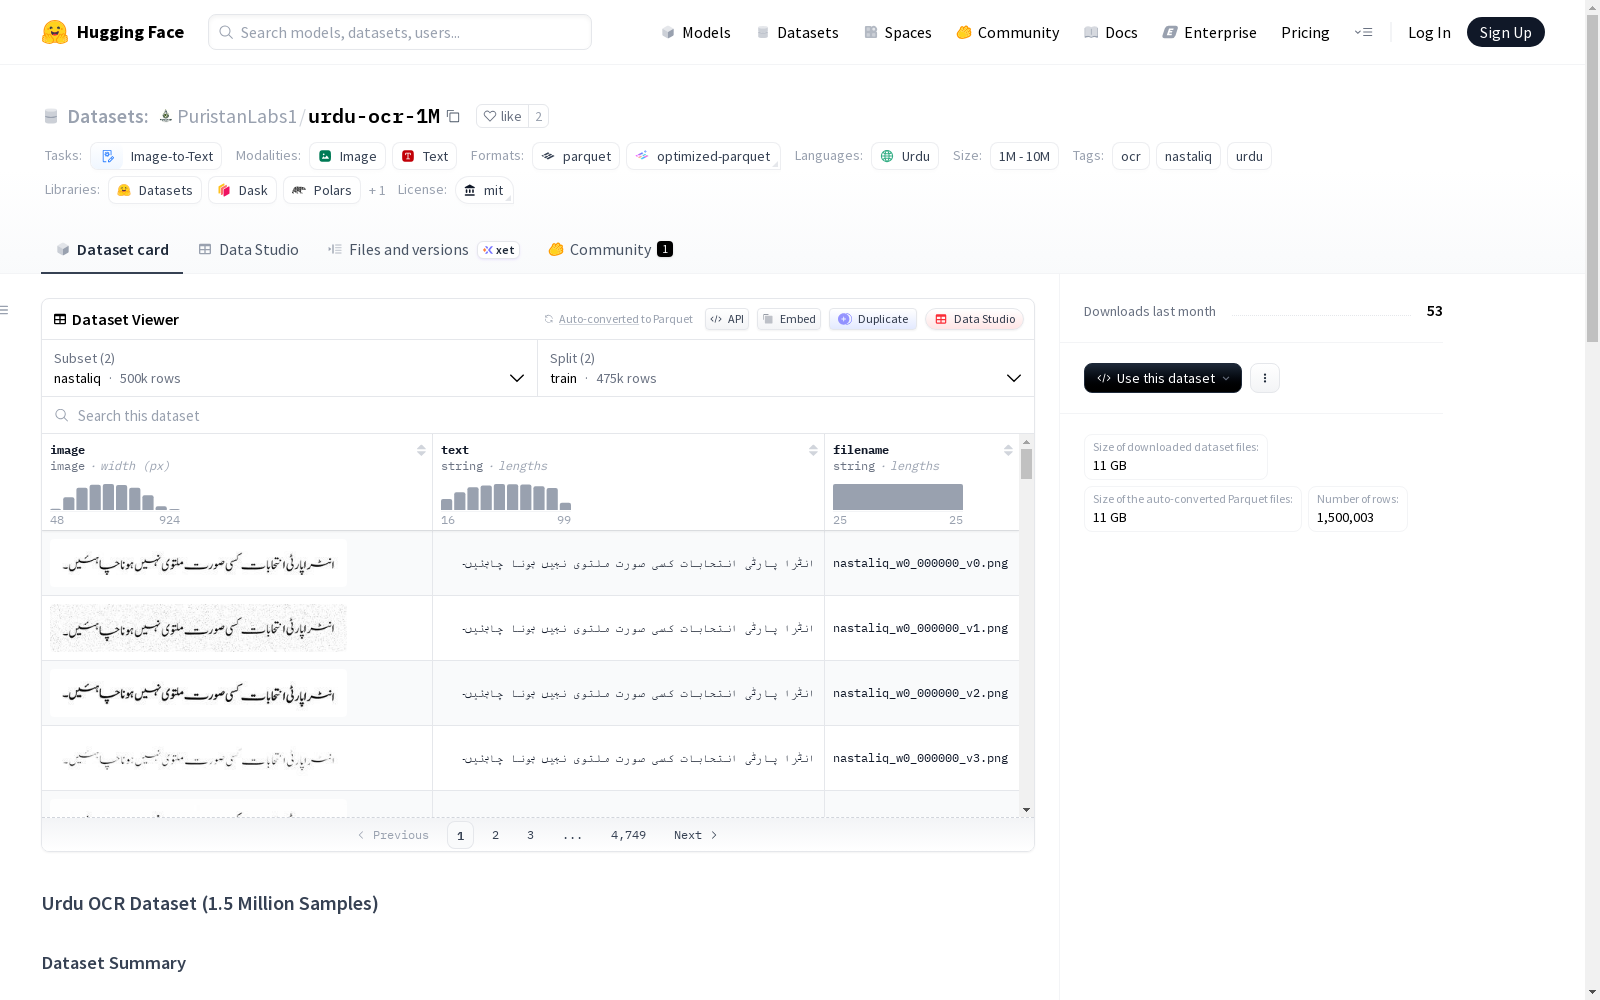
这是一个用于乌尔都语光学字符识别(OCR)的大规模合成数据集,包含突破性的Nastaliq集合和稳健的Naskh基础。数据集总共有150万个样本,其中Nastaliq部分包含约50万个样本,使用真实的Jameel Noori Nastaliq连字通过自定义的基于Chromium的渲染管道生成;Naskh部分包含1,000,160个样本,采用标准的乌尔都语字体用于基线OCR任务。数据集以优化的分片Parquet格式提供,支持高效流式处理。数据模式包括'image'(渲染的乌尔都语文本图像,高度标准化为64像素)、'text'(真实乌尔都语字符串)、'filename'(源文件和变体类型的引用)和'style'('nastaliq'或'naskh')。Nastaliq部分通过高保真渲染、手动质量控制和1:5的增强技术,模拟真实世界扫描文档的复杂性。数据集适用于图像到文本的任务,特别适用于乌尔都语OCR研究。
This is a large-scale synthetic dataset for Urdu optical character recognition (OCR), featuring a groundbreaking Nastaliq subset and a robust Naskh base. The dataset contains a total of 1.5 million samples: the Nastaliq subset has approximately 500,000 samples, generated using authentic Jameel Noori Nastaliq ligatures via a custom Chromium-based rendering pipeline; the Naskh subset includes 1,000,160 samples, using standard Urdu fonts for baseline OCR tasks. The dataset is provided in optimized sharded Parquet format to support efficient streaming. Its data schema includes 'image' (rendered Urdu text images standardized to a height of 64 pixels), 'text' (ground truth Urdu strings), 'filename' (reference to source files and variant types), and 'style' (either 'nastaliq' or 'naskh'). The Nastaliq subset simulates the complexity of real-world scanned documents through high-fidelity rendering, manual quality control, and a 1:5 augmentation ratio. This dataset is applicable to image-to-text tasks, and is particularly suitable for Urdu OCR research.
Urdu OCR Dataset (1.5 Million Samples) 数据集概述
数据集摘要
这是一个用于乌尔都语光学字符识别(OCR)的大规模合成数据集,包含开创性的Nastaliq字体集合和稳健的Naskh字体基础。
- Nastaliq(主要):包含499,845个样本,使用自定义的基于Chromium的渲染流程,以真实的Jameel Noori Nastaliq连字渲染。
- Naskh:包含1,000,160个样本,使用标准乌尔都语字体,用于基线OCR任务。 总计150万个样本,该数据集以优化的分片Parquet格式提供,以实现高效流式传输。
数据集结构
| 样式 | 样本数量 | 描述 |
|---|---|---|
| Nastaliq | 约500,000 | 真实的级联连字 + 强力的扫描增强。 |
| Naskh | 1,000,160 | 标准水平渲染。 |
数据模式
image:渲染的乌尔都语文本图像(高度标准化为64像素)。text:真实的乌尔都语字符串。filename:源文件和变体类型的引用。style:"nastaliq" 或 "naskh"。
配置
- 配置名称:
nastaliq(默认)- 数据文件:
- 训练集分割:
nastaliq/train-*.parquet - 验证集分割:
nastaliq/val-*.parquet
- 训练集分割:
- 数据文件:
- 配置名称:
naskh- 数据文件:
- 训练集分割:
data/train-*.parquet - 验证集分割:
data/val-*-of-00001.parquet
- 训练集分割:
- 数据文件:
数据集特点
- 任务类别:图像到文本
- 语言:乌尔都语(ur)
- 标签:ocr, nastaliq, urdu
- 规模类别:1M-10M
- 许可证:mit
Nastaliq数据生成方法(第二阶段)
为捕捉Nastaliq字体的复杂性,采用了超越标准图像渲染的方法:
- 高保真渲染:使用无头Chromium引擎(通过Playwright)渲染文本,实现100%真实的Jameel Noori Nastaliq字距和垂直堆叠。
- 人工质量控制:由母语者手动审查试点批次,识别并移除"乱码"或裁剪不当的样本。从最终的50万数据集中清除了31种特定的低质量模式。
- 强力的1:5增强:每条约10万条独特文本行用于生成4种独特的"破坏"变体,专门用于模拟现实世界中的扫描文档:
- V1: 灰尘扫描:灰度颗粒 + 胡椒噪声。
- V2: 细/压缩:形态学侵蚀 + JPEG压缩。
- V3: 浓墨:形态学膨胀(墨水渗色) + 高斯软化。
- V4: 雪地:粗颗粒 + 盐噪声(白点)。
使用示例
python from datasets import load_dataset
加载新的Nastaliq配置
dataset = load_dataset("PuristanLabs1/urdu-ocr-1M", "nastaliq", streaming=True) sample = next(iter(dataset["train"])) sample["image"].show()
致谢
由Puristan Labs制作。专业的Nastaliq流程使用基于Chromium的渲染和保留字符的形态学增强技术开发。