
遇见数据集

gemma-challenge/eval-prompts

收藏
Hugging Face2026-06-03 更新2026-06-14 收录
官方服务:

资源简介:

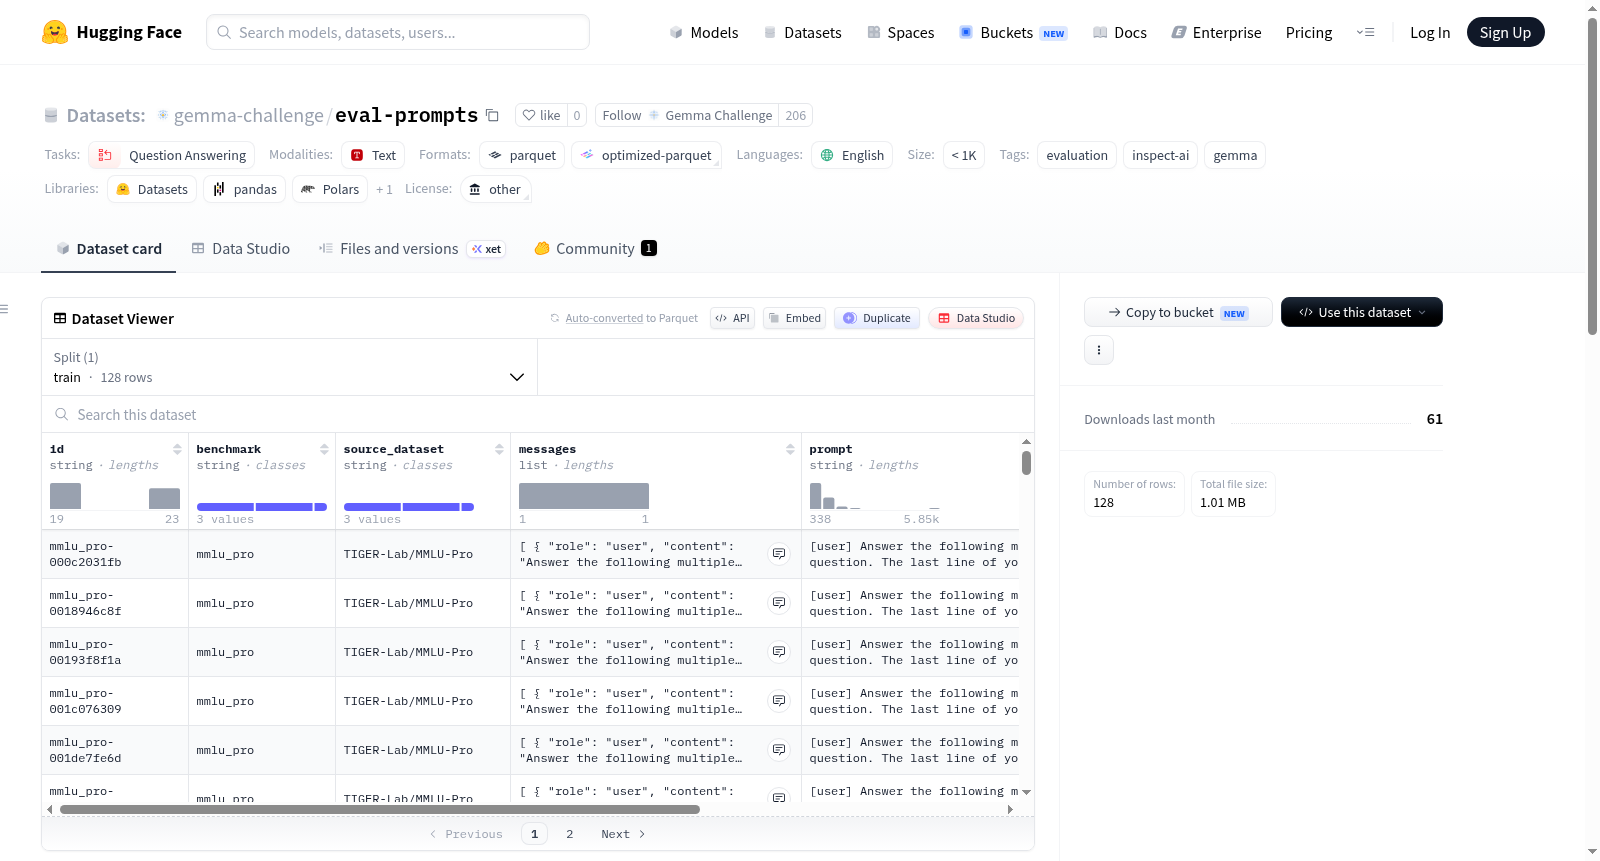
该数据集名为gemma-challenge/eval-prompts,是一个包含128个提示的集合,用于评估目的,特别是针对Gemma模型。这些提示从三个基准测试中采样:MMLU-Pro(来自TIGER-Lab/MMLU-Pro数据集的测试部分,57个提示)、GPQA Diamond(来自OpenAI simple-evals的gpqa_diamond.csv,57个提示)和AIME 2026(来自math-ai/aime26数据集,14个提示)。每个提示都是通过Inspect AI的inspect_evals工具在评估过程中捕获的,直接模拟发送给模型的消息格式,包括模板、答案选择格式和指令,没有手动编写。数据集提供了详细的列信息,如id、benchmark、source_dataset、messages、prompt、target和metadata,便于分析和使用。

A 128-prompt mix sampled from three benchmarks supported by Inspect AI / inspect_evals. Each prompt is rendered exactly as inspect_evals sends it to the model during evaluation — captured by running each task through Inspects mockllm/model and extracting the literal input messages (templates, answer-choice formatting, and instructions included). No prompt text was hand-written. The benchmarks include MMLU-Pro (57 prompts from TIGER-Lab/MMLU-Pro test set), GPQA Diamond (57 prompts from OpenAI simple-evals gpqa_diamond.csv), and AIME 2026 (14 prompts from math-ai/aime26 dataset). The dataset is designed for evaluation purposes, particularly for the Gemma model, and includes columns such as id, benchmark, source_dataset, messages, prompt, target, and metadata.
提供机构:
gemma-challenge
搜集汇总
数据集介绍
gemma-challenge/eval-prompts 数据集图片
构建方式
该数据集源自对三大主流基准测试的深度整合,其构建过程严格遵循Inspect AI评估框架的原始执行逻辑。通过调用`inspect_evals`的完整评估管线,并利用`mockllm/model`截取模型实际接收到的输入消息,最终捕获了包含模板、选项格式化及指令在内的精确提示文本。所有128条提示均源自MMLU-Pro、GPQA Diamond与AIME 2026三个基准测试,分别抽取57、57与14条样本,形成均衡且具有代表性的评测集合。每条提示均以模型接收时的原始形态保存,未经过任何人工润色或改写。
特点
该数据集的核心特质在于其高度的保真性与可复现性。所有提示均以Inspect AI框架发送给模型的原始格式呈现,完整保留了多选、链式思维及数学推理等不同任务模板的细微差异。数据集提供统一的列结构,包含基准来源、原始提示文本、用户消息序列、标准答案及元数据JSON,便于研究者追溯每个样本的生成上下文。此外,每个提示的字数与令牌数统计信息均已标注,为计算开销评估提供了便捷参考。
使用方法
研究者可直接将本数据集作为Inspect AI评估管线的输入使用,利用其中保存的`messages`字段模拟模型推理过程,或通过`prompt`字段进行提示工程的对比分析。数据集支持按`benchmark`列筛选特定领域的评测样本,便于进行消融实验。同时,`target`字段提供了标准答案,可用于自动化评估脚本的编写。建议结合`inspect_evals`官方工具进行端到端的复现验证,确保评测结果的可比性与一致性。
背景与挑战
背景概述
该数据集由gemma-challenge团队于近期创建,专注于提升大语言模型在复杂推理任务中的评估透明度。其核心研究问题在于揭示标准化评估流程中提示模板对模型性能的影响,通过采样Inspect AI框架支持的MMLU-Pro、GPQA Diamond和AIME 2026三个基准测试中的128个提示,完整保留了评估系统发送给模型的原生输入格式。数据集的独特价值在于所有提示均通过模拟评估流程自动捕获,避免了人工编写可能引入的偏差,为研究提示结构对模型输出的影响提供了精确的基准材料。
当前挑战
当前面临的核心挑战包括:领域层面,大语言模型在多项选择推理与数学问题求解任务中的表现高度依赖提示模板的措辞与格式,但现有评估体系缺乏对提示标准化构建的严格约束,导致模型性能比较难以归因;构建过程中,需确保提示数据从不同来源基准测试中无损迁移,同时处理各基准测试间模板差异(如选项数量、思维链指令等),且需使用与模型实际推理一致的分词代理进行统计,以最小化表征偏差对评估结果的影响。
常用场景
经典使用场景
eval-prompts数据集由128条精心筛选的提示(prompt)构成,分别源自MMLU-Pro、GPQA Diamond和AIME 2026三个权威基准测试,每条提示均通过Inspect AI框架的mockllm/model捕获,完全复现了模型评估时的真实输入格式。该数据集最经典的使用场景在于为大型语言模型(LLM)提供标准化、可复现的评估提示集合,尤其适合用于衡量模型在多项选择推理、数学解题和复杂逻辑问答等任务上的表现。研究者可直接利用这些提示对模型进行零样本或少样本评测,从而避免因提示模板差异导致的评估偏差,确保不同模型间性能对比的公平性和一致性。
解决学术问题
该数据集直击大模型评估领域长期存在的“提示工程”复现难题——过去许多研究依赖非公开或手工编写的提示,导致实验结果难以被第三方验证。eval-prompts通过公开已格式化的精确提示文本,解决了学术研究中因提示格式不统一造成的性能波动问题,使得模型推理能力、事实性知识检索和数学求解等维度的评估更具科学性和可重复性。这一标准化评估资源显著推动了开放科学精神,为后续研究提供了可靠的基线参考,有助于更客观地揭示不同模型架构与训练策略之间的真实能力差距。
衍生相关工作
eval-prompts的发布催生了一系列围绕大模型标准化评测的衍生工作。一方面,研究者将其作为测试集,系统比较不同提示模板(如思维链、少样本示例)对模型输出质量的影响,从而优化推理策略;另一方面,该数据集激励了更多针对特定领域(如医学、法学)的评测提示集的构建工作,例如借鉴其精心设计的格式,开发出面向专业考试的领域专属评估工具。此外,基于该数据集衍生出的微调任务也受到关注——研究者通过分析模型在这些提示上的失败案例,定向生成训练数据,提升模型在薄弱环节的鲁棒性,形成“评测-诊断-优化”的闭环研究范式。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

