
遇见数据集

Ipseome; JJJ Pro Who am I?

收藏
arXiv2026-07-03 更新2026-07-05 收录
官方服务:

资源简介:

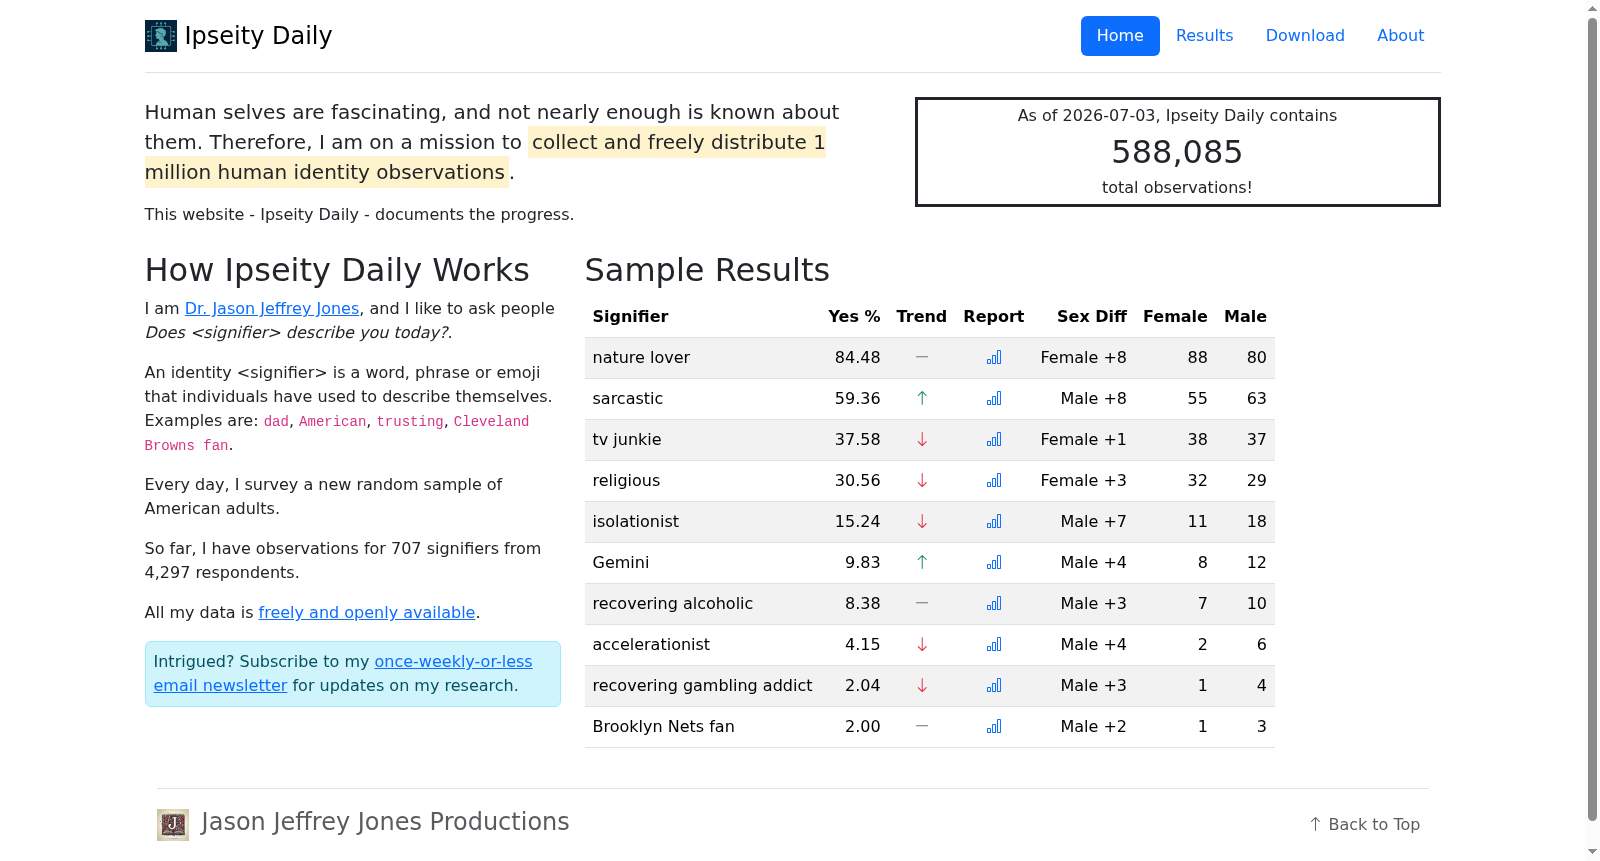
Ipseome是由石溪大学Jason Jeffrey Jones团队构建的大规模人类身份数据集,旨在通过语言数据全面记录和量化个体自我表达的身份特征。该数据集包含来自社交媒体档案、日常调查和代表性抽样调查的自我描述文本,数据量庞大且覆盖广泛的时间跨度和地理范围,其中JJJ Pro Who am I?子集采用了类似二十项陈述测试的方法,收集了美国成年人的开放式自我描述文本。数据集的创建过程遵循ipseological原则,强调以语言为基础、自我描述为核心、时间维度为重心,并通过持续、系统的采集方式构建可重复使用的研究基础设施。该数据集主要应用于计算社会科学和身份研究领域,旨在解决人类身份动态变化、社会网络中的身份聚类以及跨文化自我表达模式等核心问题,为身份理论的实证检验提供数据支持。

Ipseome is a large-scale human identity dataset constructed by the team led by Jason Jeffrey Jones from Stony Brook University, aiming to comprehensively document and quantify the identity traits underlying individuals' self-expression through linguistic data. This dataset contains self-descriptive texts sourced from social media profiles, daily surveys and representative sampling surveys, boasting a massive volume and covering a wide range of temporal spans and geographic scopes. Specifically, its subset JJJ Pro Who am I? adopts a method similar to the Twenty Statements Test (TST) to collect open-ended self-descriptive texts from U.S. adults. The construction of this dataset follows ipsological principles, which prioritize linguistic foundations, self-description as the core, and temporal dimension as the focal point, and builds a reusable research infrastructure through continuous and systematic data collection. Primarily applied in the fields of computational social science and identity research, this dataset addresses core issues including the dynamic changes of human identity, identity clustering in social networks and cross-cultural self-expression patterns, providing data support for empirical tests of identity theories.
创建时间:
2026-07-03
搜集汇总
数据集介绍
Ipseome; JJJ Pro Who am I? 数据集图片
构建方式
JJJ Pro Who am I? 数据集是在自我学(Ipseology)框架下构建的一项多波次调查,旨在系统性地搜集个体的自我叙述文本。其构建过程借鉴了经典的二十语句测验(Twenty Statements Test),通过Prolific平台招募具有代表性的美国成年人样本。在每个波次中,一半受访者从上一波次中重新招募,以实现个体层面的纵向追踪;另一半则招募全新的代表性样本,以支持群体层面的横截面分析。受访者在充分知情并同意数据公开共享后,在线上完成一个开放式问题,即使用自然语言描述“我是谁”。最终收集的原始文本除移除极少数含姓名信息的内容外,未经任何修改或排除,以保留最真实、多样化的自我表达。
特点
该数据集的核心特点在于其兼具代表性、开放性与可重复使用性。作为首个免费开放、基于代表性样本的全文自我描述数据集,它提供了受访者自主撰写的完整自我叙述文本,而非预设标签或选项。这种开放式词汇的数据形态使得研究者能够自由探索身份表征的多样性、层次结构与浮现模式。每个观测记录均附带有匿名的受访者ID、观察日期及基本人口统计学信息,从而支持纵向与横截面的多维度分析。此外,数据集明确采用知识共享署名-非商业性使用-相同方式共享许可协议发布,确保了数据在学术研究中的广泛可及性与累积性复用。
使用方法
研究者在获取数据后,可直接利用单行每观测的CSV格式文件进行各种计算社会科学分析。例如,可运用开放词汇方法(open-vocabulary approach)提取与统计文本中出现的所有身份标记词,并计算其频率与共现模式。结合时间戳信息,可以追踪个体或群体层面自我概念在年度间的变化趋势。通过受访者ID的关联,研究者还能开展个性的纵向发展轨迹分析。同时,由于数据集中包含了完整的人口统计学变量,研究者可以考察不同年龄、性别、族裔群体在自我描述语言上的差异,从而深入理解身份建构的社会文化动因。
背景与挑战
背景概述
在人文学科与计算社会科学的交汇处,对人类身份认同的量化研究长期受制于数据匮乏与样本局限。为填补这一空白,Jason Jeffrey Jones 于 2026 年正式提出并构建了 Ipseome 数据集,该工作由纽约州立大学石溪分校的计算社会学实验室主导,核心目标是以大规模、开放、持续的方式系统记录人类自我描述文本。Ipseome 的命名源于拉丁语 'ipse'(自我),意在仿效基因组学、蛋白质组学等 '组学' 范式,对人类自我认同要素进行穷尽式编目。该数据集整合了 Ipseity Daily 的日常调查、JJJ Pro Who am I? 的全文本自我描述、以及来自 Twitter 的 HINENI 十年跨文化数据,为身份研究提供了前所未有的时域宽度与样本多样性。自发布以来,Ipseome 已成为身份认同研究领域的基础性公共资源,推动了从政治极化到性取向可表达性等多项前沿议题的实证探索。
当前挑战
Ipseome 所应对的核心挑战在于,身份认同因其动态性、隐蔽性与文化依赖性而难以被规模化度量。传统研究方法多依赖小样本自陈量表与横截面调查,无法捕捉身份在时间纵轴上的演化规律与跨文化差异。为此,数据集构建过程中面临多重技术难题:首先,如何确保每日采集的自我描述数据在语义丰富性与结构一致性之间取得平衡,Jones 设计了 Ipseity Daily 中随机抽取身份能指并重复测量的方案以应对。其次,来自社交媒体的文本存在拼写不规范、表情符号混用和机器人生成内容等噪声,研究团队对所有文本进行手工审阅以确保唯一性标识被匿名化,同时保留敏感内容以维护数据的完整性。此外,不同国家用户在自我表达方式上的显著差异要求数据集具备语言无关的语义对齐能力,这一挑战在 HINENI 的跨文化比较中得到专门处理。
常用场景
经典使用场景
在人类身份认同与自我概念研究的广袤领域中,Ipseome数据集的核心用途在于系统性地捕捉并量化个体如何通过语言来定义自我。其经典使用场景聚焦于分析“个人表达的身份文本”,即个体在自然或受控条件下撰写的第一人称自我描述。通过整合多个子数据集,研究者得以追踪身份标识符(如‘父亲’、‘自由派’或特定表情符号)在不同时空维度下的出现频率与演变趋势,从而揭示自我叙事中的语义结构与社会文化烙印。
衍生相关工作
围绕Ipseome数据生态已涌现出一系列创新性学术工作,这些工作进一步拓展了自我研究的边界。例如,基于Twitter生物概要的HINENI项目揭示了全球三十二个国家在十年间身份标识符的政治化趋势,验证了政治认同在全球范围内的同步升维。另外,利用Ipseity Daily的系列数据,研究者量化了不同身份标识符的存续周期,即哪些标志短暂流行、哪些成为持久烙印,为理解现代身份的不稳定本质提供了量化模型。
数据集最近研究
最新研究方向
Ipseome数据集作为人类身份研究的公共基础设施,正推动计算社会科学在自我认同领域的范式革新。当前前沿方向聚焦于利用其大规模、多维度、历时性特质,探究身份标识符的演化规律与跨文化差异。研究者通过分析Twitter传记与年度调查文本,揭示政治化自我概念在全球范围内的普遍蔓延趋势,并量化身份元素在社交网络中的聚类效应与时间存续性。此外,该数据集为验证身份理论提供了前所未有的实证基础,使得从“数据先行”的ipseology视角出发,能够精确定位人口层面身份变迁的驱动因子,为理解现代社会中个体性与集体认同的动态交织开辟了系统性研究路径。
相关研究论文
  • 1
    Building the Ipseome: Large, Free, Open, Human Identity Data石溪大学·社会学系; 石溪大学·高级计算科学研究所 · 2026年

以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

