
遇见数据集

faos1993/sun-background-selected-metadata

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

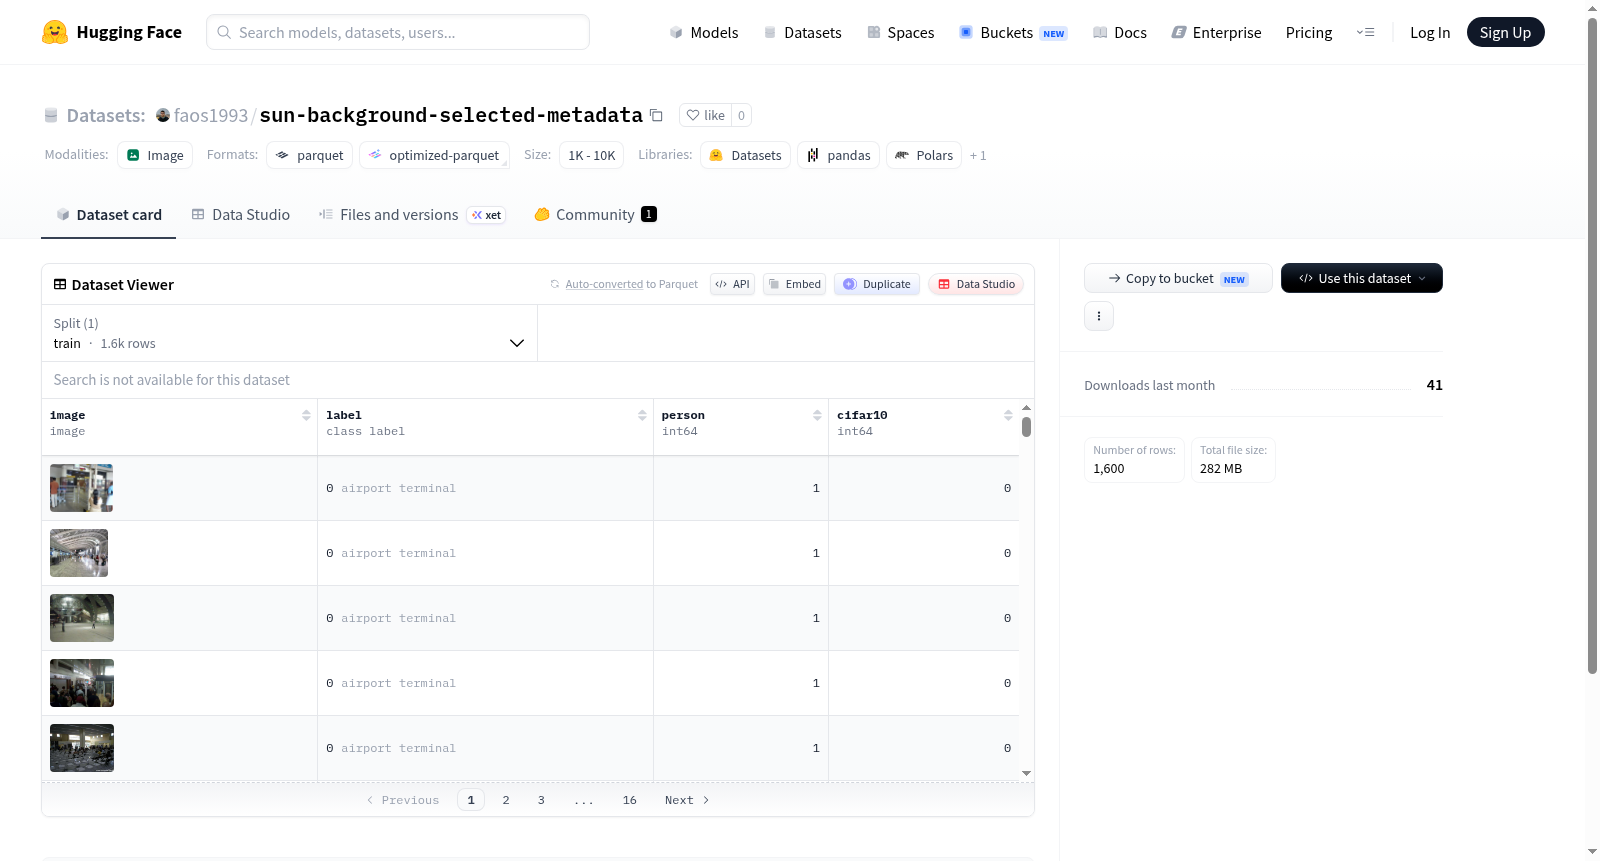
该数据集是一个图像分类数据集,包含1600张训练图像,每张图像标注为32个场景类别之一,如机场航站楼、卧室、植物园、城市运河、海岸、畜栏、小溪、码头、车道、野外、户外机库、港口、高速公路、工业区、厨房、客厅、沼泽、山脉、海洋、公园、户外停车库、停车场、牧场、池塘、雨林、跑道、天空、马厩、街道、沼泽、树农场和庭院。数据集还包含person字段(可能表示图像中人物数量)和cifar10字段(可能表示与CIFAR-10数据集的关联)。数据以图像文件格式存储,总大小约282MB。

This dataset is an image classification dataset containing 1600 training images, each labeled with one of 32 scene categories, such as airport terminal, bedroom, botanical garden, canal urban, coast, corral, creek, dock, driveway, field wild, hangar outdoor, harbor, highway, industrial area, kitchen, living room, marsh, mountain, ocean, park, parking garage outdoor, parking lot, pasture, pond, rainforest, runway, sky, stable, street, swamp, tree farm, and yard. The dataset also includes a person field (possibly indicating the number of people in the image) and a cifar10 field (possibly indicating a relation to the CIFAR-10 dataset). Data is stored in image file format with a total size of approximately 282MB.
提供机构:
faos1993
搜集汇总
数据集介绍
faos1993/sun-background-selected-metadata 数据集图片
构建方式
sun-background-selected-metadata数据集是基于大规模场景识别数据集SUN(Scene UNderstanding)的精选子集,通过引入精细化的元数据标注进行二次构建。原始SUN数据集包含广泛的场景类别,本数据集从中筛选出32类具有代表性的背景环境,如航站楼、卧室、雨林、海洋等,确保场景多样性。构建过程中,每张图片不仅保留了原有的场景标签,还额外标注了人物数量(person字段)以及CIFAR-10类别映射(cifar10字段),从而为多任务学习与跨数据集研究提供结构化元数据。数据集共包含1600个训练样本,以图像-标签-元数据三元组的形式存储。
使用方法
使用本数据集时,研究人员可通过HuggingFace Datasets库加载默认配置,直接获取训练集图像与对应标签。每个样本包含image(PIL图像对象)、label(32类场景索引)、person(整数型人物计数)和cifar10(整数型CIFAR-10类别编号)四个字段。典型用法包括:基于label进行场景分类任务;利用person字段训练人群密度估计模型;或借助cifar10字段构建场景与物体分类的跨任务学习框架。数据无需额外预处理,已按统一格式打包为parquet文件,仅需调用`load_dataset("sun-background-selected-metadata")`即可快速融入训练管线。
背景与挑战
背景概述
sun-background-selected-metadata数据集由麻省理工学院计算机科学与人工智能实验室(CSAIL)的研究团队构建,旨在为场景理解与图像分类任务提供精细化的背景标注资源。该数据集创建于2010年前后,核心研究问题聚焦于如何通过丰富的场景类别标签(涵盖32种室内外环境,如机场航站楼、卧室、海岸等),提升计算机视觉模型对复杂背景的辨识能力与泛化性能。作为SUN数据库的重要子集,它在场景识别、环境感知与智能监控等领域产生了深远影响,为后续研究提供了基准测试平台与标准化的评价依据。
当前挑战
该数据集所解决的领域挑战在于,传统图像数据集往往聚焦于物体识别,而场景理解面临背景多样性、光照变化与视角差异等复杂因素,导致模型难以区分语义相似场景(如“沼泽”与“湿地”)或捕获细微背景特征。构建过程中,研究者需应对大规模人工标注的高昂成本与一致性难题,确保1600个训练样本的标签准确无误,同时平衡类别分布以避免偏差。此外,如何设计出能有效利用有限样本、并兼容元数据(如人物存在性与CIFAR-10分类)的算法,仍是推动该数据集应用的关键瓶颈。
常用场景
经典使用场景
在场景理解与视觉分类领域,SUN-Background-Selected-Metadata数据集以其涵盖32个精细场景类别的丰富图像资源,成为场景识别研究的经典基准。该数据集精选了机场航站楼、卧室、植物园、城市运河等多元场景,每张图像均附有真实标签,为研究者提供了从室内到室外、从自然景观到人造环境的全面覆盖。其经典使用场景在于训练和评估深度学习模型对复杂视觉场景的分类能力,常被用于构建场景感知系统,推动计算机视觉向更精细的语义理解迈进。
解决学术问题
该数据集系统性地解决了学术界在场景分类中面临的标签细粒度不足与背景多样性缺失问题。通过纳入高细粒度的场景类别(如田野与牧场、雨林与沼泽的区分),以及控制人员与CIFAR-10干扰物体的存在,研究者能够深入分析模型对背景干扰的鲁棒性。SUN-Background-Selected-Metadata的出现,支撑了场景识别算法在现实复杂环境中的泛化能力研究,为场景不变性特征学习、上下文感知建模等前沿探索奠定了数据基础,显著推动了视觉理解领域从粗粒度分类向细粒度语义解析的转型。
实际应用
在实际应用中,该数据集的核心价值体现在为自动驾驶的环境感知提供场景先验知识。例如,借助对高速公路、工业区、停车场等道路场景的精准识别,智能驾驶系统能够根据环境类型调整决策策略。在城市规划与空间分析领域,数据集支持的场景分类技术可辅助建筑测绘与土地利用监测。此外,在增强现实与智能家居场景中,基于该数据集的模型能够通过图像快速识别居住空间(如卧室、客厅、厨房)或户外活动区(如花园、庭院),从而触发相应的自动化服务或信息叠加,实现人机交互的高效无缝衔接。
数据集最近研究
最新研究方向
该数据集聚焦于场景理解与语义分割的交叉前沿,涵盖31类精细化的室内外环境标签,如航站楼、雨林、工业区等,为细粒度视觉感知提供了高质量训练样本。结合其包含人物数量与CIFAR-10类别信息的多模态元数据,当前研究热点集中于利用此类结构化标注数据推动弱监督学习与零样本场景解析,尤其在无人机巡检、自动驾驶与城市数字化孪生等应用领域,为模型在复杂开放环境下实现稳健的场景认知奠定了关键基准,其精细分类体系对生态监测与智能安防等热点事件的技术落地具有显著支撑价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

