dev_set_v2_a1_curriculum_medium_20260813_125036
收藏资源简介:
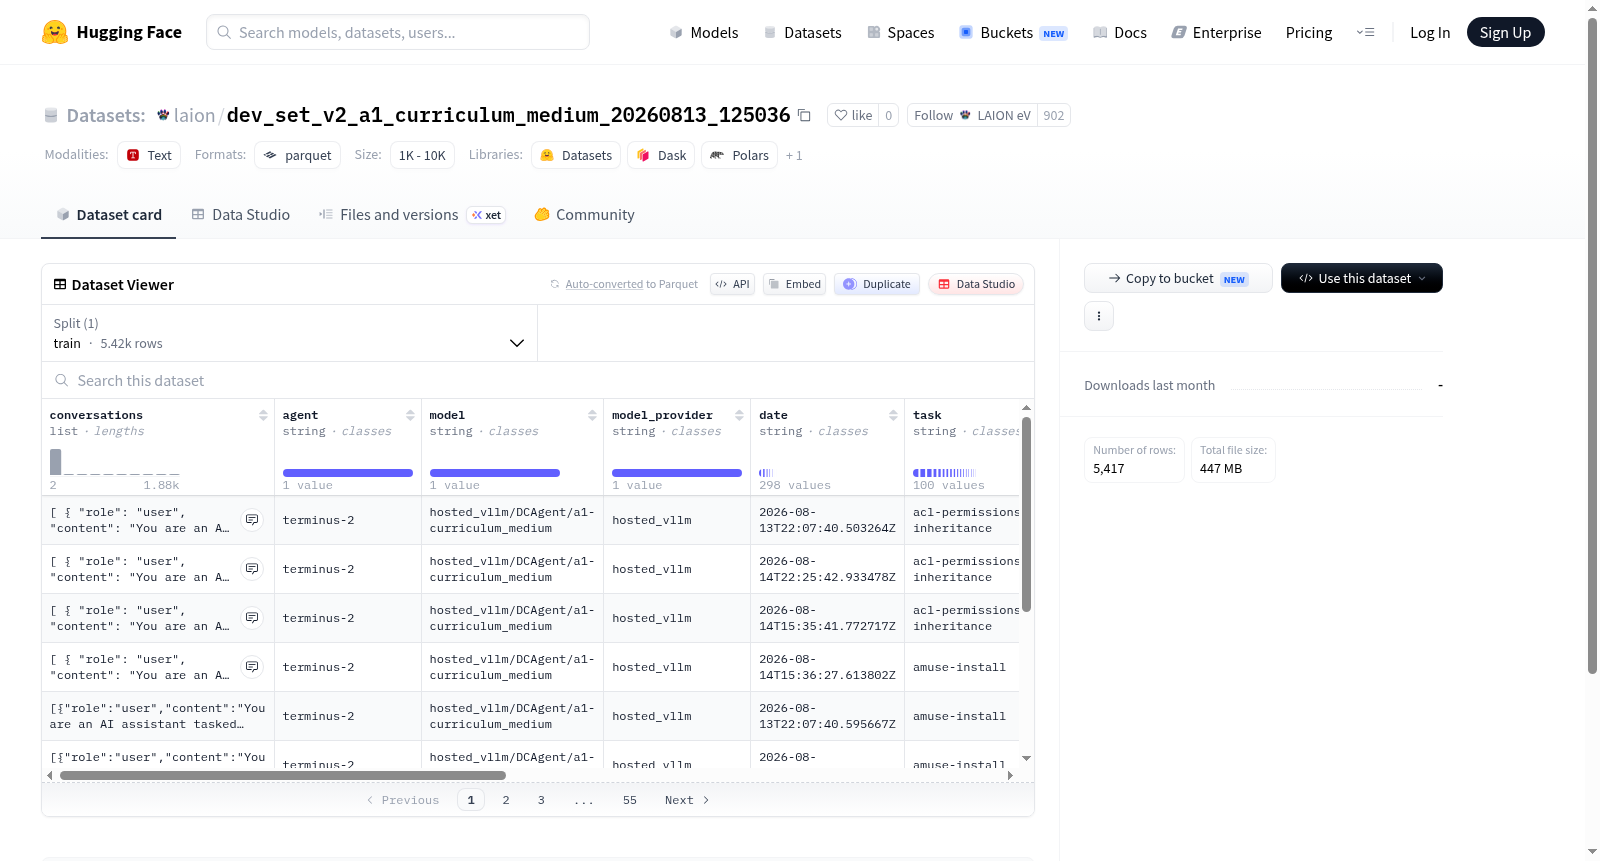
该数据集包含5417个训练样本,总大小约522MB。每个样本包含多轮对话(conversations,每轮对话有角色和内容)、代理(agent)、模型(model)、模型提供商(model_provider)、日期(date)、任务(task)、回合(episode)、运行ID(run_id)、试验名称(trial_name)、结果(result)、验证器输出(verifier_output)以及跟踪来源(trace_source)。数据集可用于研究和分析基于对话的智能体行为、模型性能比较、任务完成情况评估以及验证器效果分析等场景。
This dataset contains 5417 training samples, with a total size of approximately 522MB. Each sample includes multi-turn conversations (conversations, each turn has a role and content), agent, model, model provider, date, task, episode, run ID, trial name, result, verifier output, and trace source. The dataset can be used for research and analysis of dialogue-based agent behavior, model performance comparison, task completion evaluation, and verifier effectiveness analysis.
数据集详情总结
基本信息
该数据集名为 laion/dev_set_v2_a1_curriculum_medium_20260813_125036,由 laion 组织发布,是一个用于开发验证的数据集。
数据规模与组成
- 数据集总大小:约 522.57 MB(字节数 522,572,165)
- 下载大小:约 446.71 MB(字节数 446,705,457)
- 数据划分:仅包含一个
train划分- 样本数量:5,417 条
- 数据大小:522,572,165 字节
数据结构与特征
数据集包含以下特征(字段):
| 字段名 | 类型 | 说明 |
|---|---|---|
conversations |
列表 | 对话记录,包含 role(角色)和 content(内容)两个子字段,均为字符串类型 |
agent |
字符串 | 代理标识 |
model |
字符串 | 模型名称 |
model_provider |
字符串 | 模型提供方 |
date |
字符串 | 日期信息 |
task |
字符串 | 任务类型 |
episode |
字符串 | 回合或场景标识 |
run_id |
字符串 | 运行编号 |
trial_name |
字符串 | 试验名称 |
result |
字符串 | 结果信息 |
verifier_output |
字符串 | 验证器输出 |
trace_source |
字符串 | 追踪来源 |
配置信息
- 配置名称:
default - 数据文件:位于
data/train-*路径下的多个分片文件
使用说明
该数据集以默认配置提供,训练数据通过通配符路径 data/train-* 加载。此数据集适用于模型训练、验证及评估场景,包含完整的多轮对话记录及丰富的元数据信息,便于进行任务追踪与分析。