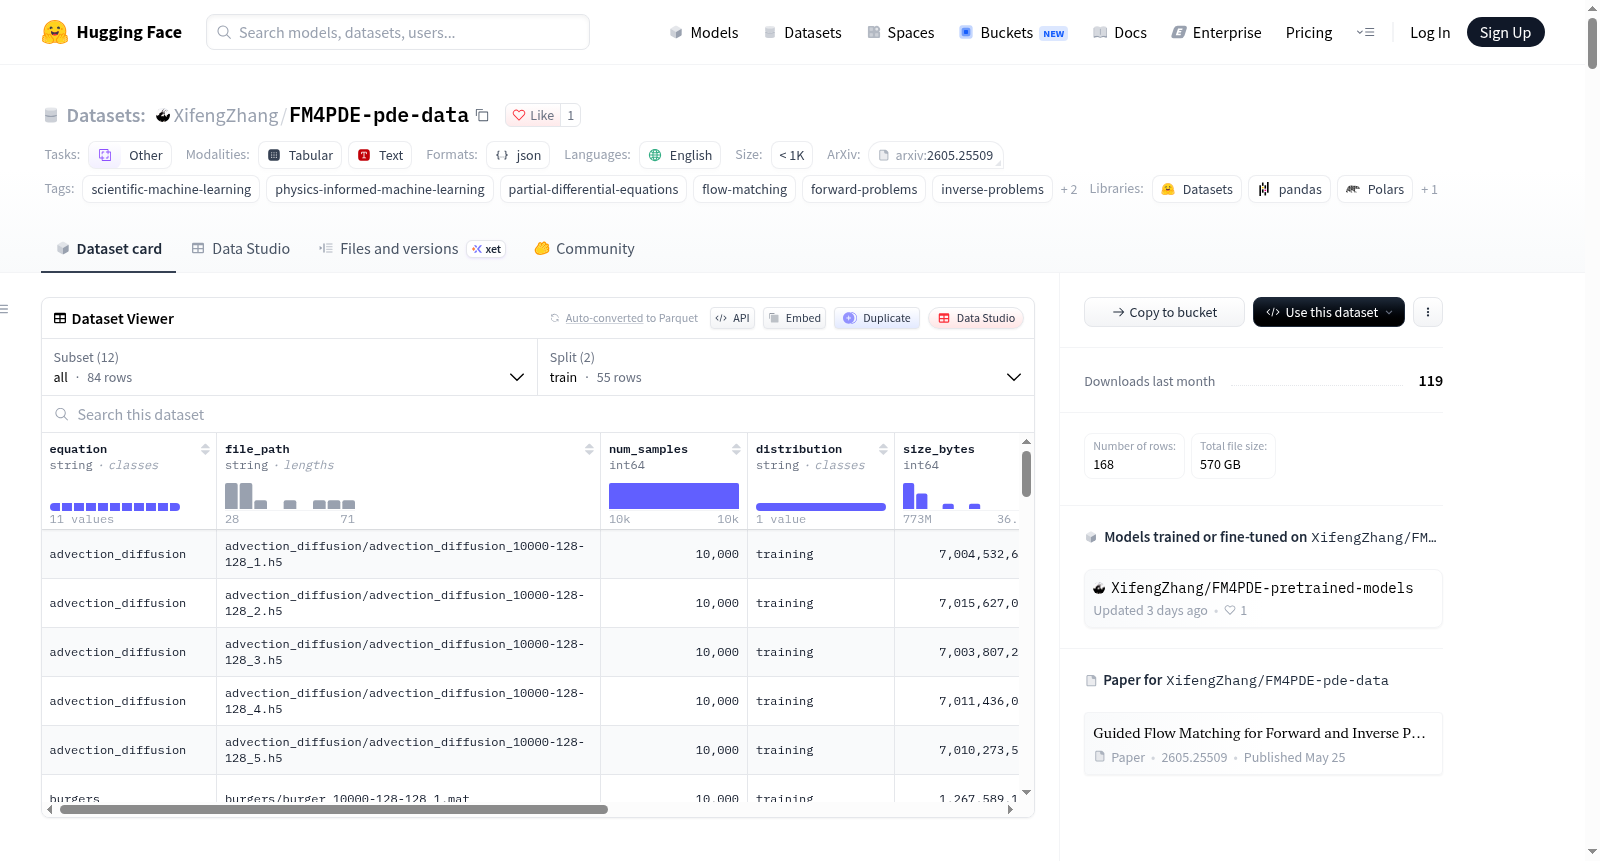
FM4PDE-pde-data
收藏资源简介:
该数据集是 FM4PDE(Guided Flow Matching for Forward and Inverse PDE Problems with Sparse Observations)的配套数值 PDE 数据,由 Xifeng Zhang 和 Jin Zhao 发布。数据集包含 11 个方程族的训练和测试样本:泊松方程、亥姆霍兹方程、达西流、纳维-斯托克斯方程、伯格斯方程、热传导方程、对流-扩散方程、反应-扩散方程、浅水方程、波动方程以及稳态热传导方程。数据以 .mat 和 .h5 格式存储,组织方式与 FM4PDE 代码期望的目录结构一致。完整发布版包含 55 个训练分片(共 550,000 个样本)和 29 个命名测试文件(共 218,000 个样本),每个方程族有 5 个训练分片(每片 10,000 样本),测试文件根据分布类型(ID、Smooth、Rough、Rough2、Rough3)命名。训练配置中默认使用每个方程族 50,000 样本池中的 45,000 训练和 5,000 验证样本。数据集适用于正向、逆向及联合重构问题,特别是稀疏观测场景下的物理信息机器学习。
This dataset is the accompanying numerical PDE data for FM4PDE (Guided Flow Matching for Forward and Inverse PDE Problems with Sparse Observations), released by Xifeng Zhang and Jin Zhao. The dataset contains training and test samples from 11 equation families: Poisson equation, Helmholtz equation, Darcy flow, Navier-Stokes equations, Burgers equation, heat equation, advection-diffusion equation, reaction-diffusion equation, shallow water equations, wave equation, and steady-state heat conduction equation. The data is stored in .mat and .h5 formats, organized in the directory structure expected by the FM4PDE code. The full release includes 55 training shards (550,000 samples in total) and 29 named test files (218,000 samples in total), with each equation family having 5 training shards (10,000 samples per shard). Test files are named according to distribution types (ID, Smooth, Rough, Rough2, Rough3). The training configuration uses 45,000 training and 5,000 validation samples from a pool of 50,000 samples per equation family by default. The dataset is suitable for forward, inverse, and joint reconstruction problems, particularly for physics-informed machine learning with sparse observations.
FM4PDE-pde-data 数据集总结
数据集概况
- 数据集名称:FM4PDE PDE Data
- 数据集地址:https://huggingface.co/datasets/XifengZhang/FM4PDE-pde-data
- 关联论文:Guided Flow Matching for Forward and Inverse PDE Problems with Sparse Observations: Algorithm and Theory,作者为 Xifeng Zhang 和 Jin Zhao
- 论文链接:https://arxiv.org/abs/2605.25509
- 代码仓库:https://github.com/Astringency/FM4PDE
- 预训练模型:https://huggingface.co/XifengZhang/FM4PDE-pretrained-models
- 用途:用于训练 FM4PDE,以及评估基于稀疏观测的正问题、逆问题和联合重建
- 语言:en
- 任务类别:other
- 标签:scientific-machine-learning、physics-informed-machine-learning、partial-differential-equations、flow-matching、forward-problems、inverse-problems、sparse-observations、arxiv:2605.25509
数据覆盖的方程族
数据集覆盖十一个方程族:
- Poisson
- Helmholtz
- Darcy flow
- Navier–Stokes
- Burgers
- Heat
- Advection–diffusion
- Reaction–diffusion
- Shallow water
- Wave
- Steady heat conduction
数据以 .mat 和 .h5 文件形式提供,采用 FM4PDE 代码所需的目录结构。
数据配置与划分
数据集提供以下配置:all(默认)、poisson、helmholtz、darcy、nsnonbounded、burgers、heat、advection_diffusion、reaction_diffusion、shallow_water、wave、steady_heat_conduction。
每个配置包含 train 和 test 两个 split。
各配置样本数量
| 配置 | 训练文件 / Viewer 行数 | 训练样本数 | 测试文件 / Viewer 行数 | 测试样本数 |
|---|---|---|---|---|
| poisson | 5 | 50,000 | 5 | 32,000 |
| helmholtz | 5 | 50,000 | 5 | 32,000 |
| darcy | 5 | 50,000 | 5 | 32,000 |
| nsnonbounded | 5 | 50,000 | 5 | 32,000 |
| burgers | 5 | 50,000 | 3 | 30,000 |
| heat | 5 | 50,000 | 1 | 10,000 |
| advection_diffusion | 5 | 50,000 | 1 | 10,000 |
| reaction_diffusion | 5 | 50,000 | 1 | 10,000 |
| shallow_water | 5 | 50,000 | 1 | 10,000 |
| wave | 5 | 50,000 | 1 | 10,000 |
| steady_heat_conduction | 5 | 50,000 | 1 | 10,000 |
| all | 55 | 550,000 | 29 | 218,000 |
- 训练/验证划分:每个方程的 50,000 样本训练池中,使用 45,000 训练样本和 5,000 验证样本。
- 测试分布通过
distribution列区分:ID、Smooth、Rough、Rough2、Rough3。 - ID、Smooth、Rough 测试文件各含 10,000 样本;Rough2 和 Rough3 文件(如列出)各含 1,000 样本。
数据结构
各配置的特征字段一致,包括:
equation(string)file_path(string)num_samples(int64)distribution(string)size_bytes(int64)format(string)upload_status(string)download_url(string)
Dataset Viewer 说明
- Dataset Viewer 展示的是完整文件目录,每一行代表一个原始数据文件,而非一个数值 PDE 样本。
- 选择
all可浏览所有方程,或选择十一个方程配置之一,再选择train或test。 num_samples列给出该文件中的数值样本数。- 原始文件包含共享坐标数组、不同的样本轴约定以及 MATLAB/HDF5 布局,因此使用显式目录配置以避免 Viewer 将科学文件当作普通表格处理。
- 原始数值字段保留原始格式,可通过 FM4PDE loaders、
h5py或scipy.io.loadmat读取。
文件清点
- 完整文件清单包含 89 个文件:55 个训练分片、29 个命名测试文件、5 个兼容性测试副本。
- 84 个训练/命名测试文件总计 697.38 GB;全部 89 个路径总计 728.93 GB(十进制文件大小,1 GB = 1,000,000,000 字节)。
- 每个方程族有五个训练分片,每片 10,000 样本,每个方程的样本池为 50,000。
上传状态
- 上传状态检查时间:2026-09-30 19:03:08 UTC+08:00
- 该快照下:73/89 个文件已上传,16 个正在加载。
- 状态检查对应数据集修订版本:
5c1197bcdd93 ✅表示文件已提交到 Hub 且报告大小与发布清单匹配。loading表示检查时尚未提交;该状态为带日期的快照,并非实时进度显示。
各方程文件与大小概览
| 方程 | 训练文件 | 测试文件 | 大小 (GB) | ✅ | loading |
|---|---|---|---|---|---|
| Poisson | 5 | 6 | 22.81 | 11 | 0 |
| Helmholtz | 5 | 6 | 22.81 | 11 | 0 |
| Darcy flow | 5 | 6 | 34.25 | 11 | 0 |
| Navier–Stokes | 5 | 6 | 198.97 | 8 | 3 |
| Burgers | 5 | 4 | 11.41 | 9 | 0 |
| Heat | 5 | 1 | 42.04 | 4 | 2 |
| Advection–diffusion | 5 | 1 | 42.05 | 3 | 3 |
| Reaction–diffusion | 5 | 1 | 87.60 | 3 | 3 |
| Shallow water | 5 | 1 | 216.72 | 4 | 2 |
| Wave | 5 | 1 | 45.64 | 3 | 3 |
| Steady heat conduction | 5 | 1 | 4.64 | 6 | 0 |
| 总计 | 55 | 34 | 728.93 | 73 | 16 |
测试文件计数包含五个兼容性副本;这些副本不是额外的独立测试集。
各方程文件明细
Poisson
- 目录:
poisson/ - 内容:静态 2D 源到解对
- 格式:MAT v5 文件,包含
f_data和phi_data,形状均为(N, 128, 128)
| 文件 | 划分 / 角色 | 样本数 | 大小 (GB) | 状态 |
|---|---|---|---|---|
| poisson_10000-128-128_1.mat | 训练分片 | 10,000 | 2.479 | ✅ |
| poisson_10000-128-128_2.mat | 训练分片 | 10,000 | 2.479 | ✅ |
| poisson_10000-128-128_3.mat | 训练分片 | 10,000 | 2.479 | ✅ |
| poisson_10000-128-128_4.mat | 训练分片 | 10,000 | 2.479 | ✅ |
| poisson_10000-128-128_5.mat | 训练分片 | 10,000 | 2.479 | ✅ |
| poisson_test_10000-128-128_id.mat | 测试 · ID | 10,000 | 2.479 | ✅ |
| poisson_test_10000-128-128_smooth.mat | 测试 · Smooth | 10,000 | 2.479 | ✅ |
| poisson_test_10000-128-128_rough.mat | 测试 · Rough | 10,000 | 2.479 | ✅ |
| poisson_test_1000-128-128_rough2.mat | 测试 · Rough2 | 1,000 | 0.248 | ✅ |
| poisson_test_1000-128-128_rough3.mat | 测试 · Rough3 | 1,000 | 0.248 | ✅ |
| poisson_test_10000-128-128.mat | 兼容性副本 · Smooth | 10,000 | 2.479 | ✅ |
Helmholtz
- 目录:
helmholtz/ - 内容:静态 2D 源到波场对
- 格式:MAT v5 文件,包含
f_data和psi_data,形状均为(N, 128, 128)
| 文件 | 划分 / 角色 | 样本数 | 大小 (GB) | 状态 |
|---|---|---|---|---|
| helmholtz_10000-128-128_1.mat | 训练分片 | 10,000 | 2.479 | ✅ |
| helmholtz_10000-128-128_2.mat | 训练分片 | 10,000 | 2.479 | ✅ |
| helmholtz_10000-128-128_3.mat | 训练分片 | 10,000 | 2.479 | ✅ |
| helmholtz_10000-128-128_4.mat | 训练分片 | 10,000 | 2.479 | ✅ |
| helmholtz_10000-128-128_5.mat | 训练分片 | 10,000 | 2.479 | ✅ |
| helmholtz_test_10000-128-128_id.mat | 测试 · ID | 10,000 | 2.479 | ✅ |
| helmholtz_test_10000-128-128_smooth.mat | 测试 · Smooth | 10,000 | 2.479 | ✅ |
| helmholtz_test_10000-128-128_rough.mat | 测试 · Rough | 10,000 | 2.479 | ✅ |
| helmholtz_test_1000-128-128_rough2.mat | 测试 · Rough2 | 1,000 | 0.248 | ✅ |
| helmholtz_test_1000-128-128_rough3.mat | 测试 · Rough3 | 1,000 | 0.248 | ✅ |
| helmholtz_test_10000-128-128.mat | 兼容性副本 · Smooth | 10,000 | 2.479 | ✅ |
Darcy flow
- 目录:
darcy/ - 内容:2D Darcy 流的渗透率场和压力场
- 格式:
.mat文件使用 HDF5 存储 - 字段:
thresh_a_data、thresh_p_data、lognorm_a_data、lognorm_p_data,存储形状为(128, 128, N);使用 FM4PDE loader 选择系数族并调整轴顺序
| 文件 | 划分 / 角色 | 样本数 | 大小 (GB) | 状态 |
|---|---|---|---|---|
| darcy_10000-128-128_1.mat | 训练分片 | 10,000 | 3.723 | ✅ |
| darcy_10000-128-128_2.mat | 训练分片 | 10,000 | 3.723 | ✅ |
| darcy_10000-128-128_3.mat | 训练分片 | 10,000 | 3.723 | ✅ |
| darcy_10000-128-128_4.mat | 训练分片 | 10,000 | 3.723 | ✅ |
| darcy_10000-128-128_5.mat | 训练分片 | 10,000 | 3.723 | ✅ |
| darcy_test_10000-128-128_id.mat | 测试 · ID | — | — | — |
使用方式
加载文件目录
python from datasets import load_dataset
catalog = load_dataset("XifengZhang/FM4PDE-pde-data", "poisson") train_files = catalog["train"] # 5 条文件记录,代表 50,000 样本 test_files = catalog["test"] # 5 条文件记录,代表 32,000 样本
load_dataset 返回文件元数据,而非数值字段张量。
下载单个方程和划分的可用文件
python from huggingface_hub import hf_hub_download
local_paths = [] for record in train_files: if record["upload_status"] != "✅": continue # 目录快照时待上传;稍后可在 Files 标签页检查上传情况 local_paths.append(hf_hub_download( repo_id="XifengZhang/FM4PDE-pde-data", repo_type="dataset", filename=record["file_path"], local_dir="PDEdata", ))
补充说明
- 原始各方程路径保持不变。
- 关于存储布局,参考完整清单;关于数值数据加载和推理,参考 Download 和 Usage 部分。
- 训练/验证划分(45,000/5,000)由 FM4PDE 训练配置在每个方程的 50,000 样本训练池内应用。
- 该划分沿用现有训练分片和留出测试文件,不重新划分单个样本。