
multimolecule/archiveii
收藏官方服务:
资源简介:
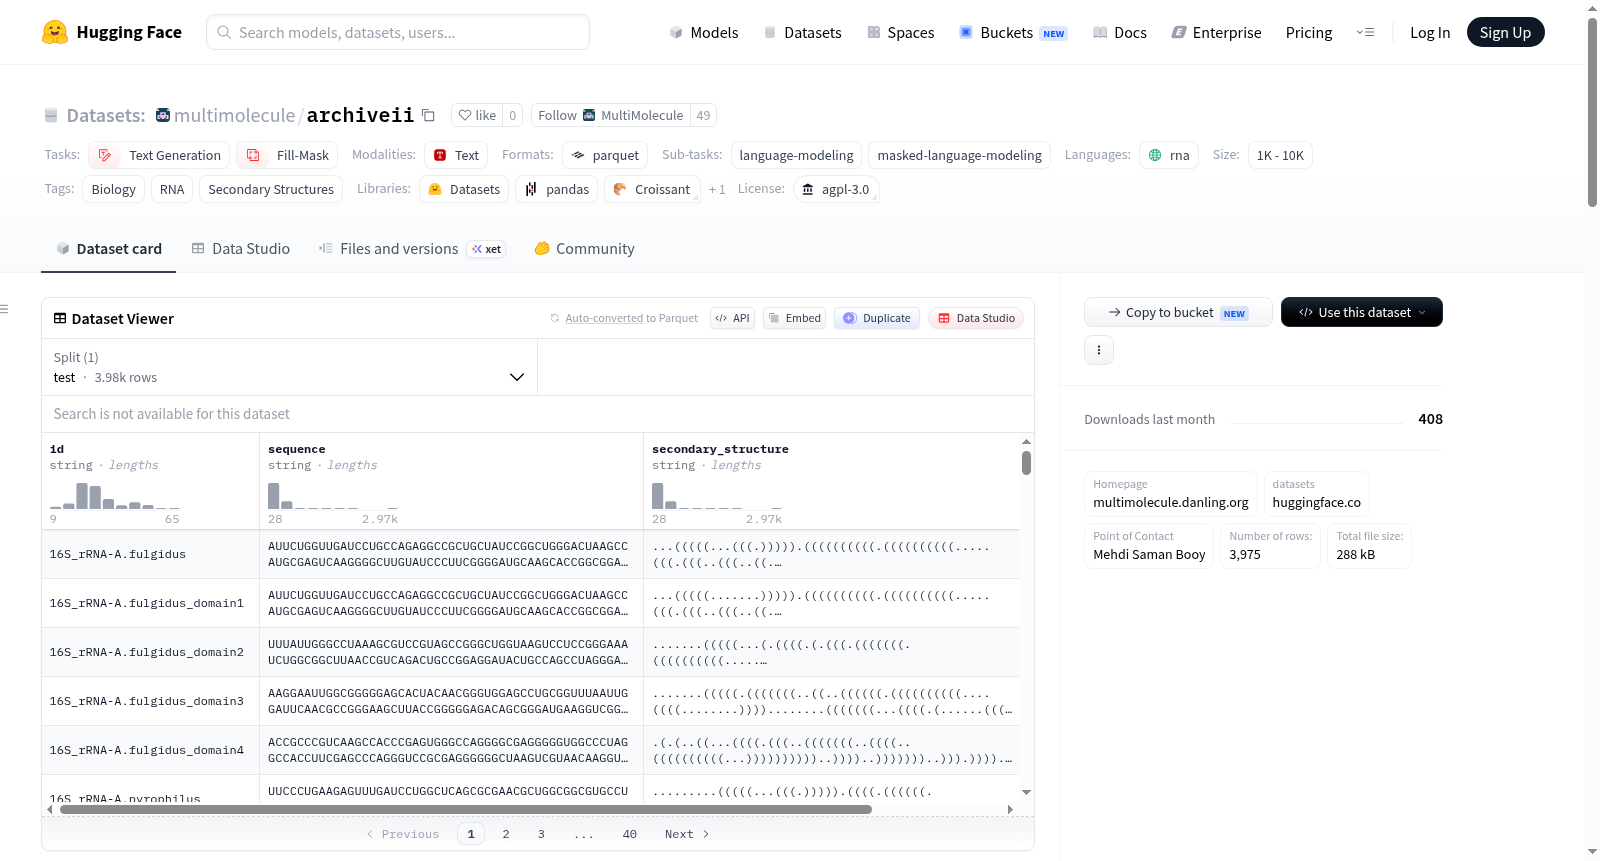
ArchiveII是一个RNA序列及其二级结构的数据集,广泛用于RNA二级结构预测的基准测试。该数据集包含来自10个RNA家族的2975个RNA样本,序列长度范围从28到2968个核苷酸。它常用于评估RNA二级结构预测方法,包括处理伪结和非伪结结构的方法,并被视为RNAStrAlign数据集的补充。
ArchiveII is a dataset of RNA sequences and their secondary structures, widely used in RNA secondary structure prediction benchmarks. ArchiveII contains 2975 RNA samples across 10 RNA families, with sequence lengths ranging from 28 to 2968 nucleotides. This dataset is frequently used to evaluate RNA secondary structure prediction methods, including those that handle both pseudoknotted and non-pseudoknotted structures. It is considered complementary to the RNAStrAlign dataset.
提供机构:
multimolecule搜集汇总
数据集介绍
构建方式
ArchiveII数据集源自多方公开RNA数据库的整合与精炼,其构建过程汇集了来自10个不同RNA家族的2975条序列及其对应的二级结构信息。每条样本均包含唯一标识符、由A、C、G、U四种碱基组成的核苷酸序列,以及采用点括号符号表达的二级结构注释,其中点号代表未配对核苷酸,括号则标示碱基配对形成的茎环区域。数据集的序列长度跨越28至2968个核苷酸,覆盖了从核糖体RNA到转运RNA等多种功能类别,为RNA二级结构预测模型的训练与评估提供了坚实的基准资源。
特点
该数据集的一大显著特色在于其囊括了包含假结与非假结两种类型的RNA二级结构,这使得它成为检验算法对复杂结构预测能力的理想平台。与同类数据集如RNAStrAlign形成互补,ArchiveII更侧重于为评估提供标准化的测试集,其多家族的数据分布和广泛的序列长度范围,充分反映了自然场景下RNA结构的多样性与复杂性。此外,数据集提供了包含全序列、以及限定长度不超过512或1024个核苷酸的变体版本,为不同计算资源下的模型验证提供了灵活选择。
使用方法
研究者可将ArchiveII作为预训练语言模型的掩码填充或序列生成任务的数据源,亦可用于监督学习下的二级结构预测。典型使用方法包括直接采用HuggingFace Datasets库加载主数据集或特定长度的变体版本,将序列特征输入深度学习模型,并依据点括号注释计算损失函数。该数据集常与RNAStrAlign配合,形成“训练-测试”的完整评估框架,助力模型对RNA折叠规律的深入理解。引用时应注明原始文献及MultiMolecule项目,以尊重学术贡献。
背景与挑战
背景概述
ArchiveII数据集由Mehdi Saman Booy等人创建,于2022年发布,是RNA二级结构预测领域中的经典基准数据集。该数据集汇聚了来自10个RNA家族的2975条序列,序列长度横跨28至2968个核苷酸,涵盖了假结与非假结两种结构类型,为评估RNA二级结构预测方法提供了标准化平台。作为RNAStrAlign的补充资源,ArchiveII在计算生物学与生物信息学领域具有重要影响力,尤其推动了基于深度学习方法的RNA结构预测研究,其贡献在于为模型性能的横向比较提供了可靠且广泛引用的参照基准。
当前挑战
ArchiveII所解决的领域核心挑战在于RNA二级结构预测,该任务需从一维核苷酸序列精确推断出复杂的碱基配对模式,特别是假结结构的识别,因其非嵌套特性对传统动态规划算法构成重大障碍。在构建过程中,数据集面临多重挑战:需确保跨家族序列的多样性以覆盖结构异质性,同时平衡较长序列(如近3000个核苷酸)的注释精度;此外,源自不同原始数据的结构标注需统一至bpRNA标准的点括号表示法,以消除格式歧义并提升数据一致性,从而为深度学习模型提供高质量的训练与评估基础。
常用场景
经典使用场景
ArchiveII数据集在RNA生物学领域扮演着基准测试核心的角色,尤其广泛用于RNA二级结构预测方法的评估。该数据集包含来自10个RNA家族的2975个样本,序列长度跨度从28至2968个核苷酸,覆盖了含假结和不含假结的多种结构类型。研究者常将其作为标准测试集,衡量基于深度学习的预测模型(如卷积神经网络)的泛化性能与结构解析精度,与RNAStrAlign数据集形成训练与测试的互补体系。
衍生相关工作
围绕ArchiveII衍生出多项经典工作,包括Mehdi Saman Booy等人提出的基于卷积神经网络的RNA二级结构预测方法,该方法在含假结结构预测上取得了突破。此外,该数据集被集成至MultiMolecule框架中,作为评估RNA专用预训练模型(如RNA-BERT)的下游任务基准,间接催生了RNAStrAlign、bpRNA-spot等关联数据集的联合使用范式,深化了跨数据集迁移学习的研究路线。
数据集最近研究
最新研究方向
在RNA生物学领域,ArchiveII数据集已成为评估RNA二级结构预测方法的核心基准,尤其在处理含伪结与不含伪结的复杂结构时展现出关键价值。随着深度学习技术的迅猛发展,该数据集正被广泛用于训练和测试基于卷积神经网络等前沿架构的预测模型,推动了对RNA结构-功能关系的深入理解。此外,结合bpRNA与PDB等来源的跨数据集整合研究日益活跃,旨在提升预测的泛化能力,为RNA药物设计及合成生物学中的热点事件提供强有力的数据支撑,其影响深远且意义重大。
以上内容由遇见数据集搜集并总结生成


