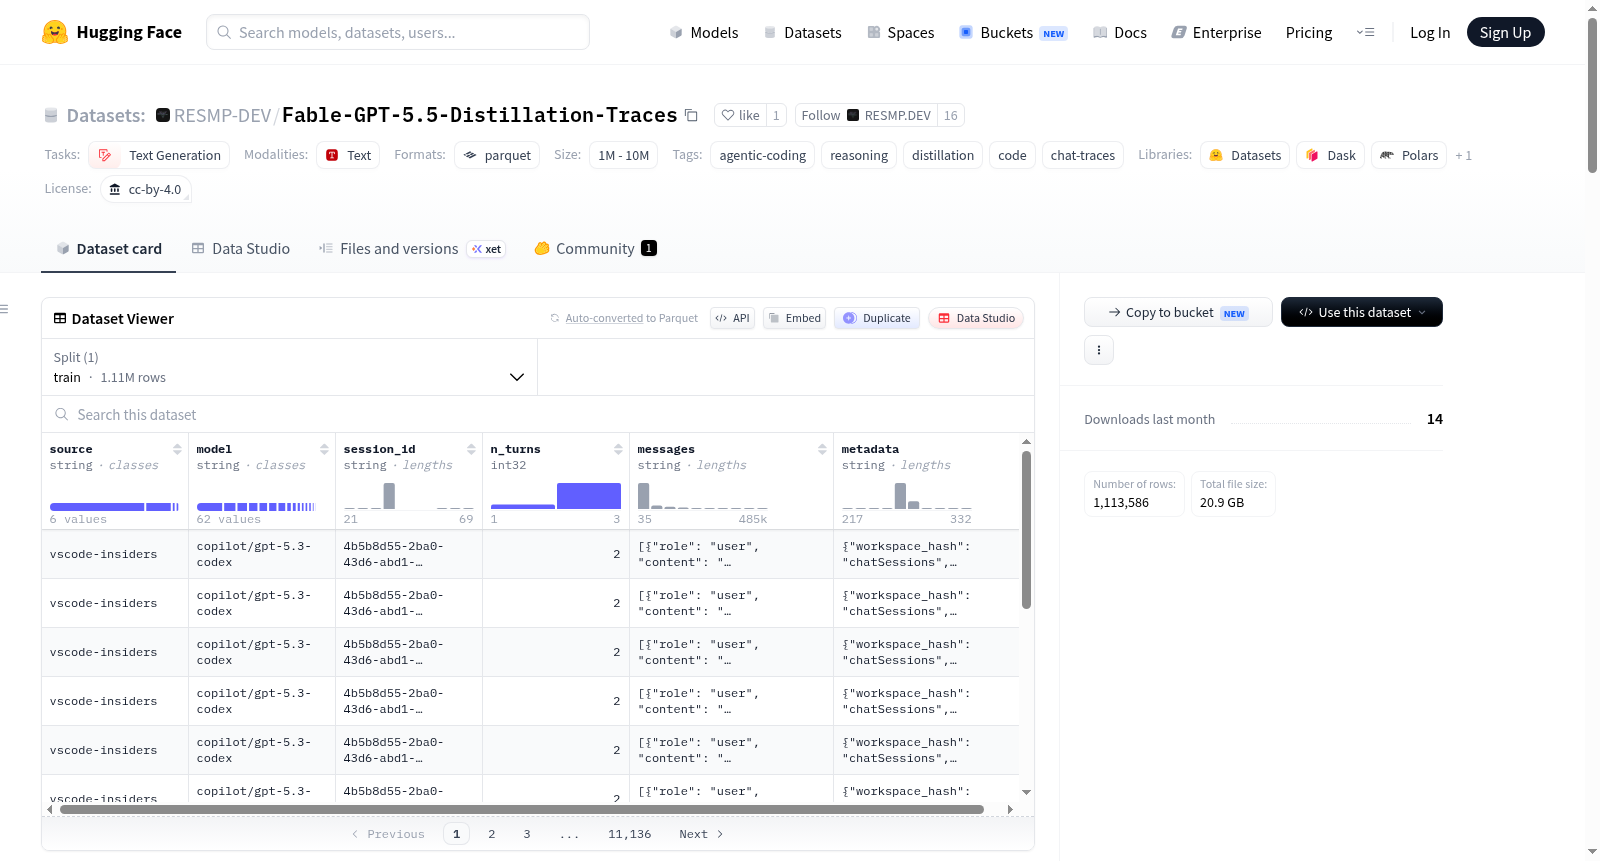
Fable-GPT-5.5-Distillation-Traces
收藏资源简介:
Agent Traces Curated 2026 是一个精选的聊天轨迹语料库,包含 1,113,586 条记录,总计约 147 亿词元,汇集了来自 19 个不同来源的数据。该数据集专为模型蒸馏流程设计,旨在作为蒸馏工具包(如 DistillKit)进行 logit 捕获的提示端语料库。其核心内容是真实的多轮对话记录,每条记录代表一个完整的会话,数据主要来源于个人实际使用的编码代理会话(如 Codex CLI、Gemini CLI、VS Code Copilot、Claude Code)以及多个开源的代理式推理和指令数据集。数据经过精心清洗和去重,过滤了 API 密钥、个人身份信息(PII),并移除了包含速率限制或失败标记且无助手响应的会话。每条数据都遵循统一的模式,包含来源标识、模型标签、唯一会话 ID、消息轮数、以 JSON 字符串存储的消息列表(包含角色和内容)以及源特定的元数据。该数据集具有显著的代理交互特征,其中工具消息占比高达 44.2%,代码块比例约为 48.4%。数据整体以 CC-BY-4.0 许可证发布,但用户需同时遵守其上游各来源数据集(包括 CC-BY-4.0 和 Apache-2.0 等)的相应许可证条款。
Agent Traces Curated 2026 is a curated chat trajectory corpus containing 1,113,586 records, totaling approximately 14.7 billion tokens, aggregated from 19 different sources. This dataset is specifically designed for model distillation workflows, intended to serve as a prompt-side corpus for logit capture in distillation toolkits like DistillKit. Its core content consists of real multi-turn dialogue records, with each record representing a complete session. The data primarily originates from personally used coding agent sessions (e.g., Codex CLI, Gemini CLI, VS Code Copilot, Claude Code) as well as multiple open-source agent-style reasoning and instruction datasets. The data has been meticulously cleaned and deduplicated, filtering out API keys, personally identifiable information (PII), and removing sessions containing rate-limiting or failure tokens without assistant responses. Each data entry follows a unified schema, including source identifier, model label, unique session ID, number of message turns, a message list stored as a JSON string (with roles and content), and source-specific metadata. The dataset exhibits significant agent interaction characteristics, with tool messages accounting for 44.2% and code blocks approximately 48.4%. The data is released under the CC-BY-4.0 license overall, but users must also comply with the respective license terms of its upstream source datasets (including CC-BY-4.0 and Apache-2.0, among others).
数据集概述:Agent Traces Curated 2026
基本信息
- 数据集名称:Agent Traces Curated 2026
- 许可证:CC-BY-4.0(数据集整体编排、去重与打包);上游来源数据保留原始许可证
- 任务类别:文本生成
- 数据规模:1,113,586 条记录,来自 19 个来源,约 14.7 B tokens
- 数据集格式:Parquet(snappy 压缩),约 58 GB JSONL 压缩至 19 GB
- 托管链接:https://huggingface.co/datasets/RESMP-DEV/Fable-GPT-5.5-Distillation-Traces
用途
该数据集是为蒸馏流程构建的提示侧语料库(prompt-side corpus),每条记录为多轮对话(messages: [{role, content}, ...])。可与开放权重教师模型(如 GLM 5.2,通过 vLLM 部署)配对使用,生成新的响应并捕获 logits,用于蒸馏至约 27B 参数的学生模型。
数据来源(共 19 个)
| 来源 | 记录数 | Token 数 | 许可证 | 致谢 |
|---|---|---|---|---|
nemotron-swe-v3 |
237,577 | 8.08 B | CC-BY-4.0 | NVIDIA Nemotron |
open-r1-math(default + extended + train) |
412,722 | 1.51 B | Apache-2.0 | Open-R1 |
open-thoughts |
113,957 | 652 M | Apache-2.0 | OpenThoughts |
codex |
75,783 | 1.00 B | CC-BY-4.0(用户收集) | RESMP-DEV(Jason Lu, Elliot Arledge) |
nemotron-cp-python |
41,439 | 1.48 B | CC-BY-4.0 | NVIDIA Nemotron |
nemotron-cp-cpp |
41,201 | 1.46 B | CC-BY-4.0 | NVIDIA Nemotron |
nemotron-swe-pivot |
48,148 | 142 M | CC-BY-4.0 | NVIDIA Nemotron |
gemini-cli |
20,876 | 277 M | 用户收集 | RESMP-DEV(Jason Lu, Elliot Arledge) |
openhermes-2.5 |
96,066 | 38 M | Apache-2.0 | Teknium(OpenHermes) |
nemotron-cp-text-to-sql |
12,071 | 35 M | CC-BY-4.0 | NVIDIA Nemotron |
fable5-crownelius |
9,223 | 1 M | 参见来源数据集 | Fable-5(Crownelius 去重) |
vscode-insiders |
3,018 | 3 M | 用户收集 | RESMP-DEV(Jason Lu, Elliot Arledge) |
fable5-glint |
651 | 49 K | 参见来源数据集 | Fable-5(Glint) |
claude-code |
674 | 215 K | 用户收集 | RESMP-DEV(Jason Lu, Elliot Arledge) |
codex-project_a/b/c |
180 | 122 K | CC-BY-4.0(用户收集) | Kevork Sulahian |
| 合计 | 1,113,586 | ~14.7 B |
数据模式(Schema)
python { "source": "nemotron-swe-v3", # 来源数据集名称 "model": "openhands-agent", # 来源模型标签 "session_id": "uuid-string", # 唯一会话标识符 "n_turns": 42, # 消息轮数 "messages": "[{role, content}, ...]" as JSON string, "metadata": "{...}" as JSON string # 来源特定的元数据 }
加载示例: python import pandas as pd df = pd.read_parquet("data-00000-of-00124.parquet") df["messages"] = df["messages"].apply(json.loads) df["metadata"] = df["metadata"].apply(json.loads)
数据统计
- 代码占比:48.4%(约 270 万个代码块,以 标记)
- 工具消息占比:44.2%(强调智能体信号)
- 中位数字符数/记录:17,557 字符(约 4.4K tokens)
- p99 字符数/记录:332,309 字符(约 83K tokens)
已应用的过滤
- ❌ 删除 API 密钥字符串(sk-, AIza, AKIA*, hf_, gh[pousr]_)
- ❌ 清除 PII(路径、邮箱、IP、Hugging Face Token)
- ❌ 移除包含速率限制/失败标记且无助手响应的会话
- ❌ 每条记录最少 100 字符,最多 500K 字符
- ❌ 对短记录(<5K 字符)使用 MinHash LSH 去重,Jaccard 相似度阈值 0.99
许可说明
- 数据集整体编排、去重与打包:CC-BY-4.0
- Nemotron 数据集(swe-v3, swe-pivot, cp-python, cp-cpp, cp-text-to-sql):CC-BY-4.0(NVIDIA)
- OpenThoughts, Open-R1-Math, OpenHermes-2.5:Apache-2.0
- 个人会话(codex, gemini-cli, claude-code, vscode-insiders):RESMP-DEV 收集,以 CC-BY-4.0 贡献
codex-project_a/b/c:Kevork Sulahian 收集,以 CC-BY-4.0 贡献- Fable-5(Crownelius, Glint):参见各自来源数据集的许可条款
下游用户若需重新分发,必须遵守所涉及来源中最严格的许可。
致谢
- 策展、去重与发布:RESMP-DEV — Jason Lu 和 Elliot Arledge
- 个人编码智能体会话贡献:RESMP-DEV(Jason Lu, Elliot Arledge);
codex-project_a/b/c由 Kevork Sulahian 贡献 - 智能体推理数据:NVIDIA Nemotron(OpenHands SWE 轨迹、竞争性编程)
- 推理与指令数据:OpenThoughts、Open-R1、Teknium(OpenHermes)
- Fable-5 提示轨迹:Crownelius 和 Glint 来源数据集