
遇见数据集

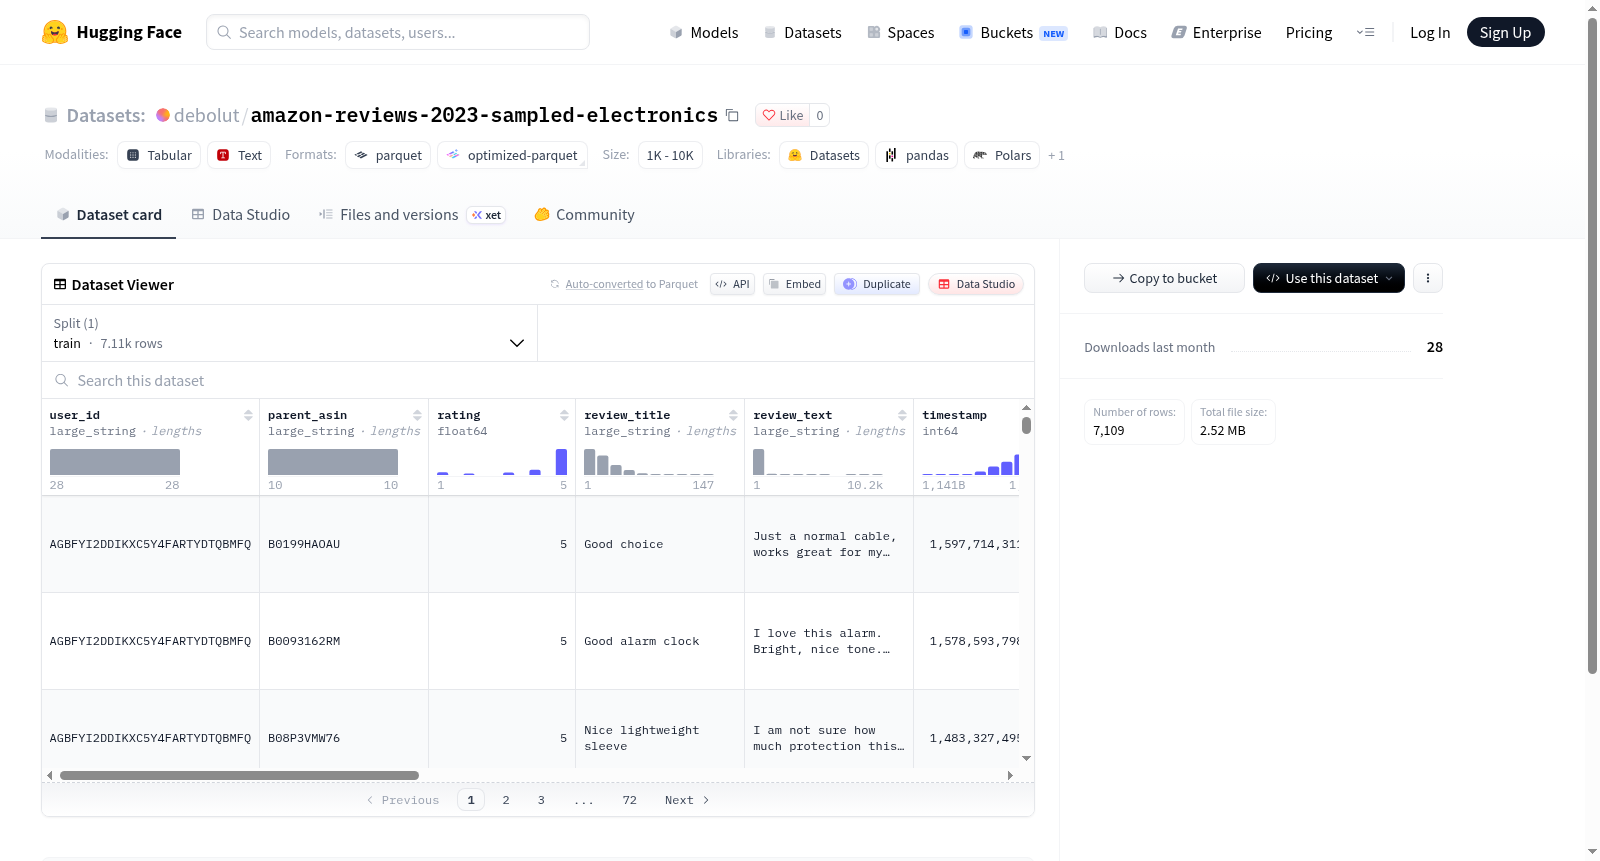
debolut/amazon-reviews-2023-sampled-electronics

收藏
Hugging Face2026-05-21 更新2026-05-31 收录
官方服务:

资源简介:

--- dataset_info: features: - name: user_id dtype: large_string - name: parent_asin dtype: large_string - name: rating dtype: float64 - name: review_title dtype: large_string - name: review_text dtype: large_string - name: timestamp dtype: int64 - name: helpful_vote dtype: int64 - name: verified_purchase dtype: bool - name: product_title dtype: large_string - name: product_description dtype: large_string - name: product_price dtype: float64 - name: product_brand dtype: large_string - name: product_categories dtype: large_string - name: image_url dtype: large_string splits: - name: train num_bytes: 133605020 num_examples: 200000 download_size: 4580247 dataset_size: 133605020 configs: - config_name: default data_files: - split: train path: data/train-* ---

This dataset is a collection of 200,000 user product reviews for analysis and modeling. Each review includes user ID, product ID, rating (float), review title, review text, timestamp (integer), helpful vote count (integer), verified purchase status (boolean), product title, product description, product price (float), product brand, product categories, and image URL. The dataset contains only a training split with a total size of 133,605,020 bytes and a download size of 4,580,247 bytes.
提供机构:
debolut
搜集汇总
数据集介绍
debolut/amazon-reviews-2023-sampled-electronics 数据集图片
构建方式
该数据集立足于电子商务平台亚马逊的电子产品评论生态,通过系统化采样策略从2023年亚马逊评论语料库中提取电子产品子集,构建过程涉及对原始评论数据的筛选、清洗与结构化整合,最终形成包含用户标识、产品标识、评分、评论文本、时间戳、有用票数、验证购买状态以及产品标题、描述、价格、品牌、类别和图片链接等多维字段的规范化数据集。
特点
数据集聚焦于电子产品领域,涵盖用户评论与产品元数据的深度融合,时间跨度明确且样本量适中,兼具文本情感分析与产品属性挖掘的双重价值,字段类型丰富,囊括数值、布尔与长文本,能够支撑评分预测、评论有用性评估、品牌与类别分析等多类研究任务,且数据经过采样处理,在保持统计代表性的同时降低了计算资源需求。
使用方法
研究者可通过HuggingFace数据集库直接加载该数据集,利用内置的train划分进行模型训练与评估,使用时需关注时间戳与验证购买等字段以控制分析偏差,评论文本可结合自然语言处理技术进行情感分类或主题建模,产品元数据则适配于推荐系统与市场分析场景,建议根据具体任务选取相关字段并遵循数据伦理规范。
背景与挑战
背景概述
随着电子商务的蓬勃发展,亚马逊等平台积累了海量用户评论数据,为推荐系统与意见挖掘提供了宝贵资源。在此背景下,2023年亚马逊评论数据集(Amazon Reviews 2023)由加州大学圣地亚哥分校的研究团队构建发布,涵盖多品类评论,其中电子产品(Electronics)子集经采样后形成amazon-reviews-2023-sampled-electronics。该数据集旨在支撑细粒度情感分析、个性化推荐及用户行为建模等核心研究问题,其丰富的元数据(如产品描述、品牌、价格)为多模态与跨域研究提供了坚实基础,对电商智能领域具有显著的推动力。
当前挑战
本数据集所面临的挑战兼具领域问题与构建过程两个维度。在领域问题上,电子产品评论常涉及专业术语与复杂情感,如何精准解析用户评价中的细粒度观点并缓解虚假评论干扰,仍是情感分析与推荐系统的核心难题。在构建过程中,数据采样需平衡类别分布与时间跨度,同时确保用户隐私脱敏与评论真实性校验;此外,产品描述与图像等多模态信息的缺失或噪声,也为数据质量与模型泛化带来额外挑战。这些因素共同构成了该数据集在学术与工业应用中的关键瓶颈。
常用场景
经典使用场景
在电子商务与自然语言处理交叉领域,该数据集凭借其丰富的用户评论与商品元数据,成为情感分析与推荐系统研究的经典基准。研究者常利用其用户评分、评论标题及文本内容,构建细粒度情感分类模型,或通过协同过滤与内容融合策略提升推荐精度。同时,评论中的验证购买标志与有用性投票为分析评论可信度与用户行为模式提供了关键信号,推动了虚假评论检测与用户偏好建模等任务的发展。
实际应用
在实际工业场景中,该数据集被广泛用于电商平台的评论智能分析与个性化推荐引擎优化。企业可借助其训练情感分析模型以实时监测用户反馈,识别产品缺陷与市场趋势;利用评论有用性投票数据优化评论排序机制,提升用户决策效率。推荐系统开发者则能基于用户-商品交互与商品描述,构建混合推荐模型,缓解数据稀疏问题。此外,验证购买标志为反作弊系统提供了真实标签,助力虚假评论过滤,从而增强平台信任度与用户留存率。
衍生相关工作
基于该数据集,学术界涌现了一系列经典衍生工作,如结合BERT与图神经网络的评论情感分类模型、利用时间序列分析的用户偏好动态追踪研究,以及融合多模态信息的商品推荐框架。部分工作进一步扩展至跨域迁移学习,探索电子品类与其他领域间的知识共享。同时,该数据集催生了若干公开基准评测,如评论有用性预测挑战赛与虚假评论检测竞赛,推动了相关算法在标准化环境下的性能对比与迭代优化,为后续研究奠定了可复现的实验基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

