遇见数据集

igbosyncorp-igbo-asr-benchmark

收藏
Hugging Face2026-07-22 更新2026-07-23 收录
官方服务:

资源简介:

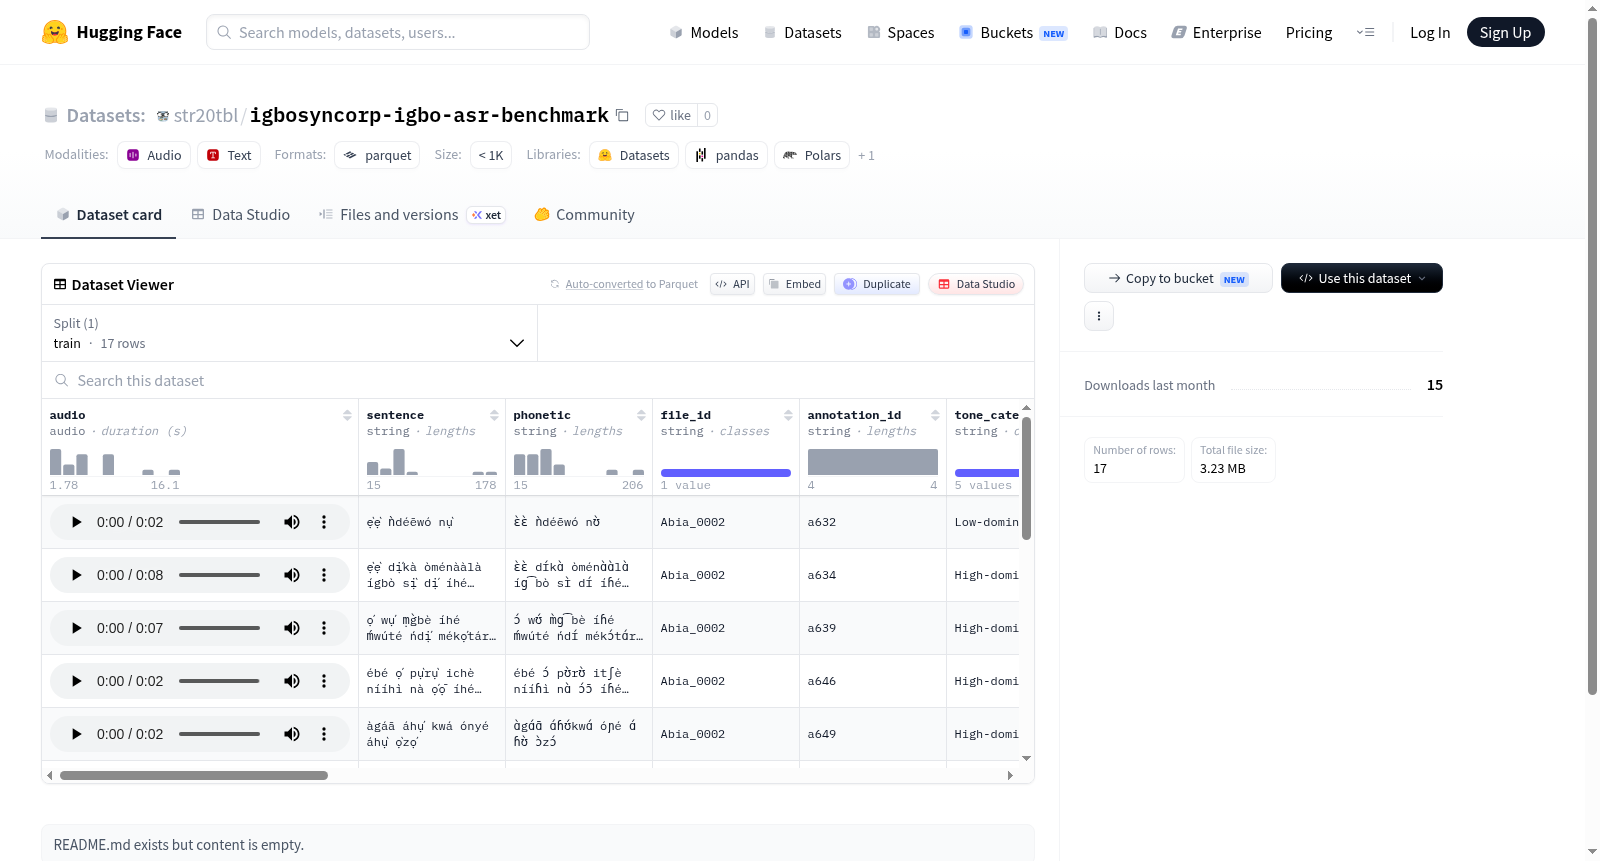
该数据集是一个多模态语音数据集,专注于语音的声学、文本及语言学标注。数据集中每个样本包含一段采样率为16kHz的音频录音及其对应的文本句子和音标转写。此外,数据集提供了丰富的语言学标注信息,包括音调类别、形态类别、长度类别和方言信息。每个音频片段都带有精确的时间戳和时长,并附有注释说明。数据集还包含量化统计特征,如高音调计数、低音调计数、降阶计数、词数、平均及最大语素数/词以及平均及最大音节数/词。数据集包含一个训练集,共17个样本,总大小约为3.2 MB。该数据集适用于语音处理、计算语言学、音调分析、方言研究以及语音-文本对齐等任务。

This dataset is a multimodal speech dataset focusing on acoustic, textual, and linguistic annotations of speech. Each sample in the dataset includes an audio recording with a sampling rate of 16kHz, along with its corresponding text sentence and phonetic transcription. Additionally, the dataset provides rich linguistic annotation information, including tone category, morphological category, length category, and dialect information. Each audio segment is accompanied by precise timestamps and duration, with annotation notes. The dataset also includes quantitative statistical features such as high tone count, low tone count, downstep count, word count, average and maximum morphemes per word, and average and maximum syllables per word. The dataset contains a training set with 17 samples, totaling approximately 3.2 MB. It is suitable for tasks such as speech processing, computational linguistics, tone analysis, dialect research, and speech-text alignment.

创建时间:
2026-07-14
原始信息汇总

数据集概述

数据集名称:IgboSyncorp-Igbo ASR Benchmark

数据集地址:https://huggingface.co/datasets/str20tbl/igbosyncorp-igbo-asr-benchmark

数据集描述

该数据集是一个用于伊博语(Igbo)自动语音识别(ASR)基准测试的数据集,包含音频文件及其对应的文本标注和丰富的语言学特征。

数据特征

数据集包含22个字段,涵盖音频、文本、语言学标注和统计信息:

  • 音频audio(采样率:16000 Hz)
  • 文本标注sentence(句子文本)、phonetic(音标)、file_id(文件ID)、annotation_id(标注ID)
  • 语言学分类tone_category(声调类别)、morph_category(形态类别)、length_category(长度类别)、dialect(方言)、notes(备注)
  • 时间信息start_ms(开始毫秒)、end_ms(结束毫秒)、duration_s(持续时间,秒)
  • 声调统计n_high(高声调数量)、n_low(低声调数量)、n_downstep(降阶调数量)
  • 词汇与语素统计n_words(单词数量)、avg_morphemes_per_word(平均每词语素数)、max_morphemes_per_word(最大每词语素数)
  • 音节统计avg_syllables_per_word(平均每词音节数)、max_syllables_per_word(最大每词音节数)

数据集划分

  • 训练集(train):共17个样本,数据大小约3.22 MB(3,215,843 字节)

配置信息

  • 默认配置名称default
  • 数据文件路径data/train-*(训练集)
搜集汇总
数据集介绍
igbosyncorp-igbo-asr-benchmark 数据集图片
构建方式
该数据集专为伊博语自动语音识别(ASR)基准测试而构建,汇集了精心标注的语音与文本对。每条样本包含16kHz采样率的音频文件、对应的书面句子及其音标转写,并附有文件标识符与注释编号。数据集的构建注重语言学细粒度,额外标注了声调类别(如高调、低调、下阶梯调)、形态类别、长度类别、方言信息以及起止时间戳和时长。此外,为便于语音学研究,还统计了词数、每词平均语素与音节数,以及每词最大语素与音节数,形成了结构严谨的多维标注体系。
特点
该数据集的核心特点在于其丰富的语言学标注层次。它不仅提供了基础的音频-文本对齐,还深入揭示了伊博语的声调特征和形态句法结构。通过包含方言标签,数据集能够支持对不同地域变体的语音研究。详尽的韵律学统计指标(如不同声调的数量)使其成为声调语言建模的宝贵资源。然而,目前仅包含17个样本的单一训练集,规模极小,这既是其作为基准测试的初步尝试,也反映了低资源语言数据采集的典型挑战。
使用方法
该数据集可直接用于训练和评估伊博语的ASR系统。用户可通过HuggingFace的`datasets`库加载,指定`config_name='default'`并选择`train`划分。加载后,可利用`audio`字段的波形数据与`sentence`字段的文本构建语音识别模型。丰富的元数据字段允许研究者按方言、声调类别或词长等条件过滤样本,进行针对性的模型性能分析。由于数据量有限,更适合用于迁移学习中的微调评估或作为数据增强方法的测试床,而非从头训练大规模模型。
背景与挑战
背景概述
在自然语言处理与语音技术迅猛发展的当下,低资源语言的语音识别研究仍面临严峻挑战。伊博语(Igbo)作为尼日利亚三大主要语言之一,其语音资源匮乏,制约了相关技术的落地应用。为此,研究人员构建了igbosyncorp-igbo-asr-benchmark数据集,该数据集专注于伊博语的自动语音识别(ASR)基准测试,旨在为这一语言提供高质量的标注语音数据。数据集由多个机构合作完成,涵盖语音、文本、音标、声调、形态、方言等多维标注信息,尤其注重声调与形态学特征,体现了对伊博语语言特性的深度挖掘。数据集的创建时间较近,反映了当前对非洲语言数字化与智能化的迫切需求。该数据集的推出,有力推动了伊博语语音技术的研究,为低资源语言ASR系统的评估与对比提供了标准化平台,对相关领域具有重要的标杆意义。
当前挑战
该数据集主要解决伊博语自动语音识别中的核心领域挑战,包括声调辨义、方言多样性以及形态复杂性问题。伊博语是一种声调语言,声调变化直接影响词义,而现有ASR系统对声调信息的处理能力薄弱,导致识别准确率低下。此外,伊博语包含多种方言变体,语音与词汇差异显著,进一步加剧了建模难度。在数据集构建过程中,挑战尤为突出:一是高质量标注数据的获取成本高昂,需兼顾语音、声调、形态、方言等多层次信息;二是样本量有限(仅17条训练样例),数据稀疏性使得模型泛化能力受限;三是声调与形态特征的细粒度标注缺乏统一标准,跨区域协作一致性难以保证。这些挑战要求后续研究在数据增强、迁移学习与细粒度声学建模方面实现突破。
常用场景
经典使用场景
在低资源语言的语音处理研究中,伊博语作为尼日利亚主要语言之一,长期缺乏高质量的语料库支撑。igbosyncorp-igbo-asr-benchmark数据集应运而生,其精妙的标注体系涵盖了音素、声调类别、形态类别、音节结构等多维语言学信息,为伊博语自动语音识别(ASR)系统的研发提供了坚实的基准测试平台。该数据集最经典的用途在于训练和评估基于深度学习的端到端语音识别模型,特别是那些需要处理声调语言特有韵律特征的架构。通过将语音信号与其对应的文本转录及细粒度音韵学标注对齐,研究者能够深入探究伊博语复杂的声调模式与音素序列之间的映射关系,从而推动低资源声调语言ASR技术的边界拓展。
解决学术问题
该数据集系统性地解决了非洲声调语言在计算语言学领域的两个核心学术难题:一是声调信息的有效编码与识别,二是形态丰富的黏着语在语音-文本对齐中的歧义消解。传统ASR模型在处理伊博语时,常因忽略声调对语义的决定性作用而性能骤降,而本数据集通过标注每个音节的高低调与阶梯调类别,为探究声调感知的神经网络表征提供了实验条件。同时,其包含的语素、词长、音节等统计数据,使得研究者能够定量分析语言复杂度对识别准确率的影响,进而提出针对性的模型正则化策略或多任务学习框架。这些工作不仅深化了对非洲语言语音学特性的理解,也为构建真正通用的多语言语音系统奠定了方法论基础。
衍生相关工作
围绕此数据集,学术界已衍生出一系列开创性工作。研究者借鉴其多维标注策略,构建了面向约鲁巴语、豪萨语等其他尼日利亚声调语言的相似基准数据集,形成了跨越语文谱系的比较研究范式。在模型层面,有工作尝试将声调类别作为辅助监督信号引入Conformer或Wav2vec 2.0架构,证实了声调感知的预训练能显著提升低资源场景下的词错误率(WER)表现。更前沿的探索将数据集中的音韵学特征与文本转写相结合,设计了端到端的声调预测模块,实现了从语音到带声调文本的直接转录,这一技术路线已被后续研究推广至多语种声调语言识别任务。这些衍生工作共同验证了精细标注的低资源语音数据集在推动计算语言学理论进步中的杠杆作用。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务