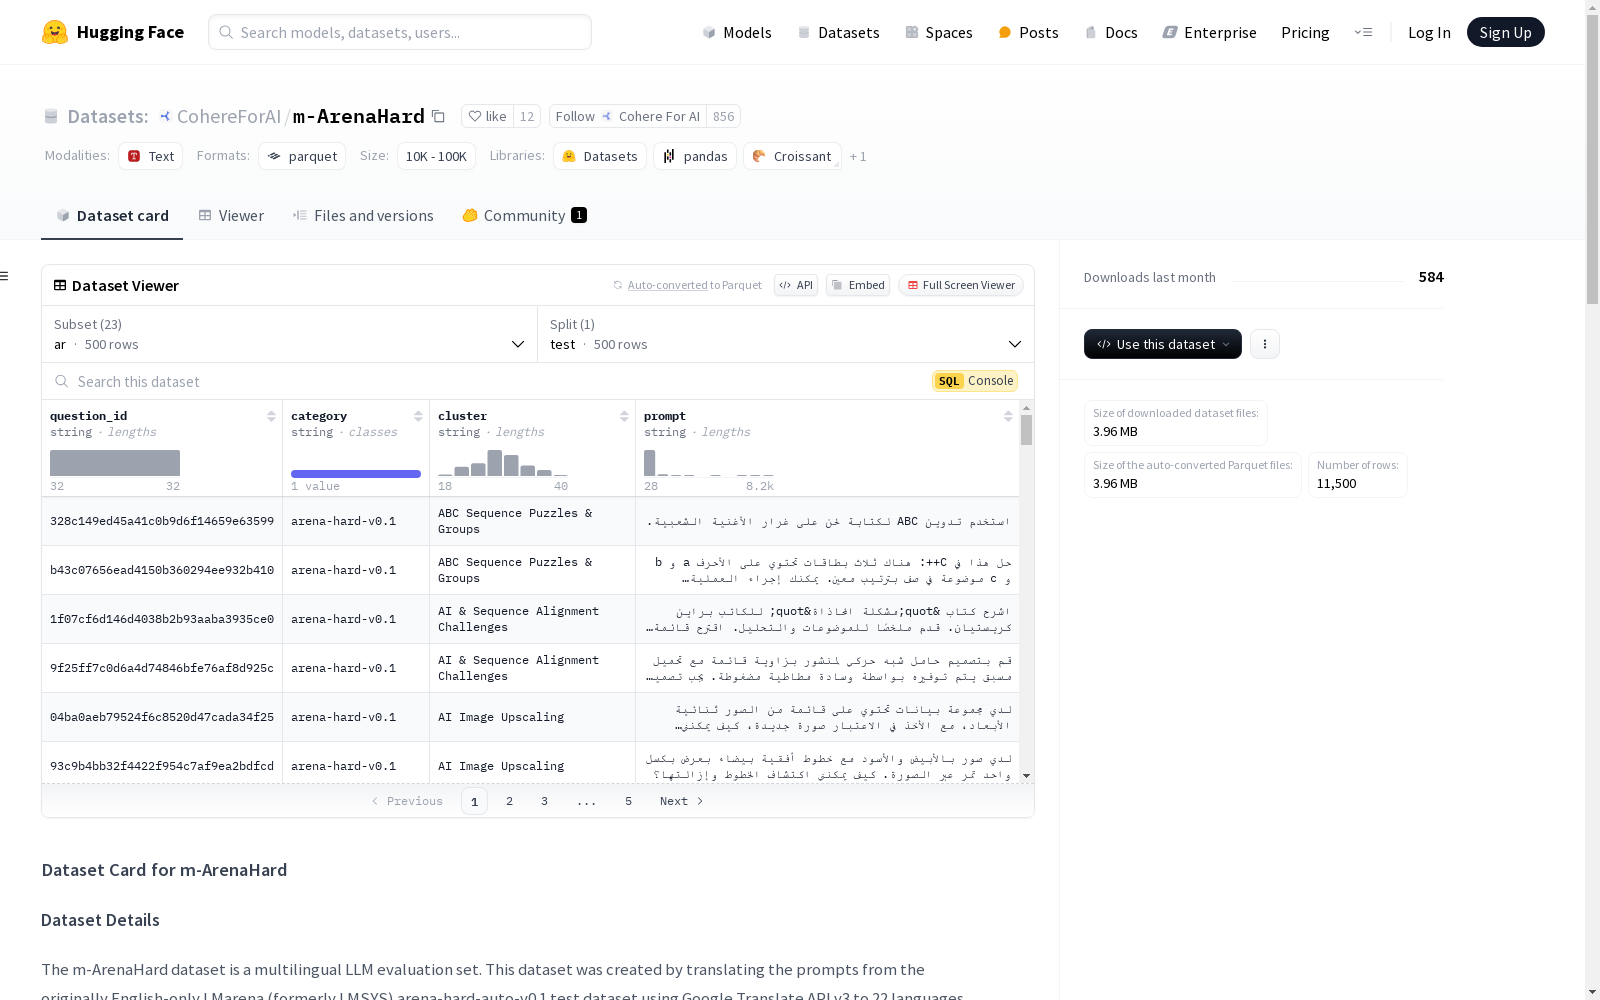
m-ArenaHard
收藏资源简介:
m-ArenaHard数据集是一个多语言的大型语言模型(LLM)评估集。该数据集通过使用Google Translate API v3将原本仅限英语的LMarena(前身为LMSYS)arena-hard-auto-v0.1测试数据集的提示翻译成22种语言而创建。原始的英语提示由Li等人(2024年)创建,包含从Chatbot Arena收集的500个具有挑战性的用户查询。该数据集总共包含23种语言,每种语言有500个示例。数据集的字段包括'question_id'、'cluster'、'category'和'prompt'。该数据集由Cohere For AI发布,并根据Apache 2.0许可证进行许可。
The m-ArenaHard dataset is a multilingual large language model (LLM) evaluation benchmark. This dataset is constructed by translating the prompts of the originally English-only LMarena (formerly LMSYS) arena-hard-auto-v0.1 test dataset into 22 languages via the Google Translate API v3. The original English prompts were created by Li et al. (2024), which contain 500 challenging user queries collected from Chatbot Arena. In total, this dataset spans 23 languages, with 500 examples per language. The dataset fields include 'question_id', 'cluster', 'category', and 'prompt'. This dataset is released by Cohere For AI and licensed under the Apache 2.0 license.
m-ArenaHard 数据集概述
数据集详情
概述
m-ArenaHard 数据集是一个多语言的大型语言模型(LLM)评估数据集。该数据集通过使用 Google Translate API v3 将原始的英语 LMarena(原 LMSYS)arena-hard-auto-v0.1 测试数据集的提示翻译成 22 种语言而创建。原始的英语提示由 Li et al. (2024) 创建,包含 500 个来自 Chatbot Arena 的挑战性用户查询。这些查询可用于执行自动 LLM 评判评估,这些评估与 Chatbot Arena 排名具有高度相关性。
语言支持
该数据集包含以下 23 种语言:
- 阿拉伯语 (ar)
- 中文 (zh)
- 捷克语 (cs)
- 荷兰语 (nl)
- 英语 (en)
- 法语 (fr)
- 德语 (de)
- 希腊语 (el)
- 希伯来语 (he)
- 印地语 (hi)
- 印度尼西亚语 (id)
- 意大利语 (it)
- 日语 (ja)
- 韩语 (ko)
- 波斯语 (fa)
- 波兰语 (pl)
- 葡萄牙语 (pt)
- 罗马尼亚语 (ro)
- 俄语 (ru)
- 西班牙语 (es)
- 土耳其语 (tr)
- 乌克兰语 (uk)
- 越南语 (vi)
数据结构
每个语言子集的数据结构如下:
question_id: 示例的唯一 IDcluster: 示例的主题category: 示例所属的原始数据集prompt: 提示文本(问题或指令)
数据集大小
每个语言子集的测试集包含 500 个示例,具体大小如下:
- 阿拉伯语 (ar): 328741 字节
- 捷克语 (cs): 258801 字节
- 德语 (de): 276977 字节
- 希腊语 (el): 411090 字节
- 英语 (en): 249691 字节
- 西班牙语 (es): 274711 字节
- 波斯语 (fa): 342307 字节
- 法语 (fr): 287086 字节
- 希伯来语 (he): 298857 字节
- 印地语 (hi): 486279 字节
- 印度尼西亚语 (id): 263904 字节
- 意大利语 (it): 269604 字节
- 日语 (ja): 300804 字节
- 韩语 (ko): 278795 字节
- 荷兰语 (nl): 265040 字节
- 波兰语 (pl): 266885 字节
- 葡萄牙语 (pt): 266432 字节
- 罗马尼亚语 (ro): 271404 字节
- 俄语 (ru): 388651 字节
- 土耳其语 (tr): 269018 字节
- 乌克兰语 (uk): 374668 字节
- 越南语 (vi): 304066 字节
- 中文 (zh): 229345 字节
数据加载
使用 datasets 库加载数据集的示例如下:
python
from datasets import load_dataset
dataset = load_dataset("CohereForAI/m_ArenaHard", "en")
版权信息
该数据集根据 Apache 2.0 许可证发布,可用于任何学术或商业目的。