FineVision-Conversations-Gemma4__31B
收藏资源简介:
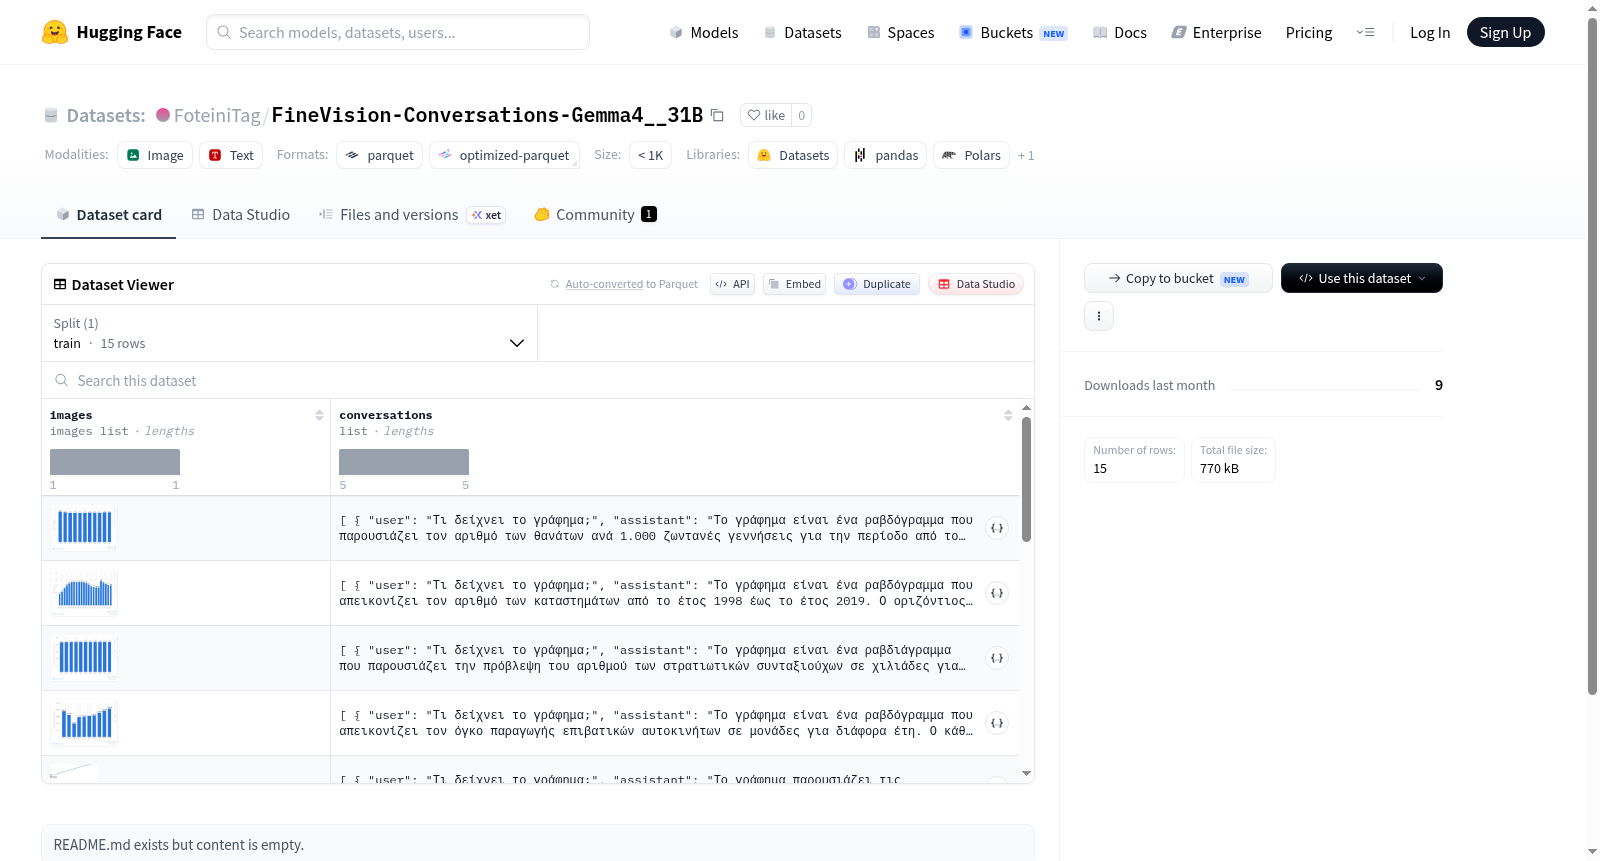
该数据集是一个多模态对话数据集,包含图像和文本对话对。每个数据样本由两部分组成:一个图像列表(‘images’字段)和一个对话列表(‘conversations’字段)。每个对话是一个包含‘user’(用户)和‘assistant’(助手)角色的轮次,两者均为文本字符串。数据集仅包含一个训练集(‘train’分割),共有15个样本。数据集的下载大小约为768KB,在磁盘上的大小约为795KB。该数据集结构适用于视觉语言理解、多模态对话生成或视觉问答(VQA)等相关任务的研究与模型训练。
This dataset is a multimodal dialogue dataset containing image and text dialogue pairs. Each data sample consists of two parts: an image list (images field) and a conversation list (conversations field). Each conversation is a turn containing user and assistant roles, both as text strings. The dataset only includes a training set (train split) with a total of 15 samples. The download size of the dataset is approximately 768KB, and the on-disk size is about 795KB. The dataset structure is suitable for research and model training in tasks such as visual language understanding, multimodal dialogue generation, or visual question answering (VQA).
数据集概要
- 名称:FineVision-Conversations-Gemma4__31B
- 来源:Hugging Face Datasets
- 任务类型:多模态对话(图像+文本)
数据特征
- 图像(images):列表类型,包含图像数据。
- 对话(conversations):列表形式,每轮对话包含两个字段:
- 用户(user):字符串,用户输入。
- 助手(assistant):字符串,模型回复。
数据集划分
- 训练集(train):15个样本,数据体积约777 KB(数据集大小为776 KB,下载大小为749 KB)。
配置文件
- 默认配置(default):包含训练集数据文件路径为
data/train-*。