cyber-investigator
收藏资源简介:
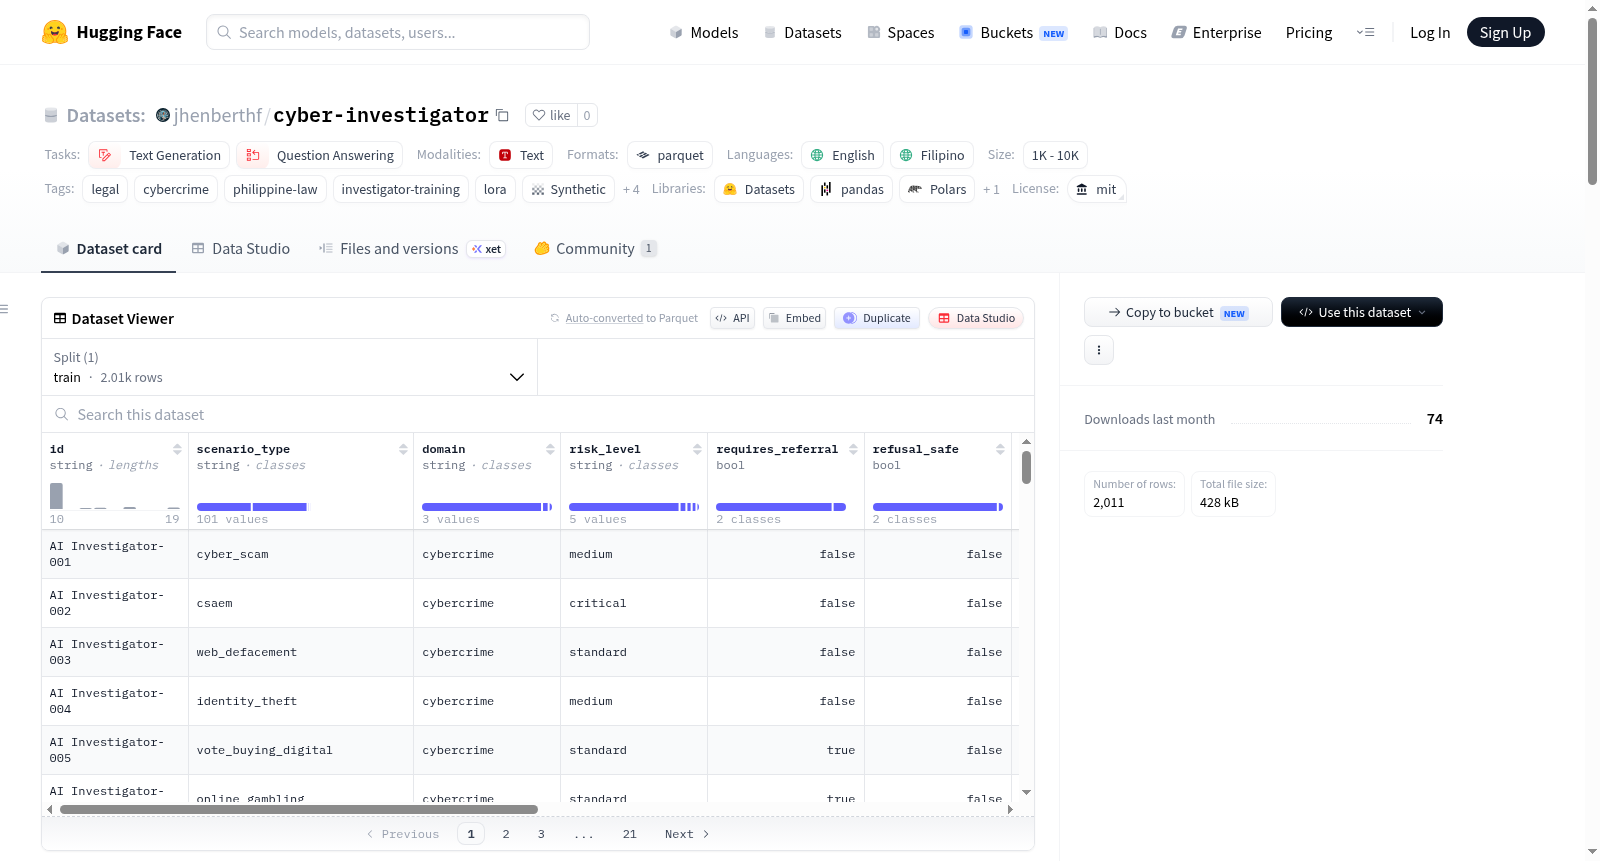
该数据集名为“cyber-investigator”,是一个专为AI助手训练设计的LoRA兼容数据集,用于评估案件事实并推荐符合菲律宾网络犯罪法(如RA 10175、RA 11934)的调查行动。数据集使用英语和Taglish(菲律宾语混合英语)。数据内容由两部分组成:1. 人工策划数据(99条):高质量、人工编写的事件报告风格示例,包含分类、推荐行动、证据优先级和下一步措施。2. 合成数据(1700条):从官方事件报告生成,经过清洗和分块处理,分为模板生成和LLM生成两步。数据字段包括id、scenario_type、domain、risk_level、requires_referral、refusal_safe、instruction、input、analysis、output、source。数据规模:训练集共2011条样本,总大小约2.65MB。适用任务:文本生成、问答,特别适用于LoRA/QLoRA微调Qwen2.5-7B-Instruct系列模型,以及检索增强推理。输出应为草稿材料,需经合格人类调查员审核。注意事项:数据集非法律权威,合成数据占多数,语料库仅39份IR文件,未进行评估集划分,存在精度权衡,语言覆盖不均衡。
The dataset named cyber-investigator is a LoRA-compatible dataset designed for training AI assistants to evaluate case facts and recommend investigative actions in compliance with Philippine cybercrime laws (e.g., RA 10175, RA 11934). It uses English and Taglish (a mix of Tagalog and English). The data consists of two parts: 1. Human-curated data (99 samples): high-quality, manually written incident report-style examples with classifications, recommended actions, evidence priorities, and next steps. 2. Synthetic data (1700 samples): generated from official incident reports indexed in a local Qdrant vector store, cleaned and chunked, with two generation steps (template-based and LLM-based). Fields include id, scenario_type, domain, risk_level, requires_referral, refusal_safe, instruction, input, analysis, output, source. Size: 2011 training samples, ~2.65 MB. Suitable for text generation, QA, especially for LoRA/QLoRA fine-tuning of Qwen2.5-7B-Instruct models and retrieval-augmented reasoning. Outputs are draft materials requiring human review. Note: not legal authority, dominated by synthetic data, corpus only 39 IR files, no evaluation split, precision trade-offs with 4-bit base models, unbalanced language coverage.
数据集概述:cyber-investigator
基本信息
- 语言:英语(en)、菲律宾语(fil)
- 许可证:MIT
- 任务类型:文本生成、问答
- 数据规模:小于1K条(实际为1,799条)
- 标签:法律、网络犯罪、菲律宾法律、调查员训练、LoRA、合成数据、RAG、菲律宾语、他加禄语
数据内容
该数据集用于训练AI助手评估案件事实并依据菲律宾网络犯罪法律(如RA 10175、RA 11934)推荐调查行动,支持英语和Taglish(英语与他加禄语混合)两种语言。数据来自两个来源:
- 人工策划数据(99条):高质量、人工撰写的事件报告风格示例,包含分类、建议行动、证据优先级和下一步调查步骤。
- 合成数据(1,700条,ID以
synth-开头):基于官方事件报告(IRs)生成,这些报告存储在本地Qdrant向量数据库中。合成过程分为两阶段:- 模板阶段(850条):使用静态模板生成(指令/输入/输出)。
- LLM阶段(850条):使用Cybercop AI的LoRA适配器(Qwen2.5-7B-Instruct-bnb-4bit + LoRA r=16)生成多样化、与主题相关的输出内容。
数据模式(Schema)
每个数据条目包含以下字段:
- id(字符串):唯一行ID;策划数据使用真实ID,合成数据以
synth-开头 - scenario_type(字符串):场景类型(如分类、报告起草、IOC提取等)
- domain(字符串):固定为
cyber_investigation - risk_level(字符串):合成数据标记为
unverified - requires_referral(布尔值):固定为
true(始终需人工复核) - refusal_safe(布尔值):固定为
true - instruction(字符串):提示/任务描述
- input(字符串):经过净化的事件报告摘录
- analysis(字符串):元注释;合成数据标注为
(synthesized from Qdrant IR chunk; verify before use) - output(字符串):推荐的响应/分类/行动
- source(字符串):合成数据来源为
sanitized IRs;策划数据有各自来源
数据净化措施
所有来源事件报告和合成数据均已清除所有单位/工作组/地区办公室/机构标识,包括单位名称、代码、地区办公室代码和机构名称(如国家警察)。净化措施包括:
- 在摄入时(Qdrant)通过正则表达式将已知单位标识替换为中性占位符
- 合成器在最终阶段再次净化文本
- 全数据集grep验证返回0个单位泄露匹配
数据划分
- 训练集:1,799条示例,文件大小约2.65 MB
- 下载大小:约228 KB
预期用途
- LoRA/QLoRA微调:适用于Qwen2.5-7B-Instruct系列模型的4-bit基础+LoRA微调
- 检索增强生成(RAG):推理时结合向量数据库的上下文使用
- 草稿/分类材料:生成分类、建议行动、证据优先级和下一步调查步骤
局限性
- 非法律权威:输出仅为建议,行动前需经过合格调查人员审查
- 合成数据占多数:约1,700/1,799条为合成数据,主要教授格式、语气和结构
- 来源语料较小:仅39份事件报告文件,256个唯一文本块,多样性有限
- 单一适配器LLM生成:合成器使用同一小型适配器,输出可能反映其偏差
- 无评估集:未进行校准或错误率测量
- 语言覆盖不均:英语和Taglish/他加禄语覆盖不均衡
范围之外的内容
- 不包含39份源事件报告以外的实时案件数据
- 不包含受害者身份识别信息(PII)
- 数据和输出中不含任何单位归属信息