
Spakie/DeepSeek-V4-Pro-distilled
收藏官方服务:
资源简介:
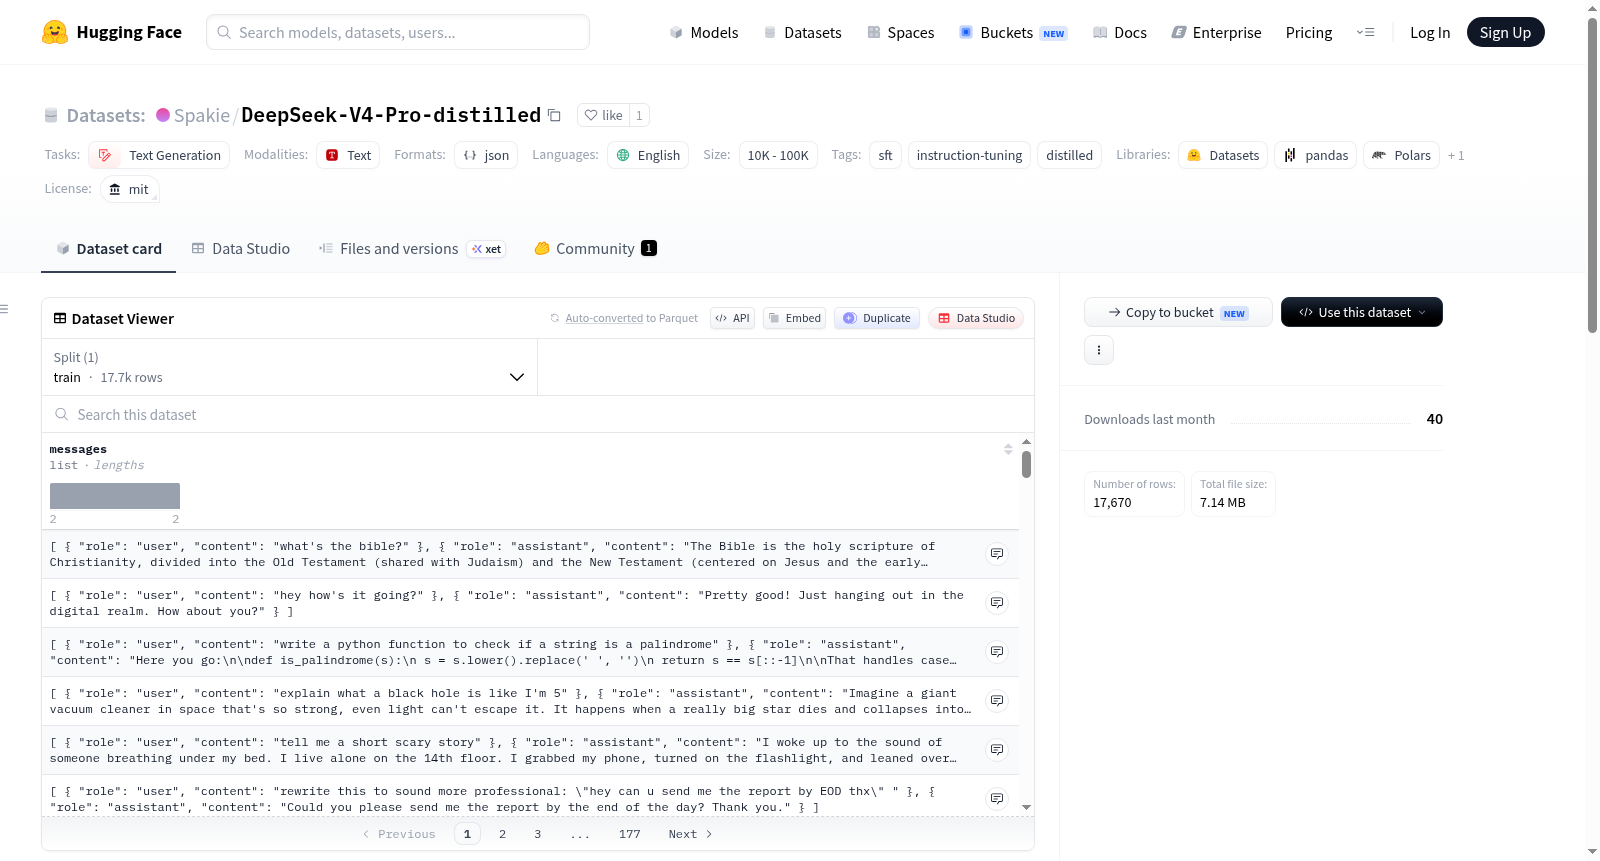
DeepSeek-V4-Pro-distilled数据集包含17,670个通用指令跟随示例,这些示例从DeepSeek-V4-Pro蒸馏而来,并使用GPT-5.5 Thinking进行事实核查和修补。数据集覆盖广泛的通用SFT混合内容,包括事实问答、编程、创意写作、解释、翻译、重写和日常对话。数据格式为标准聊天格式,兼容大多数SFT框架,每个示例为JSON对象,包含消息数组(角色为user或assistant)。该数据集可用于指令微调,但事实核查不保证100%准确,建议直接使用或作为进一步过滤/混合的基础。
17,670 general-purpose instruction-following examples distilled from DeepSeek-V4-Pro, fact-checked and patched using GPT-5.5 Thinking. Broad general SFT mix: factual Q&A, coding, creative writing, explanations, translations, rewrites, and casual conversation. Standard chat format, compatible with most SFT frameworks. Use as-is or as a base for further filtering/mixing.
提供机构:
Spakie搜集汇总
数据集介绍
构建方式
DeepSeek-V4-Pro-distilled数据集的构建依托于两条精心设计的技术路径:首先,通过调用DeepSeek-V4-Pro的应用程序编程接口,生成海量通用指令遵循样本,完成知识蒸馏过程;其次,引入GPT-5.5 Thinking模型结合网络搜索对所有样本进行事实核查与修补,以剔除潜在的幻觉与错误信息。这一双阶段流程从大规模教师模型中提炼出17,670条高质量的对话实例,确保数据在广泛覆盖通用任务的同时,维持较高的真实性保障。
使用方法
用户可通过Hugging Face的datasets库便捷加载数据,仅需一行代码即可获取训练集:调用load_dataset函数并指定仓库名称,随后通过索引访问' train '分割。数据可直接用于大多数监督微调框架,无需额外格式转换。开发者可将其作为现成的微调数据直接训练,或在此基础上进行二次筛选与混合以适配特定任务。数据集采用MIT开源许可,允许自由使用、修改与分发,降低了科研与工程应用的门槛。
背景与挑战
背景概述
在大规模语言模型迅猛演进的浪潮中,知识蒸馏技术已成为在保持强大性能的同时降低模型部署成本的有效途径。DeepSeek-V4-Pro-distilled数据集由研究者Spakie于近期创建,其核心研究问题在于如何通过蒸馏方法从DeepSeek-V4-Pro这一高性能模型中提取通用指令遵循能力,并将代表性样本以高质量形式固化下来。该数据集包含17,670条蒸馏得到的指令-回答对,覆盖事实问答、编程、创意写作、解释、翻译及日常对话等广泛领域,旨在为开源社区提供一个经过初步验证的中等规模指令微调资源。通过引入GPT-5.5 Thinking对蒸馏结果进行事实核查与补丁修复,该数据集在确保质量的同时,探索了多模型协同优化数据纯度的可行范式,对推动轻量化语言模型的发展具有潜在贡献。
当前挑战
该数据集面临的核心挑战首先源于蒸馏过程中的信息损失与风格固化:蒸馏样本不可避免地继承DeepSeek-V4-Pro的生成风格与知识边界,易引入潜在错误或偏见,限制了其在下游任务中的泛化能力。其次,尽管采用GPT-5.5 Thinking进行事实核查,但多模型级联验证仍无法彻底消除幻觉与事实偏差,且无人工标注介入进一步加剧了质量保障的难度。在构建层面,数据规模控制在万级以内,虽便于快速实验,却难以覆盖长尾场景与复杂推理需求。此外,数据格式虽遵循标准SFT框架,但缺乏多层次质量标签与领域分布统计,用户在使用时需自行过滤与配比,增加了微调流程的试错成本与不确定性。
常用场景
经典使用场景
DeepSeek-V4-Pro-distilled数据集是基于强大的DeepSeek-V4-Pro大语言模型,通过知识蒸馏技术精心构建而成,其核心设计理念在于为文本生成任务提供高质量的指令遵循样本。该数据集涵盖了17,670条通用指令示例,内容涵盖事实问答、代码编写、创意写作、文本解释、翻译、改写以及日常对话等多个维度,形成了一个丰富而多样化的监督微调(SFT)资源。在经典使用场景中,研究人员通常利用该数据集对基础语言模型进行指令微调,从而显著提升模型在遵循复杂人类指令、生成连贯且准确回复方面的能力,尤其适用于需要理解并执行多步骤指令的对话系统和智能助手训练。
解决学术问题
在学术研究领域,该数据集主要针对大语言模型在指令微调过程中面临的数据质量与数量平衡、模型对齐以及幻觉抑制等关键问题提供了解决方案。通过引入GPT-5.5 Thinking进行事实核查与错误修正,DeepSeek-V4-Pro-distilled有效减少了蒸馏数据中常见的事实性错误和幻觉现象,为研究者提供了一个经过验证的高质量训练样本库。该数据集的发布推动了模型对齐领域的进展,使得研究人员能够更专注于探索指令微调策略的优化,如数据混合比例、多任务学习以及模型泛化能力的提升,从而在无需依赖大规模原始数据的情况下,高效提升模型的实用性和可靠性。
实际应用
DeepSeek-V4-Pro-distilled数据集在实际应用中展现出广泛的适用性,特别是在需要构建高响应质量的人工智能交互系统的场景中表现出色。例如,在开发企业级智能客服或个性化教育辅导系统时,开发者可直接使用该数据集对语言模型进行微调,使其能够准确理解用户意图并生成贴合场景的回复。此外,该数据集还可作为基础资源用于构建内容生成工具,如自动摘要、代码辅助生成或多语言翻译服务,通过迁移学习快速适配特定业务需求,显著降低了从零开始收集和标注训练数据的成本与时间开销。
数据集最近研究
最新研究方向
当前,大型语言模型的蒸馏技术已成为提升小模型性能与部署效率的核心路径。DeepSeek-V4-Pro-distilled数据集应运而生,它从DeepSeek-V4-Pro中蒸馏出17,670条通用指令遵循样本,并采用GPT-5.5 Thinking进行事实核查与修补,代表了从教师模型向学生模型知识迁移的前沿实践。这一研究方向聚焦于如何利用强模型生成的高质量回应构建微调数据集,以缓解大模型推理成本高昂的问题,同时通过自动化的幻觉检测与校正机制提升数据可靠性。该数据集覆盖问答、编码、创意写作、翻译等广泛场景,为开发更轻量、更准确的对话系统提供了坚实的数据基础,并推动了开源社区在指令微调与数据质量提升方面的协同创新。
以上内容由遇见数据集搜集并总结生成


