
遇见数据集

brandonbaek/konglish-synthetic-instruct

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

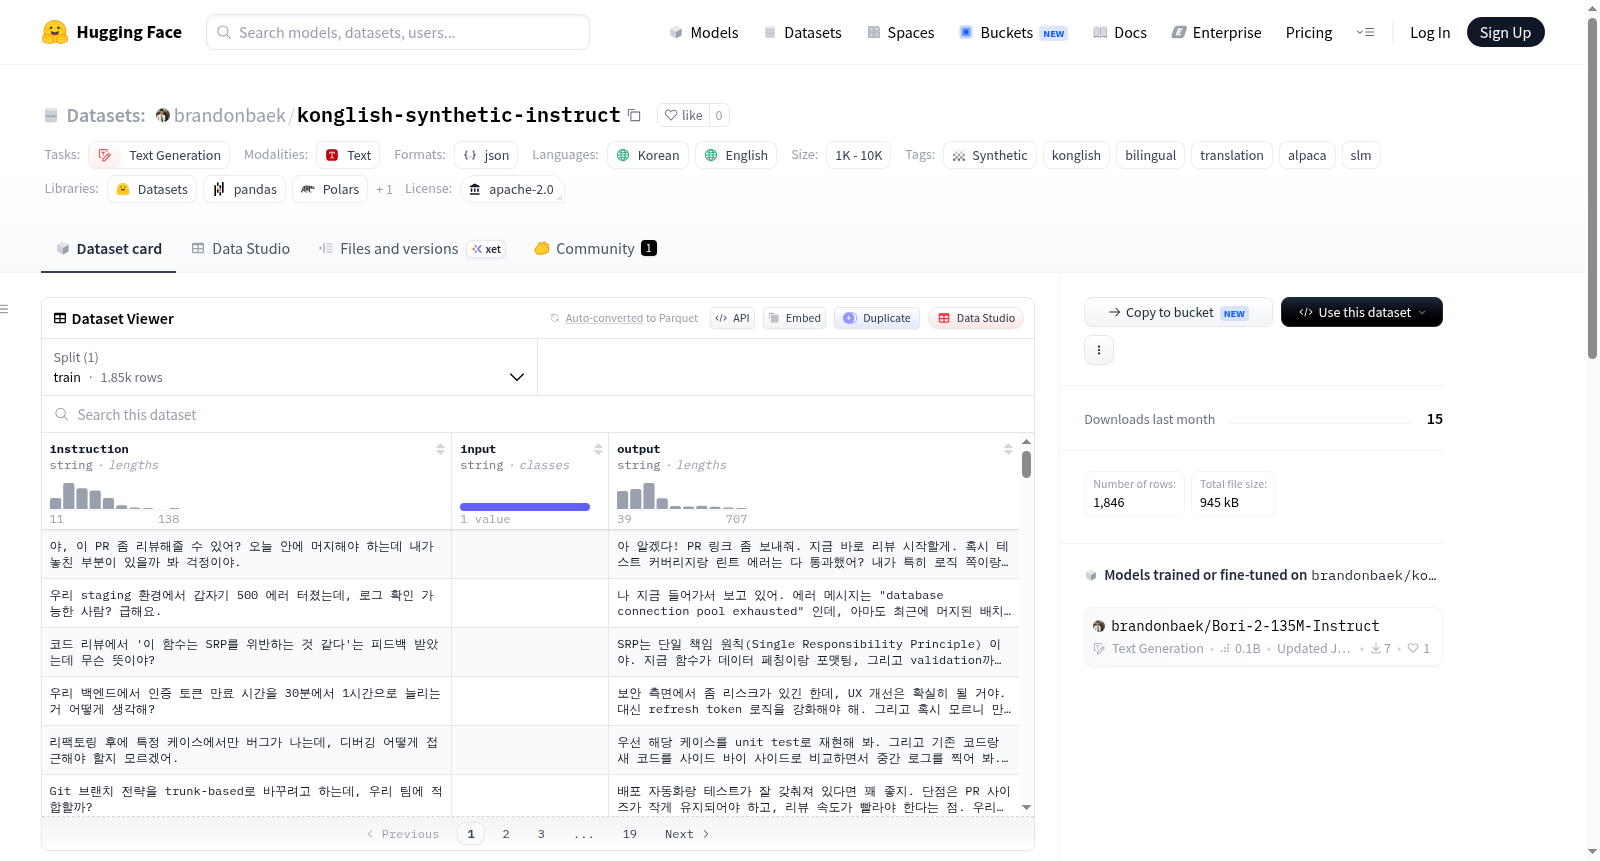
Bori V2是一个合成生成的指令跟随数据集,专门设计用于教授小型语言模型(SLMs)的双语(韩语/英语)能力、自然语码转换(Konglish)和对话翻译。该数据集使用先进的商业大语言模型(DeepSeek V4)通过自指导范式构建,旨在高度清洁、多样且语言自然。其特点包括任务多样性(涵盖对话语码转换、直接翻译请求、语法映射、Konglish习语解释和双语逻辑推理),格式采用标准的Alpaca JSON格式(包括instruction、input、output字段),以确保与标准HuggingFace Trainer和SFTTrainer管道无缝兼容,并专注于现代对话语境(如办公环境、软件开发、日常社交对话),这些语境中英语-韩语语码转换在日常韩语交流中自然发生。数据集的每个样本包含instruction(提示或任务请求,可以是英语、韩语或混合的Konglish)、input(上下文背景,可选,默认为空字符串)和output(目标黄金标准响应,展示高度自然和有用的双语/Konglish生成)。该数据集旨在用于双语小型语言模型(如SmolLM-135M或Qwen2-0.5B)的监督微调(SFT),以及对话聊天机器人中语码转换能力的对齐和评估。

This is a synthetically generated instruction-following dataset designed specifically to teach bilingual (Korean/English) capabilities, natural code-switching (Konglish), and conversational translation to Small Language Models (SLMs). It was constructed using advanced commercial large language models (DeepSeek V4) utilizing self-instruct paradigms, designed to be highly clean, diverse, and linguistically natural. The dataset features task diversity including conversational code-switching, direct translation requests, grammatical mapping, explanation of Konglish idioms, and bilingual logical reasoning. It is structured in standard Alpaca JSON format (instruction, input, output) for seamless compatibility with standard HuggingFace Trainer and SFTTrainer pipelines, and is quality-centric, focused on modern conversational contexts (office environments, software development, daily social dialogue) where English-Korean code-switching naturally occurs in everyday Korean communication. Each sample contains instruction (the prompt or task request, can be in English, Korean, or mixed Konglish), input (contextual background, optional, empty string by default), and output (the target gold-standard response demonstrating highly natural and helpful bilingual/Konglish generation). The dataset is intended for Supervised Fine-Tuning (SFT) of bilingual Small Language Models (such as SmolLM-135M or Qwen2-0.5B) and alignment & evaluation of code-switching capabilities in conversational chatbots.

提供机构:
brandonbaek
搜集汇总
数据集介绍
brandonbaek/konglish-synthetic-instruct 数据集图片
构建方式
该数据集通过先进商业大语言模型DeepSeek V4,采用自指令生成范式(self-instruct)合成构建,专为提升小型语言模型(SLMs)的双语能力而设计。数据涵盖自然代码切换(Konglish)、对话翻译、语法映射、习语解释及双语逻辑推理等多种任务类型,并以标准的Alpaca JSON格式(含instruction、input、output字段)组织,确保与HuggingFace Trainer及SFTTrainer等训练管线无缝兼容。
特点
数据集的核心特色在于其高度的任务多样性与语言学自然性,聚焦于现代韩语交流中常见的英韩代码切换场景,如办公室环境、软件开发及日常社交对话。每条样本由指令、上下文输入及高质量目标输出构成,输出响应强调双语混合表达的流畅性与帮助性,整体规模为1K至10K条,专注于质量而非数量,以培养模型在真实语境下的双语生成能力。
使用方法
该数据集主要用于小型双语语言模型(如SmolLM-135M或Qwen2-0.5B)的监督微调(SFT),亦可作为代码切换能力的对齐与评估基准。用户可直接加载JSON格式数据,利用HuggingFace标准训练工具进行微调,通过指令-输出对引导模型学习自然混合使用韩语与英语,尤其适用于构建具备双语对话能力的轻量级聊天机器人。
背景与挑战
背景概述
在双语或多语言自然语言处理领域,代码切换(code-switching)现象普遍存在于日常交流中,尤其在韩语与英语混用的“Konglish”语境下,小语言模型(SLM)常因缺乏针对性训练数据而难以生成自然流畅的混合语言文本。为应对这一挑战,Konglish-synthetic-instruct数据集于近期由Project Bori V2团队开发,依托DeepSeek V4等先进大语言模型,采用self-instruct范式合成高质量指令数据。该数据集聚焦双语能力、自然代码切换及对话翻译核心研究问题,通过涵盖办公室、软件开发、日常社交等现代对话场景,显著提升了SLM在真实交际中的表现。作为首个专为SLM设计的韩英双语合成指令集,其以Alpaca JSON格式提供,易于集成至标准训练管道,对推动小模型在混合语言环境下的对齐与评估具有重要影响力。
当前挑战
该数据集主要解决了两方面挑战。在领域问题层面,小语言模型面临训练数据匮乏的瓶颈,传统单语或平行语料难以覆盖Konglish中复杂的词汇借用、语法映射及习语混合现象,导致模型在代码切换任务中产生生硬或不自然的输出。数据集通过多样化任务(如对话代码切换、直接翻译请求、语法映射及双语逻辑推理)填补了这一空白,要求模型理解跨语言语境并保持语义连贯性。在构建过程中,合成数据的生成面临质量与多样性平衡难题:需依赖商业大模型确保语言自然度,同时避免噪声和重复样本;此外,设计符合现代对话习惯的指令模板要求深入语言学知识,以捕捉Konglish在特定场景下的使用规律,最终通过严格筛选获取约千条高质量样本,兼顾效率与可靠性。
常用场景
经典使用场景
在自然语言处理领域,双语与代码混合语料的稀缺性长期制约着小语言模型在多语言场景下的表现。konglish-synthetic-instruct 数据集专为监督式微调(SFT)设计,其经典用法在于以标准 Alpaca JSON 格式提供指令、输入与输出三元组,使研究人员能够高效地训练具备韩英双语理解与生成能力的轻量级模型。通过模拟日常对话、软件开发及办公环境中的自然语码转换现象,该数据集为小语言模型注入了处理混合语言任务的根基能力,成为评估与对齐模型双语性能的测试基准。
实际应用
在实际部署中,该数据集助力构建能够在韩英双语间无缝切换的对话系统,尤其适用于移动设备、嵌入式终端等资源受限的场景。通过微调后的模型,用户可以在日常社交、职场沟通或软件协作中体验到自然混合语言输出的智能助手,例如在支持韩英混合查询的客户服务机器人或实时翻译工具中发挥核心作用。这种能力不仅提升了人机交互的流畅性,还降低了跨语言沟通的门槛,为面向韩国市场的产品本地化提供了高效的技术方案。
衍生相关工作
作为 Project Bori V2 持续预训练与词汇扩展计划的一部分,konglish-synthetic-instruct 衍生了若干值得关注的研究方向。一方面,它启发了针对语码转换鲁棒性的对齐评估方法,催生了衡量模型在不同混合比例语言输入下表现的基准测试。另一方面,该数据集与 SmolLM-135M、Qwen2-0.5B 等小语言模型的结合实践,推动了参数高效微调技术的进步,并促进了合成数据质量评估框架的发展。这些相关工作共同勾勒出小模型在双语场景中潜力与局限的清晰图谱。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

