plottwist-movies
收藏资源简介:
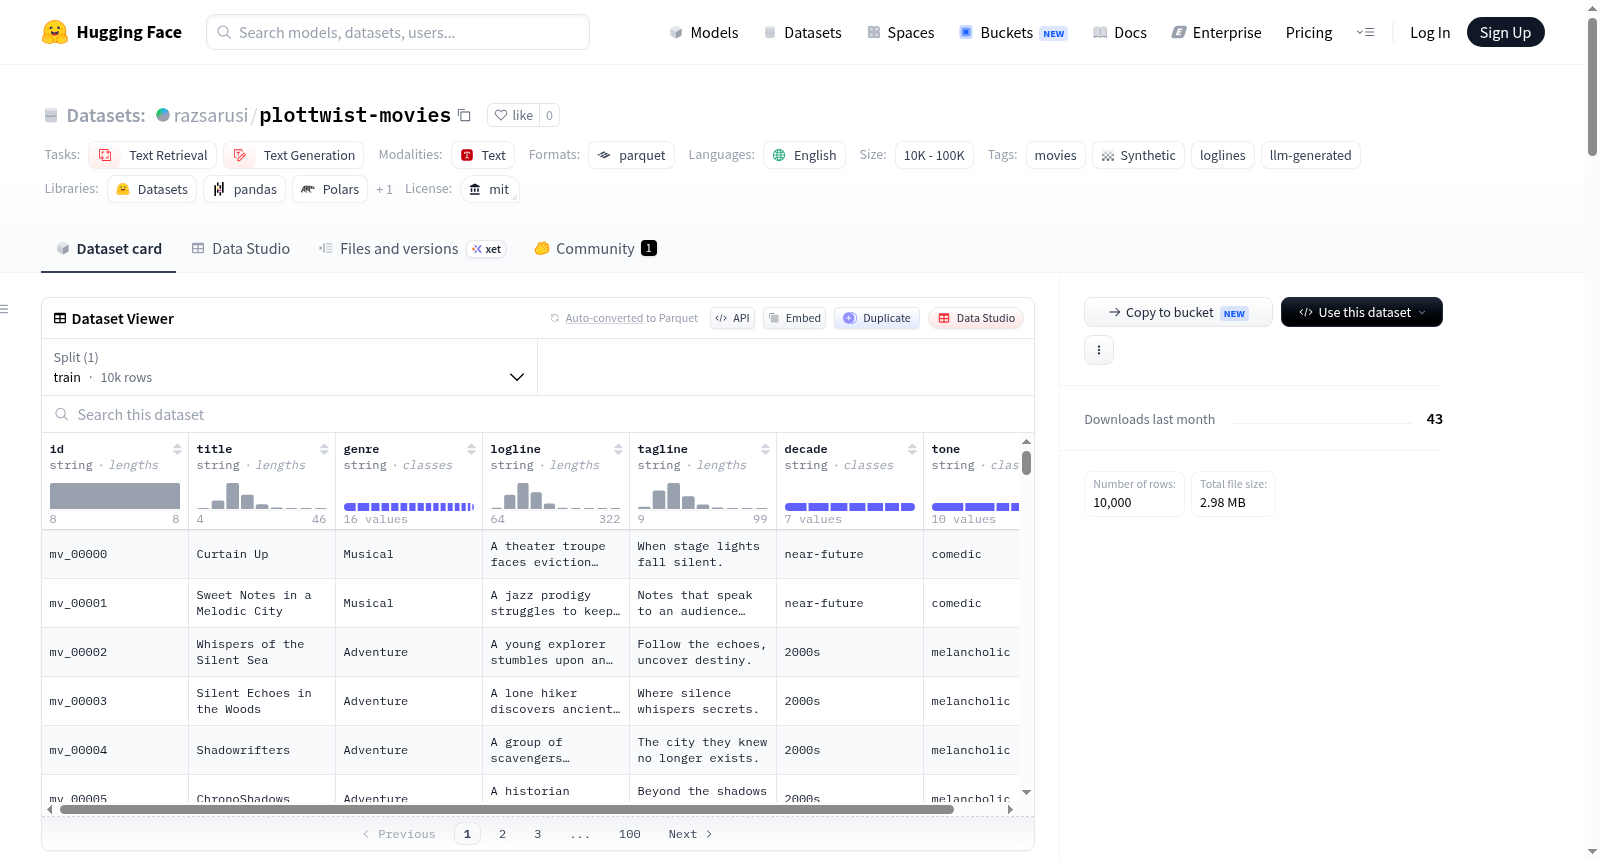
PlotTwist Movies (synthetic) v2 是一个包含 10,000 条合成电影记录的数据集,由预训练的指令微调大语言模型 Qwen/Qwen2.5-1.5B-Instruct 通过结构化提示和受控变化生成,覆盖 genre × decade × tone 的网格。每条记录包含 id、title、genre(16 个规范类型)、logline(1-2 句前提,12-60 词)、tagline(简短营销语,≤16 词)、decade(7 个规范时代)、tone(10 个规范基调)。所有分类字段均采用规范词汇表并经过验证。数据集专为 PlotTwist 应用设计:给定一个电影创意,应用推荐 3 个相似的 logline(基于嵌入向量和 FAISS)并生成一个新的原创 logline。适用任务包括文本检索(基于嵌入向量的相似推荐)、文本生成(logline 生成)、电影创意辅助、结构化数据质量控制研究。
PlotTwist Movies (synthetic) v2 is a dataset containing 10,000 synthetic movie records, generated by a pre-trained instruction-tuned large language model Qwen/Qwen2.5-1.5B-Instruct through structured prompting and controlled variation, covering a grid of genre × decade × tone. Each record includes fields: id, title, genre (16 canonical types), logline (1-2 sentence premise, 12-60 words), tagline (short marketing tagline, ≤16 words), decade (7 canonical decades), tone (10 canonical tones). All categorical fields use controlled vocabularies and are validated. The dataset is designed for the PlotTwist application: given a movie idea, it recommends 3 similar loglines (based on embedding vectors and FAISS) and generates a new original logline. It is suitable for tasks including text retrieval (embedding-based similarity recommendation), text generation (logline generation), movie idea assistance, and structured data quality control research.
PlotTwist Movies (synthetic) — v2 数据集概述
基本信息
- 许可证:MIT
- 任务类型:文本检索、文本生成
- 语言:英文
- 标签:电影、合成数据、loglines、LLM生成
- 数据规模:10K < n < 100K(实际10,000条记录)
- 配置文件:默认配置,训练集数据文件为
plottwist_movies_v2.parquet
数据集简介
该数据集包含10,000条原创的合成电影记录,由预训练的指令微调LLM(Qwen/Qwen2.5-1.5B-Instruct)通过结构化提示和受控变化生成。生成过程基于类型 × 年代 × 基调的网格进行。该数据集服务于PlotTwist应用:用户提供电影创意后,应用嵌入模型(FAISS)推荐3条相似的loglines,并生成1条新的原创logline。
数据模式(Schema)
| 字段 | 描述 |
|---|---|
id |
稳定标识符(mv_00000 等) |
title |
原创虚构标题 |
genre |
16种标准类型之一 |
logline |
1-2句话的前提描述(12-60词) |
tagline |
简短营销语(≤16词) |
decade |
7个标准年代之一 |
tone |
10种标准基调之一 |
标准词表(超出将被拒绝)
- 类型(16种):科幻、奇幻、恐怖、爱情、惊悚、喜剧、剧情、动作、悬疑、冒险、犯罪、动画、纪录片、西部、音乐剧、战争
- 年代(7种):1980s、1990s、2000s、2010s、2020s、近未来、远未来
- 基调(10种):黑暗、喜剧、暖心、讽刺、史诗、坚韧、奇想、悬疑、忧郁、充满希望
生成方法
- 系统提示:要求模型仅创作原创电影,禁止使用真实电影标题,禁止以特定陈词滥调开头,仅输出有效JSON数组
- 用户提示:每个
(类型, 年代, 基调)网格单元生成8部电影,要求严格匹配给定字段值 - 解码参数:
do_sample=True, temperature=0.9, top_p=0.95,批量生成,含两个少样本示例 - 后处理:输出经稳健JSON解析、验证、去重(标题+logline哈希归一化)、检查点保存至磁盘
数据质量修复(v1→v2)
v1版本仅限制genre字段,导致模型在其他字段上产生幻觉/漂移。v2版本通过枚举验证和过滤修复了以下问题:
| v1中测量到的缺陷 | 数量 | v2修复方式 |
|---|---|---|
非标准decade值(如1993、cyberpunk utopia) |
162个不同值(应为7个) | 枚举验证并拒绝 |
非标准tone值(如bittersweet-noir) |
1,302个不同值(应为10个) | 枚举验证并拒绝 |
类型大小写漂移(Sci-Fi vs Sci-fi) |
17个变体(应为16个) | 标准标题大小写 |
| 陈词滥调开头(“In a world where…”等) | 706条(约7%) | 提示中禁止+验证时拒绝 |
| Logline少于12词(截断/低质量) | 14条 | 词数门槛 |
EDA摘要(v2,全部10,000行)
- 完整性:0缺失值、0空字符串、0重复ID
- 重复性:0完全重复行;0条loglines在TF-IDF余弦相似度≥0.80时接近重复(高多样性)
- Logline词数:最少12词,中位数约23词,均值约23词,最大60词
- Taglines:10,000条中约9.7k条唯一(无模式坍缩)
- 覆盖率:类型、年代、基调在受控网格上分布均衡
文件内容
plottwist_movies_v2.parquet— 干净的v2数据集(推荐使用)plottwist_movies.parquet— 原始v1数据集(保留用于前后对比)Part1_Synthetic_Data_Generation_v2.ipynb— 生成代码(提示、网格、验证、检查点)Part2_EDA_v2.ipynb— 探索性分析与可视化
下游应用
推荐系统在模型编写的pitch→logline对基础上微调all-mpnet-base-v2,并使用非循环recall@k评估(基础版 vs 微调版)。微调嵌入器 + FAISS索引 + 目录已发布至:https://huggingface.co/razsarusi/plottwist-embedder-ft