
遇见数据集

EgoActionBench

收藏
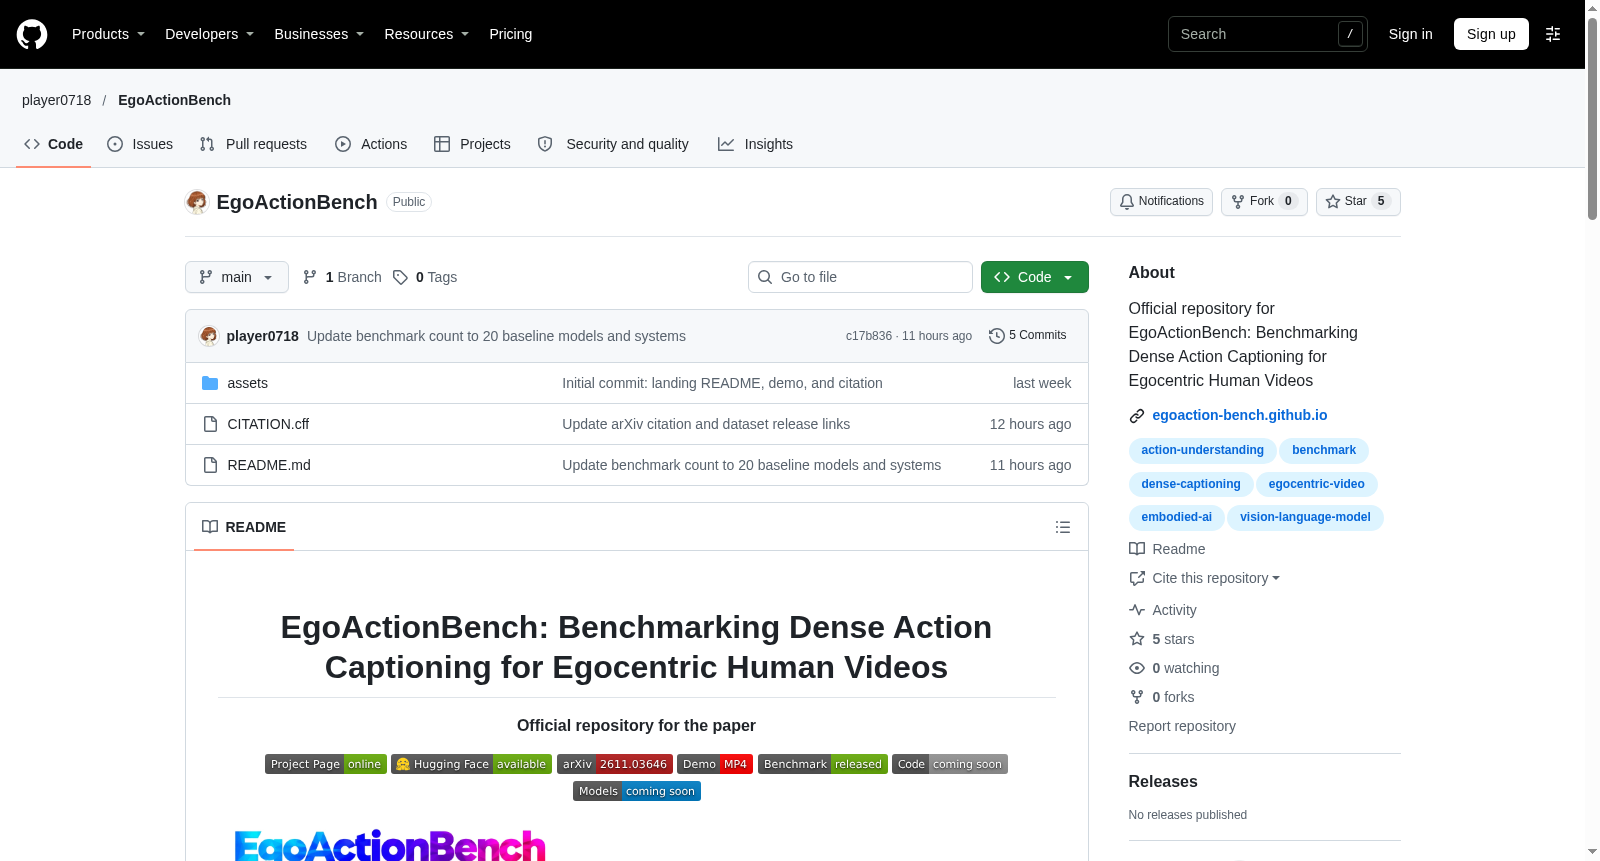
github2026-11-04 更新2026-11-05 收录
官方服务:

资源简介:

EgoActionBench 是一个用于第一人称人类视频密集动作描述(dense action captioning)的基准数据集。它将连续的人类操作表示为时间上定位的原子动作,每个动作与左手、右手或双手相关联。给定一段视频片段,模型必须识别摄像者做了什么、每个动作何时发生以及由哪只手执行。EgoActionBench 包含 1,407 个视频片段和 41,132 条人工精炼的动作标注。

创建时间:
2026-10-30
原始信息汇总

EgoActionBench 数据集总结

基本信息

  • 数据集名称:EgoActionBench
  • 任务类型:面向第一视角人类视频的密集动作描述基准
  • 论文标题:EgoActionBench: Benchmarking Dense Action Captioning for Egocentric Human Videos
  • 官方仓库:https://github.com/player0718/EgoActionBench
  • 项目页:https://egoaction-bench.github.io/
  • Hugging Face 数据集页:https://huggingface.co/datasets/play0718/EgoActionBench
  • arXiv:https://arxiv.org/abs/2611.03646
  • Demo MP4:https://github.com/player0718/EgoActionBench/blob/main/assets/egoaction-film.mp4

数据规模与任务定义

  • 包含 1,407 个 episodes。
  • 包含 41,132 条人工精炼动作标注。
  • 将连续人类操作表示为时间局部化的原子动作。
  • 每个动作关联左手、右手或双手。
  • 给定片段,模型需恢复:摄像机佩戴者做什么、每个动作何时发生、哪只手执行。
  • 标注轨道包括 Left、Right、Both hand tracks。

评测协议

  • 采用渐进式评测协议,用于密集预测。
  • 候选检索:为每个参考动作检索时间上符合条件的预测。
  • 预测选择:根据内容一致性为每个参考动作选择一个候选。
  • 评分:评分语义保真度和时间重叠,同时结合动作精确率和召回率,汇总为 EgoActionScore。

基准与模型

  • 评测 20 个基线模型和系统。
  • 提出 EgoAction。
  • EgoAction 基于 Qwen3-VL-4B 和 LLaVA-OneVision-2-8B,通过监督微调后强化学习适配。
  • EgoAction 在其两个 backbone 上分别将 EgoActionScore 提升 15.9 和 23.2 分,并优于所有开源基线。

亮点

  • 原子化、时间局部化的动作标注,覆盖 Left、Right、Both hand tracks。
  • 协议联合评估“发生什么”“何时发生”“哪只手执行”。
  • 包含 20 个基线模型和系统的基准。
  • EgoAction 在两项 backbone 上提升 EgoActionScore,并超过所有开源基线。

发布状态

  • 2026/10:项目页和 Demo 视频上线。
  • 2026/11:论文在 arXiv 可用。
  • 2026/11:基准视频、标注和元数据在 Hugging Face 可用。
  • 已发布:论文和 arXiv。
  • 已发布:项目页。
  • 已发布:Demo MP4。
  • 已发布:EgoActionBench 视频、标注和元数据。
  • 待发布:评测工具包(EgoActionScore)。
  • 待发布:20 个已评测基线模型和系统的预测。
  • 待发布:EgoAction checkpoints。
  • 待发布:自动标注训练数据及训练脚本(SFT 和 RL)。
  • 待补充:许可证和详细环境说明。
  • 代码和模型状态:即将发布。

获取方式

  • 在 Hugging Face 数据集页面请求访问:https://huggingface.co/datasets/play0718/EgoActionBench

  • 批准后使用同一账号登录并下载。

  • 下载命令: bash hf auth login hf download play0718/EgoActionBench --repo-type dataset --local-dir EgoActionBench

  • 数据集包含视频目录、annotations.jsonl 文件和 metadata.jsonl 文件。

  • 字段定义和加载示例见数据集 README;标注示例和基准结果见项目页。

  • 公共评测工具包正在准备发布。

数据来源

  • 基于 Ego4D:https://ego4d-data.org
  • 基于 EgoLife:https://egolife-ai.github.io
  • 基于 EPIC-KITCHENS-100:https://epic-kitchens.github.io
  • 源视频访问受其原始许可证和条款约束。

引用

bibtex @misc{shen2026egoactionbench, title = {EgoActionBench: Benchmarking Dense Action Captioning for Egocentric Human Videos}, author = {Shen, Yujiao and Song, Jiahe and Li, Haitian and Yang, Jingkang and Liu, Ziwei}, year = {2026}, eprint = {2611.03646}, archivePrefix = {arXiv}, primaryClass = {cs.CV}, url = {https://arxiv.org/abs/2611.03646} }
搜集汇总
数据集介绍
EgoActionBench 数据集图片
构建方式
在以自我为中心的人类视频理解领域,密集动作标注构成了连接视觉感知与行为语义的关键基座。EgoActionBench的构建依托Ego4D、EgoLife与EPIC-KITCHENS-100等公开视频源,将连续的人类操作过程解析为具有时间定位的原子动作单元,并为每一动作标注其归属于左手、右手或双手。数据集涵盖1,407个视频片段,经人工精炼后形成41,132条动作标注,同时发布视频、annotations.jsonl与metadata.jsonl等元数据,以支撑密集动作描述的模型训练与评测。
使用方法
对于从事自我中心视频动作理解的研究者,EgoActionBench提供了可直接用于模型评测与开发的数据资源。使用者需在Hugging Face数据集页面申请访问权限,经批准后以同一账户执行hf auth login,并通过hf download play0718/EgoActionBench --repo-type dataset --local-dir EgoActionBench下载数据。获得的数据包含videos/、annotations.jsonl与metadata.jsonl,字段定义与加载示例可参阅数据集README。当前评估工具包、基线预测、EgoAction检查点及训练代码尚在准备中,后续将逐步开放。
背景与挑战
背景概述
在自我中心视觉与多模态视频理解持续深化的语境中,EgoActionBench由Yujiao Shen、Jiahe Song、Haitian Li、Jingkang Yang、Ziwei Liu等研究者于2026年提出,聚焦第一视角人类视频的密集动作描述。其核心问题是将连续人类操作解析为时间定位的原子动作,并同时判定动作内容、发生时刻及执行手别。该基准汇集1,407个视频片段与41,132条人工精炼标注,数据源涵盖Ego4D、EgoLife和EPIC-KITCHENS-100,并设置20个基线模型与系统进行评测。EgoActionBench以EgoActionScore统一衡量语义保真、时间重叠及动作精度与召回,为细粒度时序动作理解、手部操作归因和第一视角多模态建模提供基准平台,对可穿戴视觉与具身智能研究具有推动作用。
当前挑战
围绕密集动作描述这一任务,EgoActionBench的核心领域难题在于第一视角视频中连续操作的高度纠缠性:模型须在动态视角、手部遮挡、物体交互和长时序依赖下,同时识别原子动作语义、界定起止边界并归因于左手、右手或双手,现有系统在细粒度定位与手别判别上仍显不足。基准构建亦面临多重挑战:多源视频来自Ego4D、EgoLife与EPIC-KITCHENS-100,许可与访问条件各异;将连续行为切分为原子动作并形成41,132条人工精炼标注,需要统一时间边界、手别归属与语义粒度;候选检索、预测选择及EgoActionScore评分协议须在密集预测下平衡语义保真、时间重叠、精度与召回;适配Qwen3-VL-4B和LLaVA-OneVision-2-8B等骨干并开展SFT与RL训练,还需应对领域迁移与评估一致性。
常用场景
经典使用场景
面向第一视角人类视频理解,EgoActionBench的经典使用场景在于以密集动作描述为核心任务:给定一段自我中心视频片段,模型须辨识相机佩戴者正在执行何种操作、每个原子动作发生于何时,以及动作由左手、右手抑或双手完成。基准将连续操作解构为时序局部化的原子动作,并配套候选检索、预测选择与EgoActionScore评分,联合衡量语义保真度、时间重叠及动作精确率与召回率,从而系统检验多模态模型对细粒度行为流的结构化解析能力。
解决学术问题
针对第一视角视频中密集动作描述长期面临的标注稀疏、动作边界模糊与手别归属缺失等难题,EgoActionBench提供了1,407段情节与41,132条人工精修动作标注,覆盖左手、右手和双手轨迹。其渐进式评估协议将内容一致性与时序对齐纳入统一框架,缓解了传统指标难以同时评价“做什么、何时做、哪只手做”的局限。该基准为多模态大模型在细粒度时序定位与跨模态行为理解方面建立了可复现、可比较的实验范式,对第一视角视觉研究具有显著推动作用。
实际应用
在可穿戴感知与第一视角智能系统日益普及的背景下,EgoActionBench所构建的视频—动作—手别标注体系可直接服务于智能眼镜、辅助生活、技能教学与人机协作等实际场景。系统能够依据第一视角画面自动生成操作流程记录、检索特定手工步骤、监测左右手协同状态,并为机器人模仿学习提供细粒度行为演示解析。依托Ego4D、EgoLife与EPIC-KITCHENS-100等真实视频来源,该基准亦有助于评估模型在开放环境中对日常操作的理解稳健性,推动可穿戴计算从被动记录迈向主动语义理解。
数据集最近研究
最新研究方向
在第一人称视觉理解与具身智能交汇的前沿,EgoActionBench 将密集动作描述塑造为同时涵盖语义、时序与手别归因的细粒度评测任务。其近期研究聚焦于从自我中心视频中解析连续操作,要求模型回答相机佩戴者执行何种原子动作、动作发生于何时、由左手、右手或双手完成,并采用渐进式评估协议与 EgoActionScore 综合衡量语义保真、时序重叠以及精确率与召回率。基准收录 1407 段情节和 41132 条人工精炼标注,评估 20 个基线系统,并提出经监督微调与强化学习、适配 Qwen3-VL-4B 和 LLaVA-OneVision-2-8B 的 EgoAction。该方向呼应多模态大模型与视频稠密描述热点,为具身智能、辅助感知及人机协作提供可复现的评测基石,推动第一人称视频理解迈向细粒度、可解释的动作解析。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

