
ReactiveAI/long-retrieval
收藏官方服务:
资源简介:
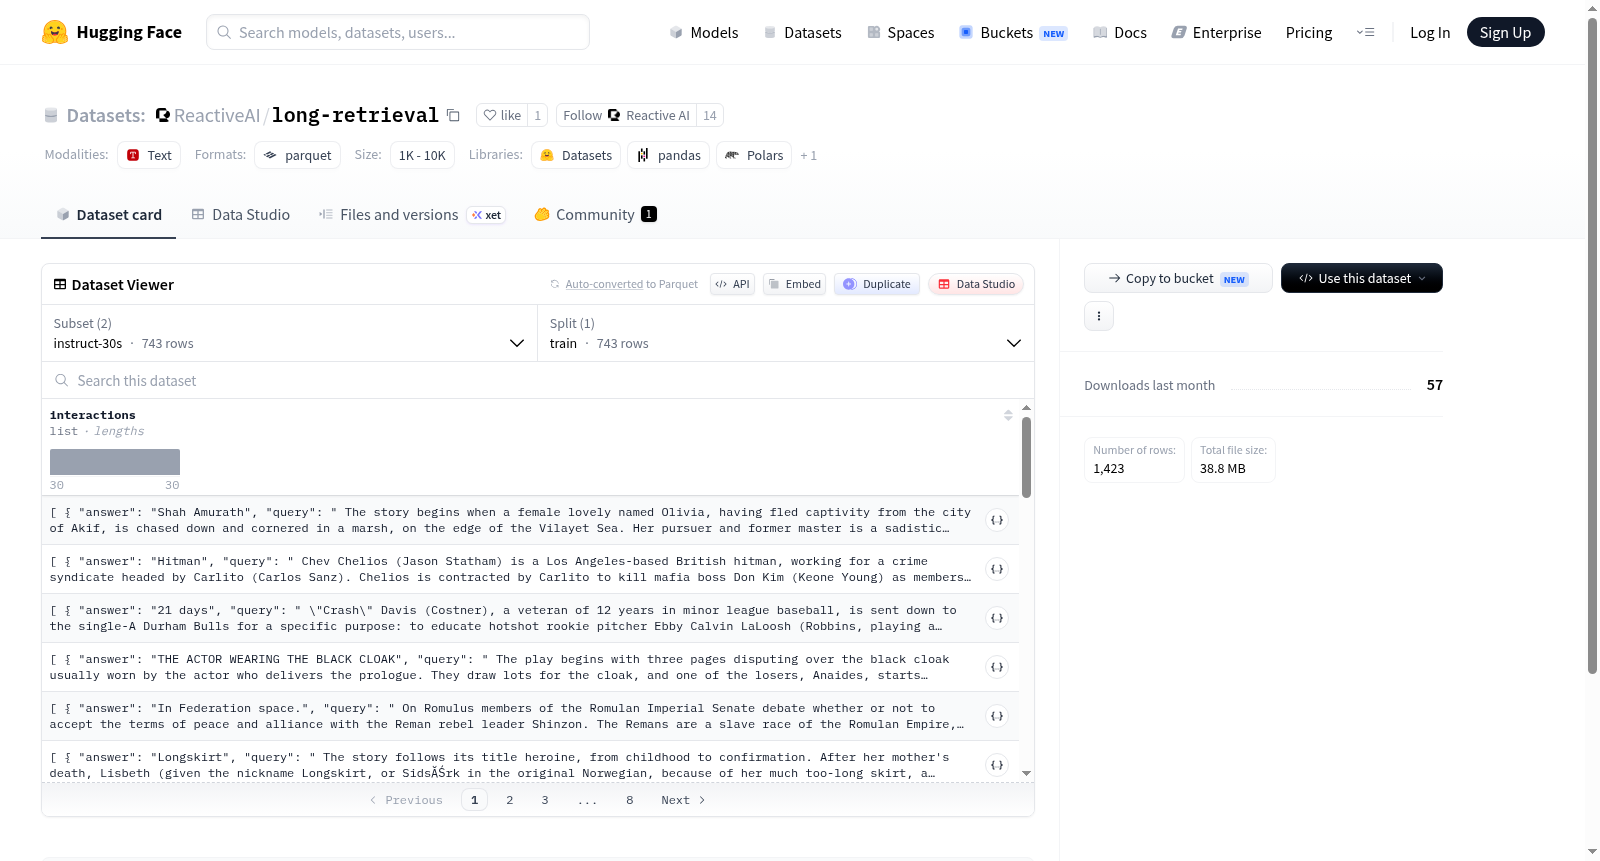
该数据集包含两个子集:instruct-30s 和 reasoning-30s。instruct-30s 子集用于指令遵循任务,包含743个训练示例,每个示例由查询(query)和回答(answer)组成。reasoning-30s 子集用于推理任务,包含680个训练示例,每个示例包括查询(query)、思考过程(think)和回答(answer)。数据集旨在支持自然语言处理中的指令理解和推理能力训练。
This dataset consists of two subsets: instruct-30s and reasoning-30s. The instruct-30s subset is designed for instruction-following tasks, containing 743 training examples, each composed of a query and an answer. The reasoning-30s subset is intended for reasoning tasks, with 680 training examples, each including a query, a thinking process, and an answer. The dataset aims to support training for instruction understanding and reasoning capabilities in natural language processing.
提供机构:
ReactiveAI搜集汇总
数据集介绍
构建方式
长文本检索任务在自然语言处理领域中占据着举足轻重的地位,而long-retrieval数据集正是为攻克长序列信息精准定位难题而精心构建的。该数据集包含两大类配置:instruct-30s与reasoning-30s。前者涵盖743条训练样本,每条样本由用户查询与对应答案构成,形成简洁的问答对结构;后者则包含680条训练样本,在查询与答案之间额外引入了思考过程字段,旨在模拟模型在检索时必须经历的推理链路。数据集的构建基于对长文本语料的深度挖掘,通过时间维度(30秒)进行切分,确保每次交互内容均具有明确的上下文边界。所有样本以parquet格式高效存储,并按照训练集统一划分,便于直接加载与使用。
使用方法
使用long-retrieval数据集时,研究者可根据任务目标灵活选择配置。对于纯检索精度测试,可直接加载instruct-30s配置,将query字段作为输入,answer字段作为监督信号,采用常规的编码器-解码器或双塔模型进行训练与评估。若希望同时训练模型的推理与检索能力,则推荐使用reasoning-30s配置,此时可设计分段式训练策略:先引导模型生成think字段中的推理内容,再基于推理结果输出最终答案。数据集统一以HuggingFace Datasets格式分发,通过load_dataset函数指定配置名称即可快速获取,支持批处理与动态填充,方便集成到现有的检索与问答训练流程中。
背景与挑战
背景概述
在长文本理解与检索领域,现有基准测试多聚焦于单词或短语级别的短距离依赖,难以有效评估模型在数分钟甚至更长时间跨度上的信息整合能力。long-retrieval数据集由研究人员于近年创建,旨在填补这一空白,其核心研究问题为:如何在长达30秒的连续对话或指令序列中精准定位并利用分散的关键信息。该数据集包含两个核心配置:instruct-30s侧重于指令跟随检索,而reasoning-30s则强调逻辑推理与信息重组。通过提供743条和680条高质量交互样本,该数据集为评估大型语言模型的长程记忆与上下文深度理解能力提供了标准化测试平台,对语音助手、长文档问答等时序性任务的研究具有重要推动价值。
当前挑战
该数据集所面临的挑战首先源于长距离依赖建模这一根本性领域难题:传统注意力机制的计算复杂度随序列长度平方增长,导致模型在30秒量级的上下文窗口中极易丢失早期关键信息。具体而言,在构建过程中,研究者需解决两个核心挑战:其一,确保交互序列在时间上自然连贯,避免人为切断逻辑链条,这要求数据标注员对30秒窗口内的信息层次有精确把握;其二,平衡查询问题的难度与歧义性,既要保证检索目标明确以避免误判,又要避免问题过于简单而无法有效区分模型能力。此外,数据集中query与answer的多轮、多实体关联特性,也要求模型具备跨越话语界限的实体链接与共指消解能力,这对现有架构提出了严峻考验。
常用场景
经典使用场景
在信息检索与自然语言处理领域,长文本检索一直是一项极具挑战性的任务。long-retrieval数据集专为评估和提升模型在长时间跨度对话或文档中的检索能力而设计,其经典使用场景聚焦于模拟真实世界中的长期交互检索。数据集包含两个核心配置:instruct-30s和reasoning-30s,分别对应指令跟随型和推理型检索任务。前者要求模型根据历史对话中的指令精准定位答案,后者则需模型在复杂上下文中进行逻辑推理以找到相关信息。通过提供长达30秒的交互片段,该数据集有效填补了现有基准在长程依赖建模方面的空白,为研究者提供了标准化测试平台。
解决学术问题
long-retrieval数据集主要解决了学术界长期存在的一个难题:如何量化与提升大语言模型在跨越多个交互轮次的长程信息检索能力。传统检索评测往往局限于单轮或短文本场景,难以揭示模型在积累大量上下文后的记忆衰退和注意力分散问题。该数据集通过构建连续30秒的密集交互序列,使研究者能够系统评估模型对早期信息的保持与追溯能力。这一设计推动了对于检索过程中的遗忘机制、上下文增强策略以及长程注意力优化等核心学术问题的深入探讨,为发展更具鲁棒性的检索模型奠定了数据基础,显著促进了长文本检索领域的理论进步。
实际应用
在实际应用中,long-retrieval数据集为构建可商用的智能对话系统提供了关键支撑。例如,在客服机器人场景中,用户可能经历长达数分钟的多轮沟通,系统需要从先前的对话中准确提取客户信息或需求细节。借助该数据集训练的模型,能够有效应对这种长程交互挑战,提升客户服务的一致性体验。同样,在智能助手如会议纪要生成或个人知识管理工具中,该数据集帮助模型实现对历史记录的高效检索与整合,从而在庞杂信息中快速定位有效内容,减少用户重复输入,极大提升了人机协作的效率与自然度。
数据集最近研究
最新研究方向
随着大语言模型在超长上下文处理能力上的突破性进展,long-retrieval数据集应运而生,聚焦于评测模型在30秒级时间跨度内的指令遵循与推理检索能力。该数据集通过精心设计的交互式问答和思维链推理两大部分,模拟现实场景中用户对长短期记忆的混合需求,为前沿的长期依赖理解、知识召回与逻辑推理研究提供了标准化测试基准。尤其在多轮对话、文档摘要及智能助手等热点应用中,该数据集的发布有力地推动了模型在复杂长文本环境中准确提取并整合信息的能力研究,对提升人工智能的持久记忆与上下文连贯性具有深远意义。
以上内容由遇见数据集搜集并总结生成


