遇见数据集

yasirchemmakh/CSL_dataset

收藏
Hugging Face2024-06-28 更新2024-06-29 收录
官方服务:

资源简介:

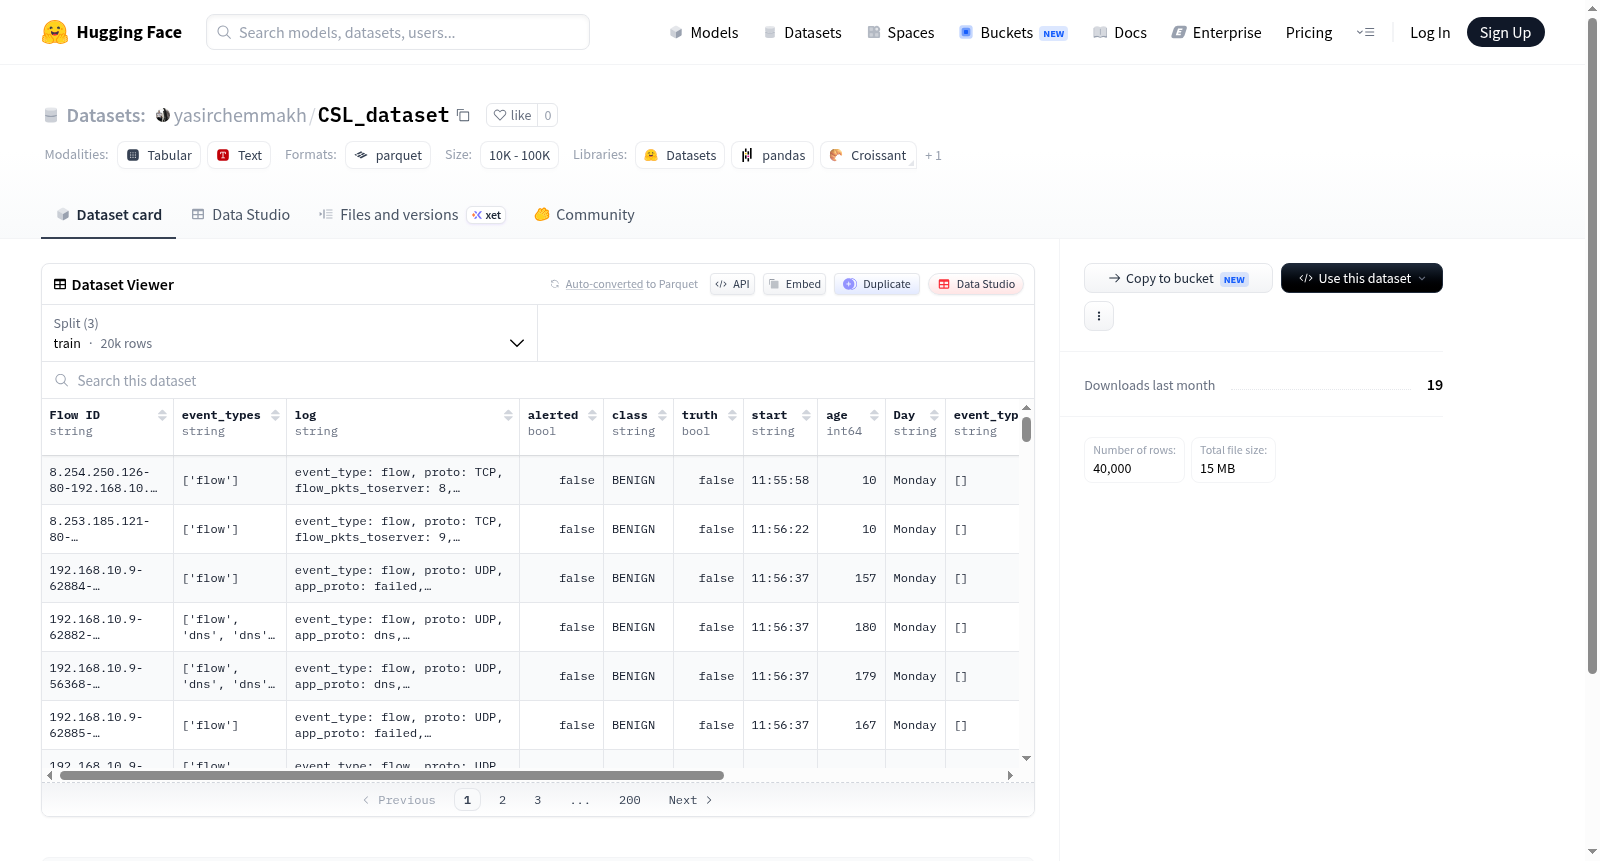
该数据集包含多个字段,如Flow ID、event_types、log、alerted、class、truth、start、age、Day、event_type_alert、num_tokens、label和__index_level_0__。这些字段涵盖了事件的ID、类型、日志信息、是否警报、分类、真实性、开始时间、年龄、日期、警报类型、令牌数量、标签和索引级别等信息。数据集被分为训练集、评估集和测试集,分别包含20000、10000和10000个示例。数据集的总大小为126173057字节,下载大小为14993308字节。

The dataset includes multiple fields such as Flow ID, event_types, log, alerted, class, truth, start, age, Day, event_type_alert, num_tokens, label, and __index_level_0__. These fields cover information such as event ID, types, log information, whether alerted, classification, truthfulness, start time, age, date, alert type, number of tokens, label, and index level. The dataset is divided into training, evaluation, and test sets, containing 20000, 10000, and 10000 examples respectively. The total size of the dataset is 126173057 bytes, with a download size of 14993308 bytes.

提供机构:
yasirchemmakh
原始信息汇总

数据集概述

数据集特征

  • Flow ID: 字符串类型
  • event_types: 字符串类型
  • log: 字符串类型
  • alerted: 布尔类型
  • class: 字符串类型
  • truth: 布尔类型
  • start: 字符串类型
  • age: 整数类型
  • Day: 字符串类型
  • event_type_alert: 字符串类型
  • num_tokens: 整数类型
  • label: 字符串类型
  • index_level_0: 整数类型

数据集分割

  • train:
    • 字节数: 100984320
    • 样本数: 20000
  • eval:
    • 字节数: 12477698
    • 样本数: 10000
  • test:
    • 字节数: 12711039
    • 样本数: 10000

数据集大小

  • 下载大小: 14993308 字节
  • 数据集总大小: 126173057 字节

配置

  • config_name: default
    • 数据文件路径:
      • train: data/train-*
      • eval: data/eval-*
      • test: data/test-*
搜集汇总
数据集介绍
yasirchemmakh/CSL_dataset 数据集图片
构建方式
在网络安全管理与异常检测的研究领域中,高质量标注数据集的构建是推动模型性能提升的关键基石。CSL_dataset由研究者yasirchemmakh精心构建,旨在为网络安全日志分析提供标准化训练与评估资源。该数据集整合了网络流日志记录,每条样本包含Flow ID、事件类型(event_types)、原始日志文本(log)及是否触发警报(alerted)等字段,并通过人工与规则结合的方式标注了真实标签(truth)与分类标签(label)。数据划分方面,共包含20,000条训练样本、10,000条评估样本与10,000条测试样本,形成均衡的三元组结构,便于进行模型训练、调优与性能验证。
特点
CSL_dataset展现出鲜明的领域适配性与结构化优势。其字段设计覆盖了网络安全分析的关键维度,如事件类型、警报状态及时间戳(start、Day),并引入了年龄(age)与令牌数量(num_tokens)等量化特征,为时序建模与文本特征提取提供了丰富素材。特别地,数据集包含布尔型字段alerted与truth,可支持二分类或多标签分类任务,而event_type_alert字段则进一步细化了警报事件类型。这些特点使得该数据集不仅适用于传统的机器学习模型,也能高效适配基于深度学习的序列分析与异常检测算法。
使用方法
本数据集可通过HuggingFace Datasets库便捷加载,默认配置下使用data/train-*、data/eval-*与data/test-*路径分别读取训练、评估与测试分片。用户可直接调用load_dataset('yasirchemmakh/CSL_dataset')获取完整数据,并利用pandas或transformers库进行预处理。建议在实验中将Flow ID作为唯一标识符,将log字段作为文本输入,结合label或truth作为监督信号,构建分类或异常检测模型。此外,可基于event_types与event_type_alert字段进行细粒度事件分析,或利用age与num_tokens进行特征工程,以提升模型在真实网络环境下的鲁棒性。
背景与挑战
背景概述
在网络安全领域,攻击检测与威胁分析一直是研究的热点与难点。随着网络流量的激增与攻击手段的日益复杂,传统的基于规则或签名的检测方法逐渐暴露出适应性不足的问题。在此背景下,由研究者Yasir Chemmakh等人构建的CSL_dataset应运而生,该数据集专注于日志驱动的网络安全事件分析,旨在为基于机器学习的入侵检测系统提供高质量的标注数据。数据集创建于近年,其核心研究问题聚焦于如何通过异构日志数据(如事件类型、流标识与时间戳)有效区分正常行为与恶意攻击。通过提供包含40000条样本的训练、评估与测试划分,该数据集为后续研究提供了标准化的基准,推动了日志分析与异常检测领域的实证进展。
当前挑战
CSL_dataset所面临的挑战首先体现在领域问题的复杂性上:真实网络环境中攻击模式瞬息万变,而现有数据集多依赖静态标签,难以覆盖零日攻击或高度隐蔽的持续性威胁,导致模型泛化能力受限。此外,构建过程中遇到的数据不平衡问题尤为突出——日志中正常事件远多于攻击事件,这可能导致分类器偏向多数类。同时,日志数据的高维特征与噪声(如冗余流标识与缺失值)增加了特征工程的难度,而时间序列依赖性的引入又要求模型具备捕捉长程上下文的能力。这些挑战共同制约着数据集的效能上限,亟需更精细的数据增强策略与鲁棒的学习算法来应对。
常用场景
经典使用场景
CSL_dataset作为面向网络安全日志分析的高质量标注数据集,其最经典的使用场景在于构建和评估基于机器学习的入侵检测系统(IDS)。研究人员通常利用该数据集中的网络流日志(log字段)与事件类型(event_types字段)作为输入特征,以alerted和truth字段提供的真实标签为监督信号,训练分类模型以区分正常流量与恶意攻击行为。该数据集包含四万条精心标注的样本,划分为训练集、验证集与测试集,为模型性能的公平比较提供了标准化基准,尤其适用于序列日志建模与异常检测算法的验证。
衍生相关工作
基于CSL_dataset的发布,衍生出多项具有影响力的学术工作。例如,研究者提出了融合时间注意力机制的日志异常检测框架,利用该数据集的时序特征提升对慢速攻击的捕获率;另有工作探索了基于对比学习的半监督模型,在仅利用少量标注样本的条件下达到全监督方法的性能。此外,该数据集还被用于验证联邦学习架构下跨组织协作的隐私保护入侵检测方案,以及生成对抗网络(GAN)在合成恶意日志增强方面的有效性,持续拓展网络安全智能化的研究边界。
数据集最近研究
最新研究方向
该数据集聚焦于网络安全领域的入侵检测与日志分析,其结构化的流数据(Flow ID)、事件类型和警报标签为构建异常检测模型提供了坚实基础。当前前沿研究围绕利用深度学习与图神经网络对网络流量进行实时威胁识别,尤其关注零日攻击与高级持续性威胁(APT)的捕捉。在勒索软件事件频发、供应链攻击激增的背景下,该数据集支持从海量日志中挖掘隐蔽攻击模式,推动可解释人工智能在安全运营中的应用。其多标签分类设计助力模型区分误报与真实威胁,对提升企业安全态势感知能力具有显著意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务