
fuyu-quant/ibl-regression-ver4-branch-pred
收藏官方服务:
资源简介:
--- dataset_info: features: - name: prediction dtype: string - name: 'true' dtype: string - name: index dtype: int64 splits: - name: pred num_bytes: 227616 num_examples: 1000 download_size: 57462 dataset_size: 227616 configs: - config_name: default data_files: - split: pred path: data/pred-* ---
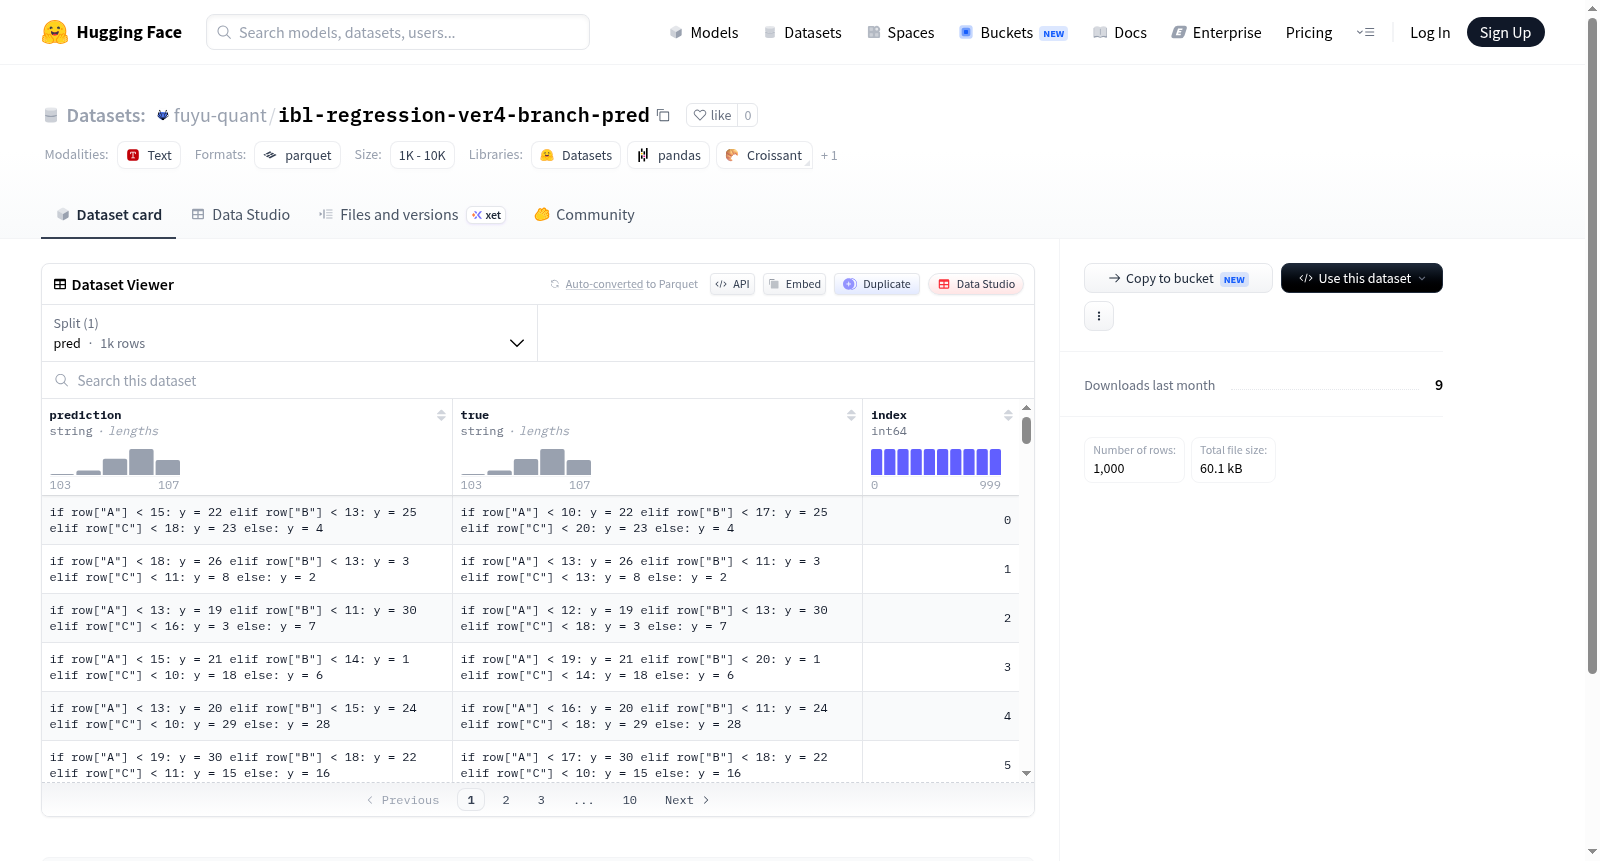
数据集信息: 特征字段: - 字段名:预测结果(prediction),数据类型:字符串 - 字段名:真实标签(true),数据类型:字符串 - 字段名:索引(index),数据类型:64位整型 数据拆分: - 拆分名称:pred,占用字节数:227616,样本数量:1000 下载大小:57462 数据集总大小:227616 配置项: - 配置名称:default,数据文件: - 拆分:pred,路径:data/pred-*
提供机构:
fuyu-quant原始信息汇总
数据集概述
数据特征
- prediction: 数据类型为字符串(string)
- true: 数据类型为字符串(string)
- index: 数据类型为整数(int64)
数据分割
- pred: 包含1000个样本,总字节数为227616字节
数据集大小
- 下载大小: 57462字节
- 数据集大小: 227616字节
配置
- default:
- 数据文件路径:
data/pred-*
- 数据文件路径:
搜集汇总
数据集介绍
构建方式
该数据集名为fuyu-quant/ibl-regression-ver4-branch-pred,源于对回归预测任务的深入探索,旨在为分支预测模型提供标准化的评估基准。数据集采用结构化存储方式,包含预测值、真实值和索引三个字段,其中预测值与真实值均为字符串类型,索引为整型。构建时通过划分单一预测集(pred split)形成1000个样本,总数据量约227KB,确保了数据集的轻量化和易用性。
特点
数据集的核心特点在于其聚焦于回归问题的分支预测场景,以简洁的三列结构(prediction、true、index)呈现,便于快速加载与比对。所有样本集中于一个预测分片,避免了复杂的交叉验证拆分,适合直接用于模型输出的验证与误差分析。此外,字符串类型的预测与真实值设计,为处理非数值型或编码后的回归目标提供了灵活性,兼顾了通用性与可扩展性。
使用方法
使用该数据集时,可通过HuggingFace Datasets库直接加载默认配置,读取pred分片中的数据。用户需将字符串类型的prediction和true字段转换为适合回归分析的数值格式,例如通过映射或解析函数进行类型转换。随后可利用index字段进行样本索引,结合真实值计算模型预测的均方误差或绝对误差等指标,从而评估分支预测性能。
背景与挑战
背景概述
在机器学习的实证研究中,模型预测与真实标签的比对是评估算法性能的核心环节,尤其是在回归任务中,精准的误差分析对模型优化至关重要。fuyu-quant/ibl-regression-ver4-branch-pred数据集由相关研究机构于近期创建,聚焦于回归问题的预测结果验证,其核心研究问题在于提供标准化的预测-真值对照数据,以支持分支预测模型在特定场景下的性能评估。该数据集包含1000个样本,通过结构化存储预测值、真实值及索引信息,为后续的误差统计、偏差分析及模型校准提供了可靠基准,对推动量化回归模型的鲁棒性研究具有潜在影响力。
当前挑战
该数据集所面临的挑战首先体现在领域问题层面:回归任务中预测偏差的量化分析需应对噪声干扰与分布偏移,而当前数据集样本量有限,难以全面覆盖复杂场景下的误差模式,可能影响模型泛化能力的评估。在构建过程中,挑战则集中于数据标注的精确性与一致性,由于回归任务中真实值往往依赖高精度测量或专家标注,任何微小误差均会扭曲后续分析结论。此外,数据集的存储格式虽简洁,但缺乏对特征空间与数据来源的详细描述,限制了跨场景复用的可解释性,为深入诊断模型行为设置了障碍。
常用场景
经典使用场景
该数据集fuyu-quant/ibl-regression-ver4-branch-pred在行为神经科学领域具有广泛应用,特别是在处理国际脑实验室(IBL)的标准化行为任务数据时。其经典使用场景聚焦于基于前序试验特征对小鼠在决策任务中的分支选择进行回归预测。研究人员利用该数据集中的预测值与真实标签,可构建并验证多种回归模型,从而量化动物在不确定环境下的选择偏好与学习动态。数据集包含1000个样本,结构简洁,便于快速迭代模型,是探索条件性行为预测与神经活动关联的理想基准。
实际应用
在实际应用层面,该数据集可直接服务于神经科学实验的闭环控制与实时行为干预。例如,在光遗传学或钙成像实验中,研究者可基于预测模型动态调整刺激参数,以验证因果假设。此外,其简洁的格式便于集成到强化学习框架中,模拟动物在经典两臂赌博任务中的策略演化。在药物筛选或神经疾病模型评估中,该数据集可作为基准,量化不同处理组在决策一致性上的偏离,从而加速从实验室到临床的行为表型筛查效率。
衍生相关工作
该数据集衍生了一系列经典工作,主要集中在行为预测模型的对比与可解释性分析。例如,研究者将其与IBL公开的神经活动记录结合,构建了从前额叶皮层到纹状体的决策环路计算模型。另一方向是利用该数据集验证贝叶斯非参数方法与深度时序网络(如LSTM)在预测分支选择上的优劣。此外,相关研究还探索了预测误差信号与多巴胺能突触可塑性的映射关系,推动了‘强化学习作为行为理论’这一学术框架的实证发展。这些工作共同树立了行为回归任务的标准评估范式。
以上内容由遇见数据集搜集并总结生成


